
14 · 基础能力篇
读取 PDF 和长文档:从全文理解到要点提取
第 14 / 56 篇约 1 分钟完整版内容
长文档处理的难点不在摘要长度,而在有没有读全、页码是否对应、表格和脚注是否遗漏、结论能不能回到原文。
本篇内容先判断文档类型分三轮处理长文档可复制指令验收标准
长文档处理的难点不在摘要长度,而在有没有读全、页码是否对应、表格和脚注是否遗漏、结论能不能回到原文。
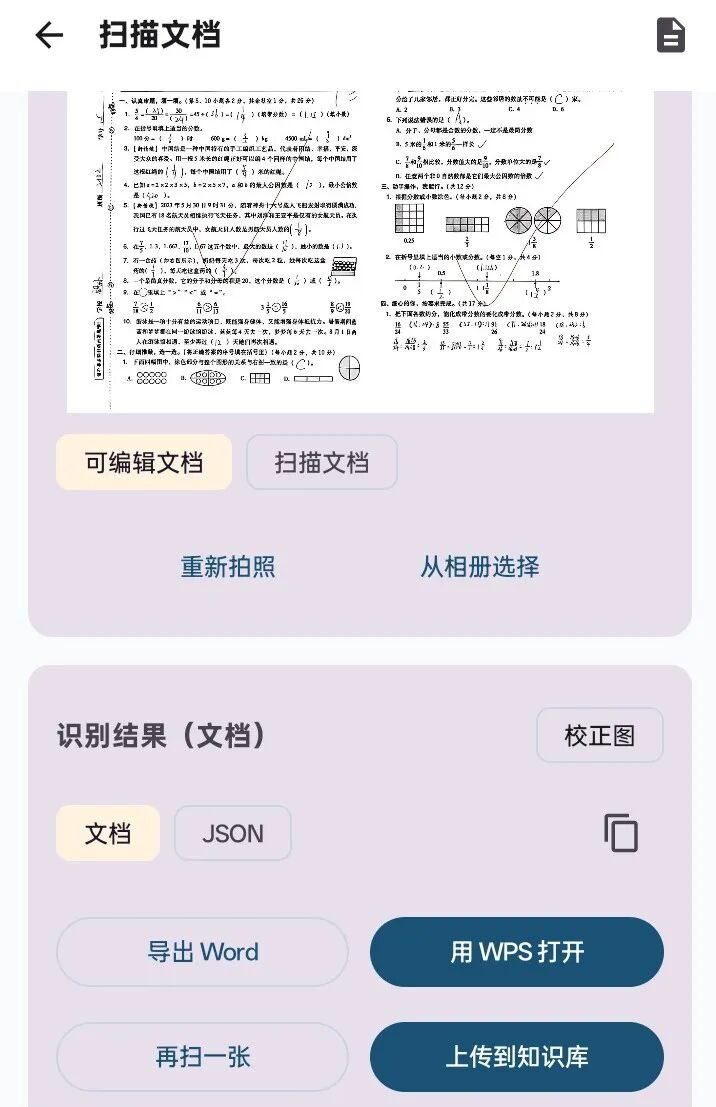
图:资料中的图片与文档处理示例。
先判断文档类型
- 可搜索 PDF:通常能直接提取文字。
- 扫描 PDF:需要 OCR,表格和页码更容易错。
- 混合 PDF:正文可提取,部分页面是图片。
- 加密或损坏文件:可能需要密码、转换或人工处理。
让千问办公先报告页数、可提取文字的页面、疑似扫描页和无法读取部分。没有完成这一步,不能声称“已经阅读全文”。
分三轮处理长文档
第一轮做目录级理解:章节、页码、主题和文档目的。第二轮按问题定位证据:关键结论、数字、表格和原句。第三轮交叉检查:不同章节是否冲突、数据口径是否一致、是否存在限定条件。
可复制指令
请完整读取[文件名]。先报告总页数、目录结构、可正常读取页面、疑似扫描页面和无法读取内容。
然后按“章节摘要、关键结论、重要数字、原文页码、限制条件、待核实项”整理。
所有重要结论都附页码;表格单独提取;无法确认的内容不要猜。
最后回答:[你的三个具体问题]。
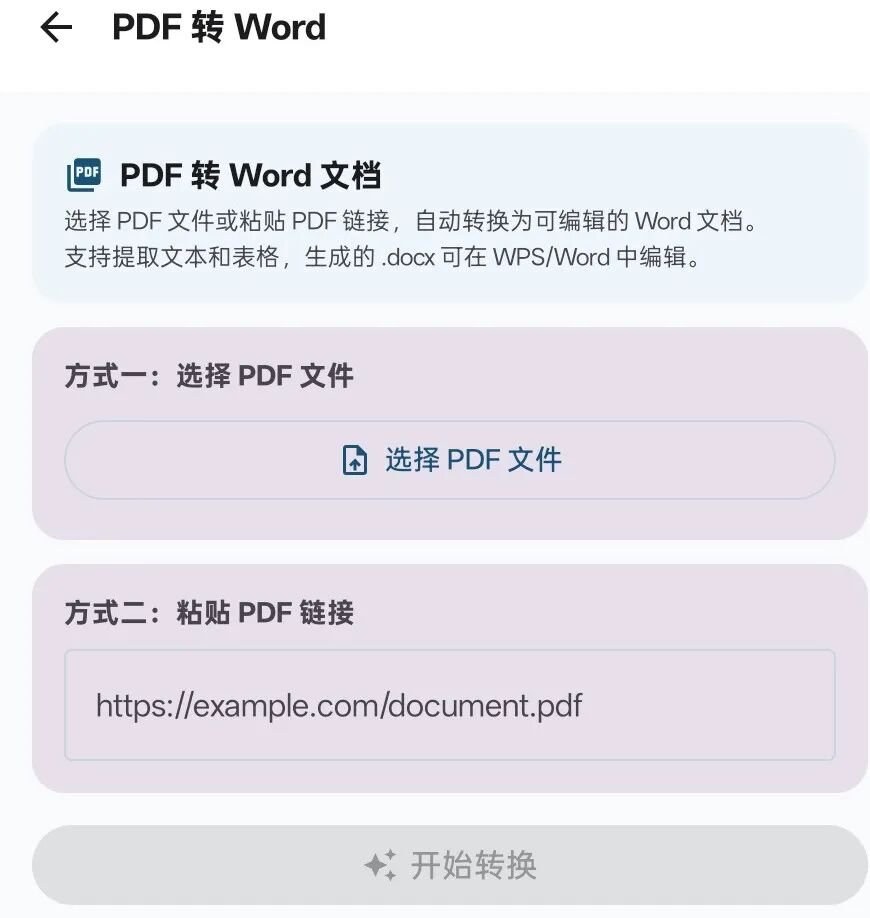
图:资料中的文档提取结果。
验收标准
抽查开头、中间和结尾至少三处;随机核对三个数字与页码;检查摘要是否漏掉反例和限制条件。扫描件还要人工核对关键表格与专有名词。
AI 办公产品教程 · 完整版