
第 09 章 · AI 学习
让AI读懂长文档和大量资料
你的电脑里有三份制度、两份合同、四份行业报告和一叠会议记录。领导问:“这几份材料到底有什么差别?哪些条款会影响我们下个月的执行?”
很多人会把文件全部上传,然后输入一句:“请帮我总结。”AI很快返回十个要点。可当你追问某条结论在哪一页、哪份文件采用了不同口径、哪项内容其实没有写,结果往往开始摇摆。
长文档任务的目标不是得到一段更短的文字。目标是从一组材料中提取指定信息、比较差异,并让重要结论可以回到原文。
一、本章学完,你能做到什么
你将能够:
- 在阅读前先定义提取字段;
- 判断文件是否被完整、正确地读取;
- 分批处理长文档并保留文件编号;
- 比较多份材料的一致项、差异项和缺失项;
- 为结论保留页码、章节、段落或原句;
- 区分摘要、推断和原文事实。
最终成果是一张“可追溯资料提取表”,附带冲突清单和待确认项。
二、先决定要提取什么
阅读任务经常失败,是因为用户只说“总结一下”。AI只能自行选择它认为重要的内容。它选择的重点未必符合你的工作。
例如比较三份培训管理制度,人力资源同事真正关心的字段可能是:
| 字段 | 为什么需要 |
|---|---|
| 适用对象 | 判断覆盖哪些员工 |
| 培训类型 | 区分入职、岗位和专项培训 |
| 申请流程 | 确定谁发起、谁审批 |
| 费用规则 | 判断预算和报销条件 |
| 服务期 | 识别员工义务与风险 |
| 记录要求 | 确定留存什么证据 |
| 例外情况 | 处理特殊人员和特殊培训 |
| 生效日期 | 判断当前采用哪个版本 |
先有字段,AI才知道阅读时找什么、什么叫遗漏。
三、先做“读取体检”
上传成功不等于内容读取成功。开始提取前,先要求AI返回:
- 识别到多少份文件;
- 每份文件的名称、页数或主要章节;
- 哪些页面没有文字、可能是扫描件;
- 哪些表格、批注、脚注或附件可能无法可靠读取;
- 是否存在重复文件、旧版本或文件名冲突。
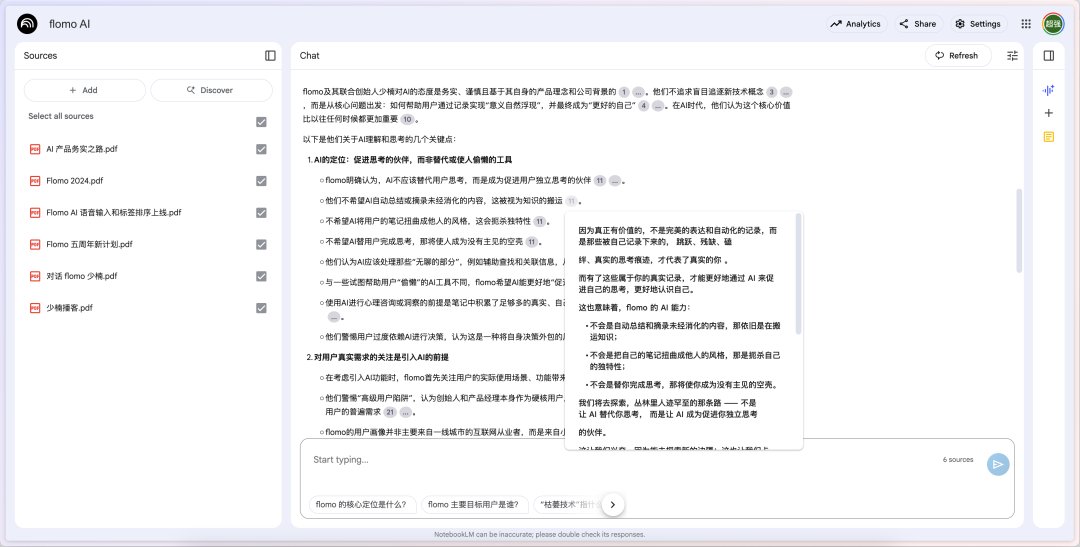
图:原文在介绍将六份同主题PDF上传后开展提问时使用的配图。这里用于说明多文档阅读应先确认资料范围;画面内容与授权待人工确认。
扫描PDF、复杂表格和图片型附件可能需要专门识别工具。关键条款不能因为AI说“已阅读”就默认完整。
四、六步多文档阅读法
第一步:给文件编号
D01_总部培训管理制度_2026-01
D02_华东分公司培训细则_2026-03
D03_旧版培训管理办法_2023-06
编号帮助你在提问、提取和复核时定位材料,也防止“制度”“新版制度”这类模糊称呼混在一起。
第二步:建立提取表
让AI先输出空表,字段由你确认。每一格至少包含“提取内容”和“原文位置”。没有找到时写“原文未发现”,不能凭常识补齐。
第三步:先逐份提取,再横向比较
直接要求AI同时比较十份文件,容易遗漏。先让它分别完成D01、D02、D03的提取,再合并成对比表。
逐份提取时问:
- 这份文件明确写了什么?
- 哪些字段没有写?
- 哪些表述可能有歧义?
- 哪些地方引用了附件或其他制度?
- 每项结论对应什么位置?
第四步:按字段比较
比较时分成四类:
- 一致:多份材料含义相同;
- 差异:规则、数字或范围不同;
- 缺失:某份材料没有规定;
- 冲突:两份都声称适用,却给出不能同时执行的要求。
“没有写”和“规定为没有”含义完全不同。AI常会把缺失解释为否定,人工要专门检查。
第五步:回到原文核对
优先核对:
- 金额、比例、期限和日期;
- 责任主体和审批关系;
- “应当、可以、不得”等强度不同的词;
- 例外、附件和脚注;
- AI概括后明显变得更强或更弱的结论。
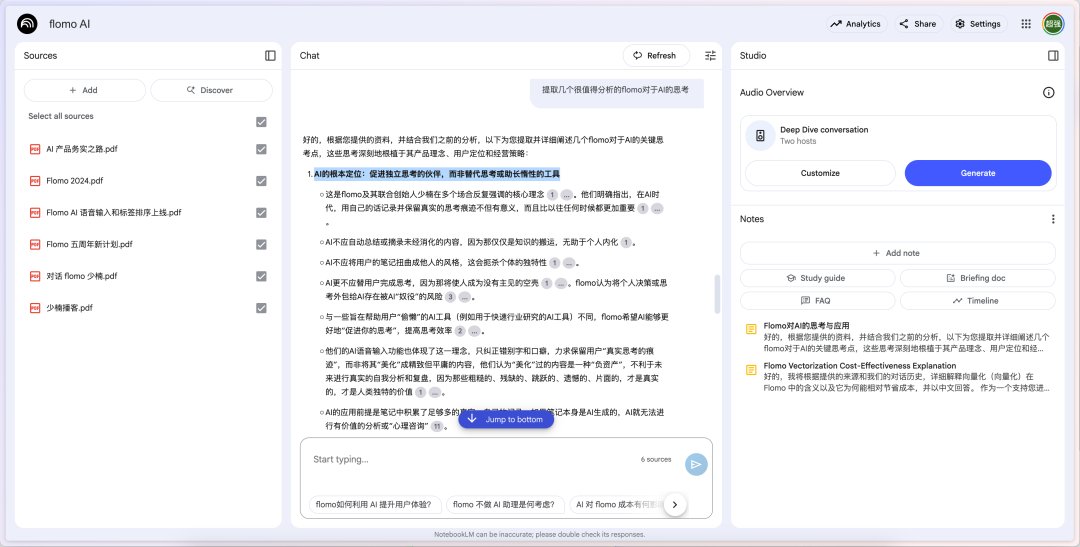
图:原文在多份资料上传后展示基于指定问题提取与分析的配图。这里对应“围绕提取字段追问并回到引用位置”;画面内容与授权待人工确认。
第六步:输出冲突和待确认清单
AI可以帮助定位冲突,不能替责任人裁定哪份规则生效。最终清单至少写:
冲突内容:
涉及文件与位置:
可能原因:版本/范围/口径/确有矛盾
当前处理:
需要谁确认:
确认期限:
五、完整案例:比较三份培训制度
1. 原始任务
集团准备统一新员工培训。人力资源专员需要比较总部制度、分公司细则和旧版办法,找出下月执行前必须确认的差异。
2. 第一次做法的问题
AI将三份文件总结成“培训需申请、审批、记录和评估”。这段话没有错,却不能支持执行:谁申请、谁审批、费用上限、记录保存多久都没有说清。
3. 建立字段和逐份提取
专员建立八个字段,并要求每项附文件编号和位置。AI在D02中没有找到服务期规定,填写“未发现”;没有将D01的规则自动套到D02。
4. 比较后发现三类问题
- D01与D02对外部培训的审批层级不同;
- D03使用旧部门名称,可能已经失效;
- D02没有说明培训记录保存期限。
5. 人工判断
人力资源负责人确认D01是集团现行上位制度,D02只在不冲突时补充分公司流程;D03退出材料包。记录保存期限由合规负责人补充确认。
6. 最终交付
最终成果包含对比表、三项差异、一个缺失项、文件适用关系和待确认负责人。任何同事都能从表格跳回原文复核。
六、摘要不能替代原文
摘要适合:
- 快速了解主题;
- 决定哪些章节值得精读;
- 建立初步目录;
- 为会议准备问题。
原文必须保留在以下场景:
- 正式制度和合同解释;
- 法律、财务和人力资源决定;
- 对外承诺;
- 关键数字和研究结论;
- 需要准确引用的内容。
摘要会压缩限定词和例外。只看摘要,很容易把“特定条件下可以”写成“普遍可以”。
七、在NotebookLM、Claude、Kimi、WorkBuddy中怎样做
适合资料型任务的产品通常支持上传文件、建立独立项目、基于资料问答或返回引用。界面会变化,方法保持不变:
- 一个主题建立一个项目或笔记本;
- 上传前完成编号、版本和权限检查;
- 先做读取体检;
- 创建固定提取表;
- 逐份提取后再比较;
- 关键回答要求引用文件与位置;
- 最终结果保留到独立文档,不只留在聊天中。
图:原文在说明不同研究主题可以分别建立笔记本时使用的配图。这里对应资料范围隔离和独立项目管理;画面内容与授权待人工确认。
八、可复制的多文档提取模板
任务:比较我提供的多份文件。

第一步先返回:
- 文件清单、编号和识别到的结构;
- 无法可靠读取的页面或内容;
- 可能重复、过期或范围不同的文件。

确认后,按以下字段逐份提取:
[字段1、字段2、字段3……]

规则:
1. 每一项写明文件编号与页码/章节/原文片段;
2. 找不到时写“原文未发现”;
3. 不使用其他文件或常识替它补全;
4. 分开标记原文事实、你的概括和你的推断;
5. 最后输出一致项、差异项、缺失项、冲突项和待确认项。
九、常见错误与边界
- 文件一多就直接总结,未先定义字段;
- 没有检查扫描页、附件和复杂表格;
- 将旧版本和现行版本一起使用;
- 用另一份文件补齐当前文件的缺失;
- 只保留摘要,丢失引用位置;
- 把AI推断写成原文结论;
- 上传无权处理的合同、个人信息或商业秘密。
十、练习:比较三份真实材料
选择三份同类型、可安全处理的制度、报告或方案:
- 编号并标记版本;
- 设计至少六个提取字段;
- 逐份完成提取;
- 找出至少两项差异和一项缺失;
- 将三条关键结论回到原文核对;
- 建立待确认清单。
十一、怎样判断自己真的学会了
- 表格每一项都来自指定文件;
- 关键内容有页码、章节或原句;
- 缺失、差异和冲突已经分开;
- AI概括与原文事实能够区分;
- 重要规则经过人工核对;
- 一名同事可以沿引用独立复查。
本章小结
多文档阅读的主线是:
定字段 → 查读取 → 逐份提取 → 横向比较 → 回到原文 → 处理冲突
下一章,我们将提取出来的事实变成清楚、得体、能够直接使用的文字。