
49 · 金融场景
从一张 K 线图开始,完成一场有证据的投研评审会
一张 K 线图很容易让人产生判断。趋势向上、放量突破、回撤企稳……这些词写起来很快,却可能已经越过了图片本身能证明的范围。
一张 K 线图很容易让人产生判断。趋势向上、放量突破、回撤企稳……这些词写起来很快,却可能已经越过了图片本身能证明的范围。
当时正好赶上春节前最后一波密集发布期,各家模型齐登场,Seedance 2.0 视频模型也上线,整个 AI 圈热闹得不行。
我当时的第一反应是:这个必须测。
然后.. 就没有然后了。
年前忙着收尾,年后又接连在玩 OpenClaw,豆包 2.0 的评测就一直排在待办清单里吃灰。直到这周末,我终于腾出一整块时间,把豆包2.0 从头到尾认认真真跑了一遍。
测下来,还真有惊喜。
先给大家看个效果:

看完这个,你大概就明白我为什么觉得这个模型值得单独写一篇了。
简单说说测下来的体感:
1、多模态理解和 Agent 调度能力,比上一代强了很多,尤其是视觉理解,之后在做质检等场景的时候优势比较大
2、推理效率提升很明显,Token 用得更少,响应更快
3、在企业级应用场景里,整体能力算是实现了一次升级,几个线上在跑的生产场景任务已经完成了从1.8到2.0的切换。
好了,先不看官方说法,不堆参数,不看比分。
我们直接上实战,边看边聊。
Case 1:多图表数据分析
第一个场景,我想测的是豆包 2.0 的多模态图表理解 能力。
怎么测?不搞简单的看图说话。直接上强度。
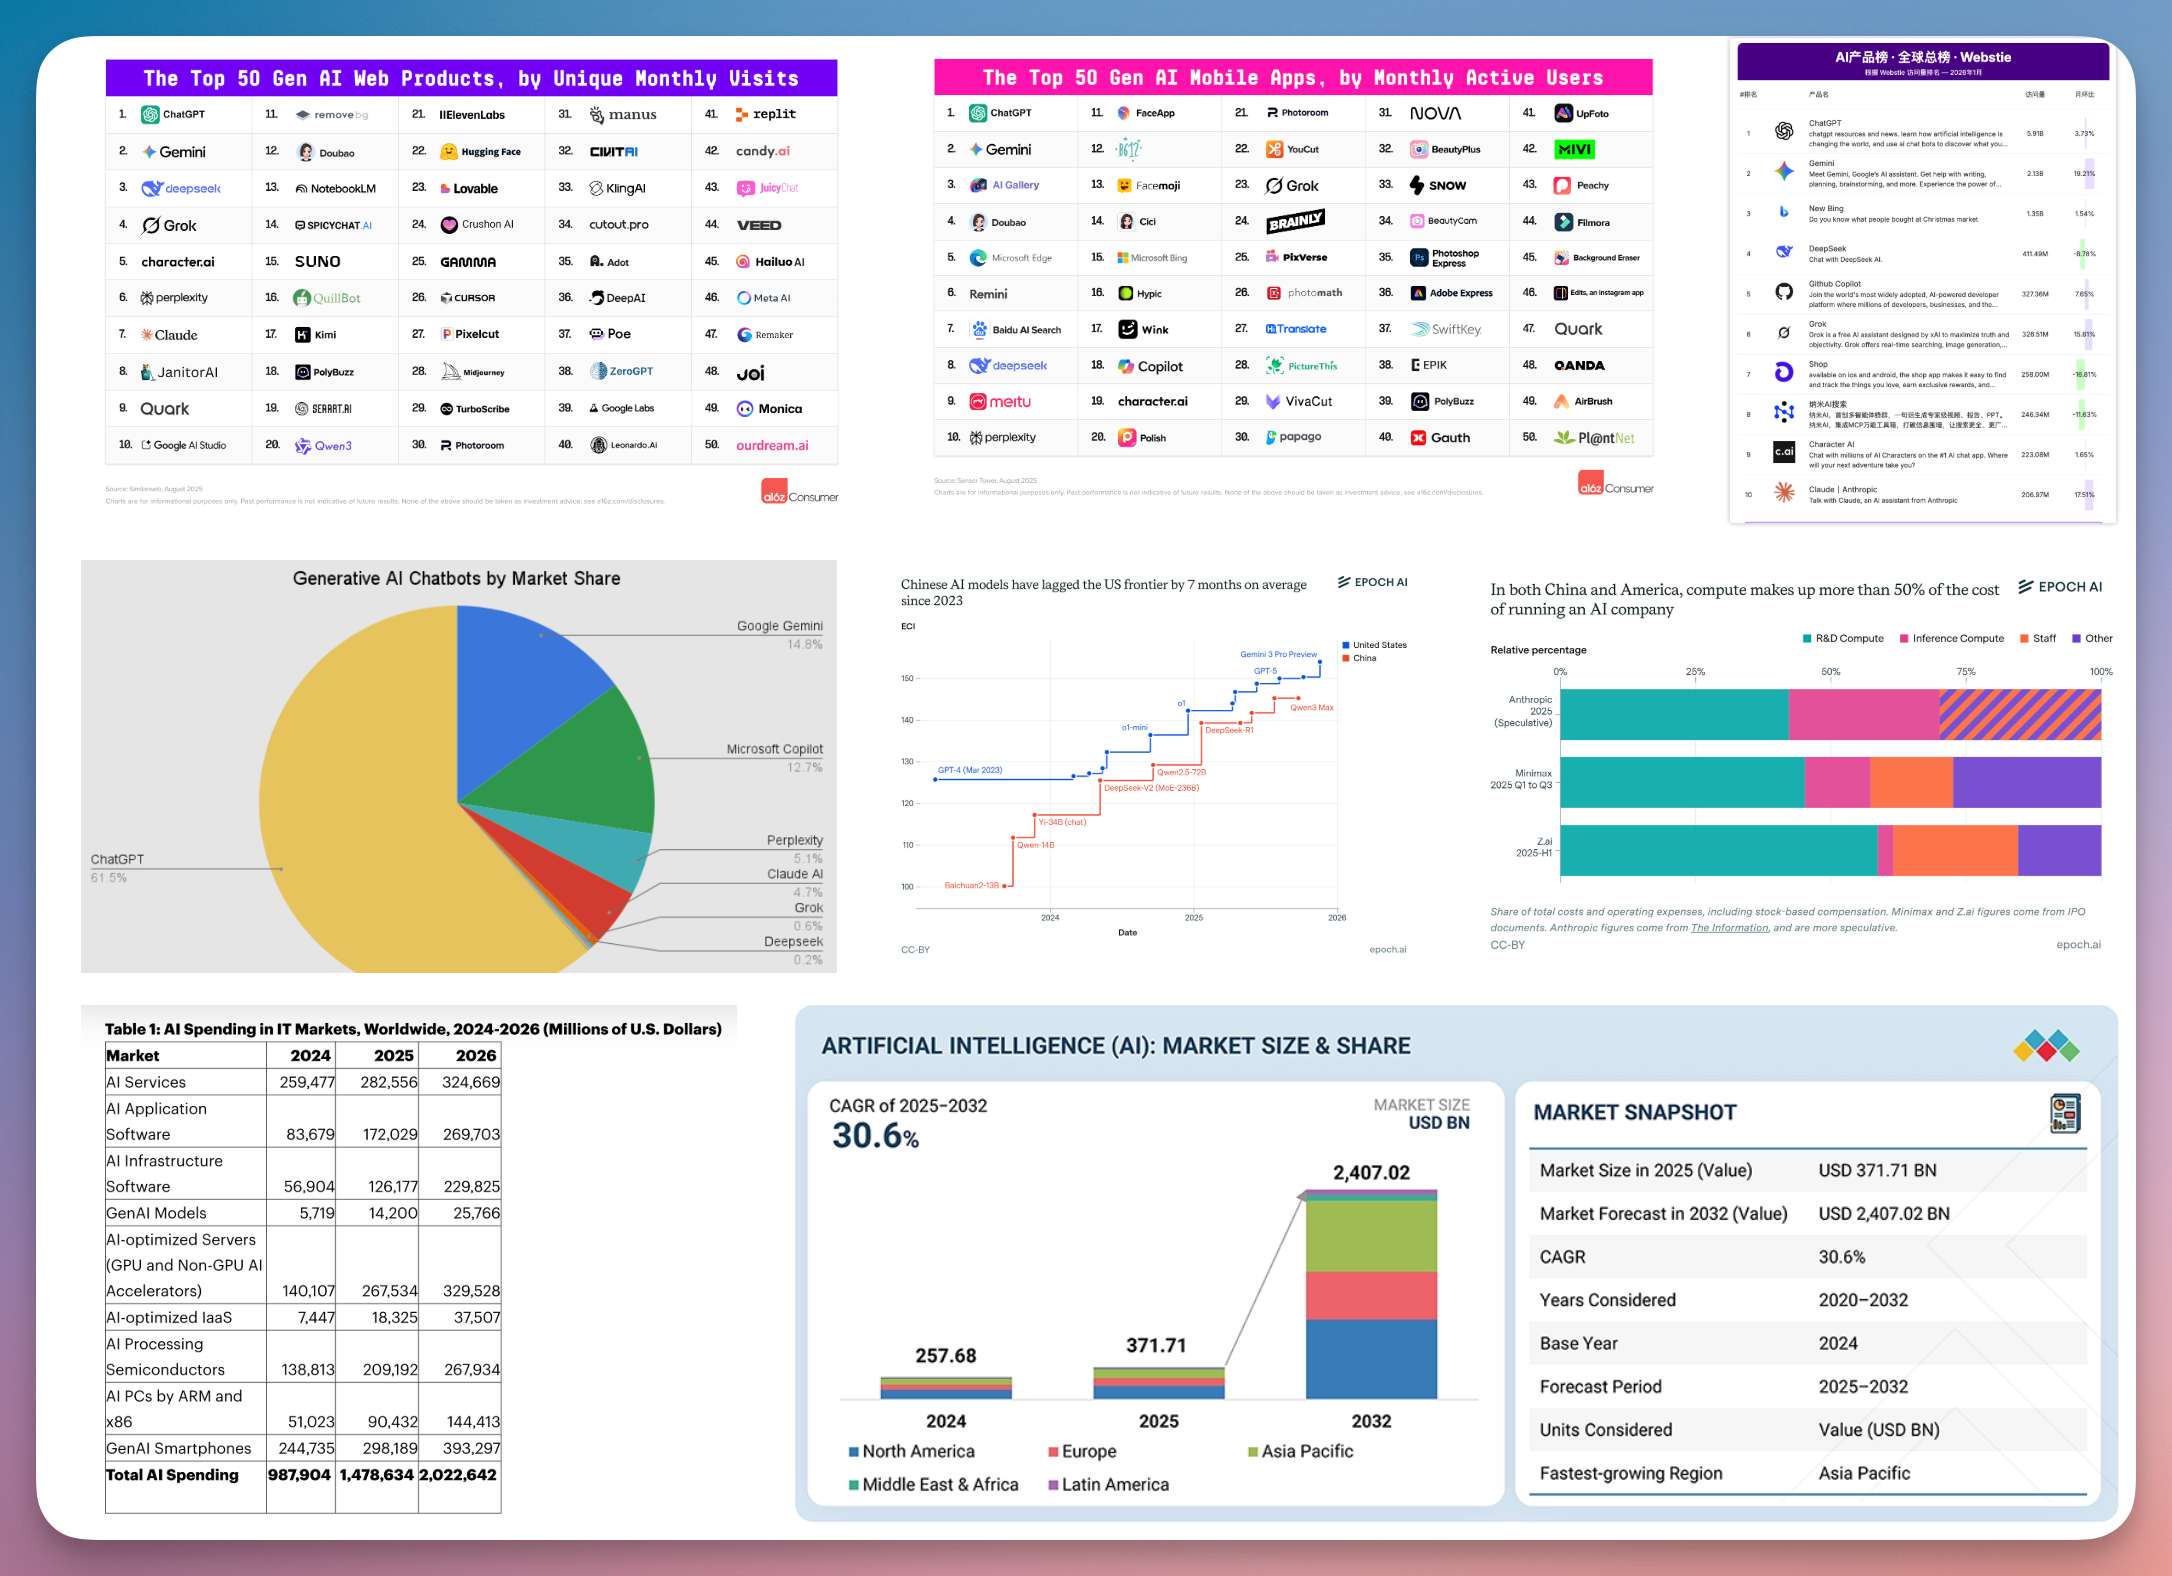
我从不同渠道找了 8 张 AI 行业数据截图。白皮书里的柱状图、新闻报道的折线图、Excel 表格、数据平台的仪表盘..
来源不同,统计口径不同,图表格式也完全不同。
因为豆包App也在第一时间上线了 Seed-2.0-Pro 模型,而且还支持「专家」模式,就直接在豆包里面测了,方便大家看,选用 Web 端,
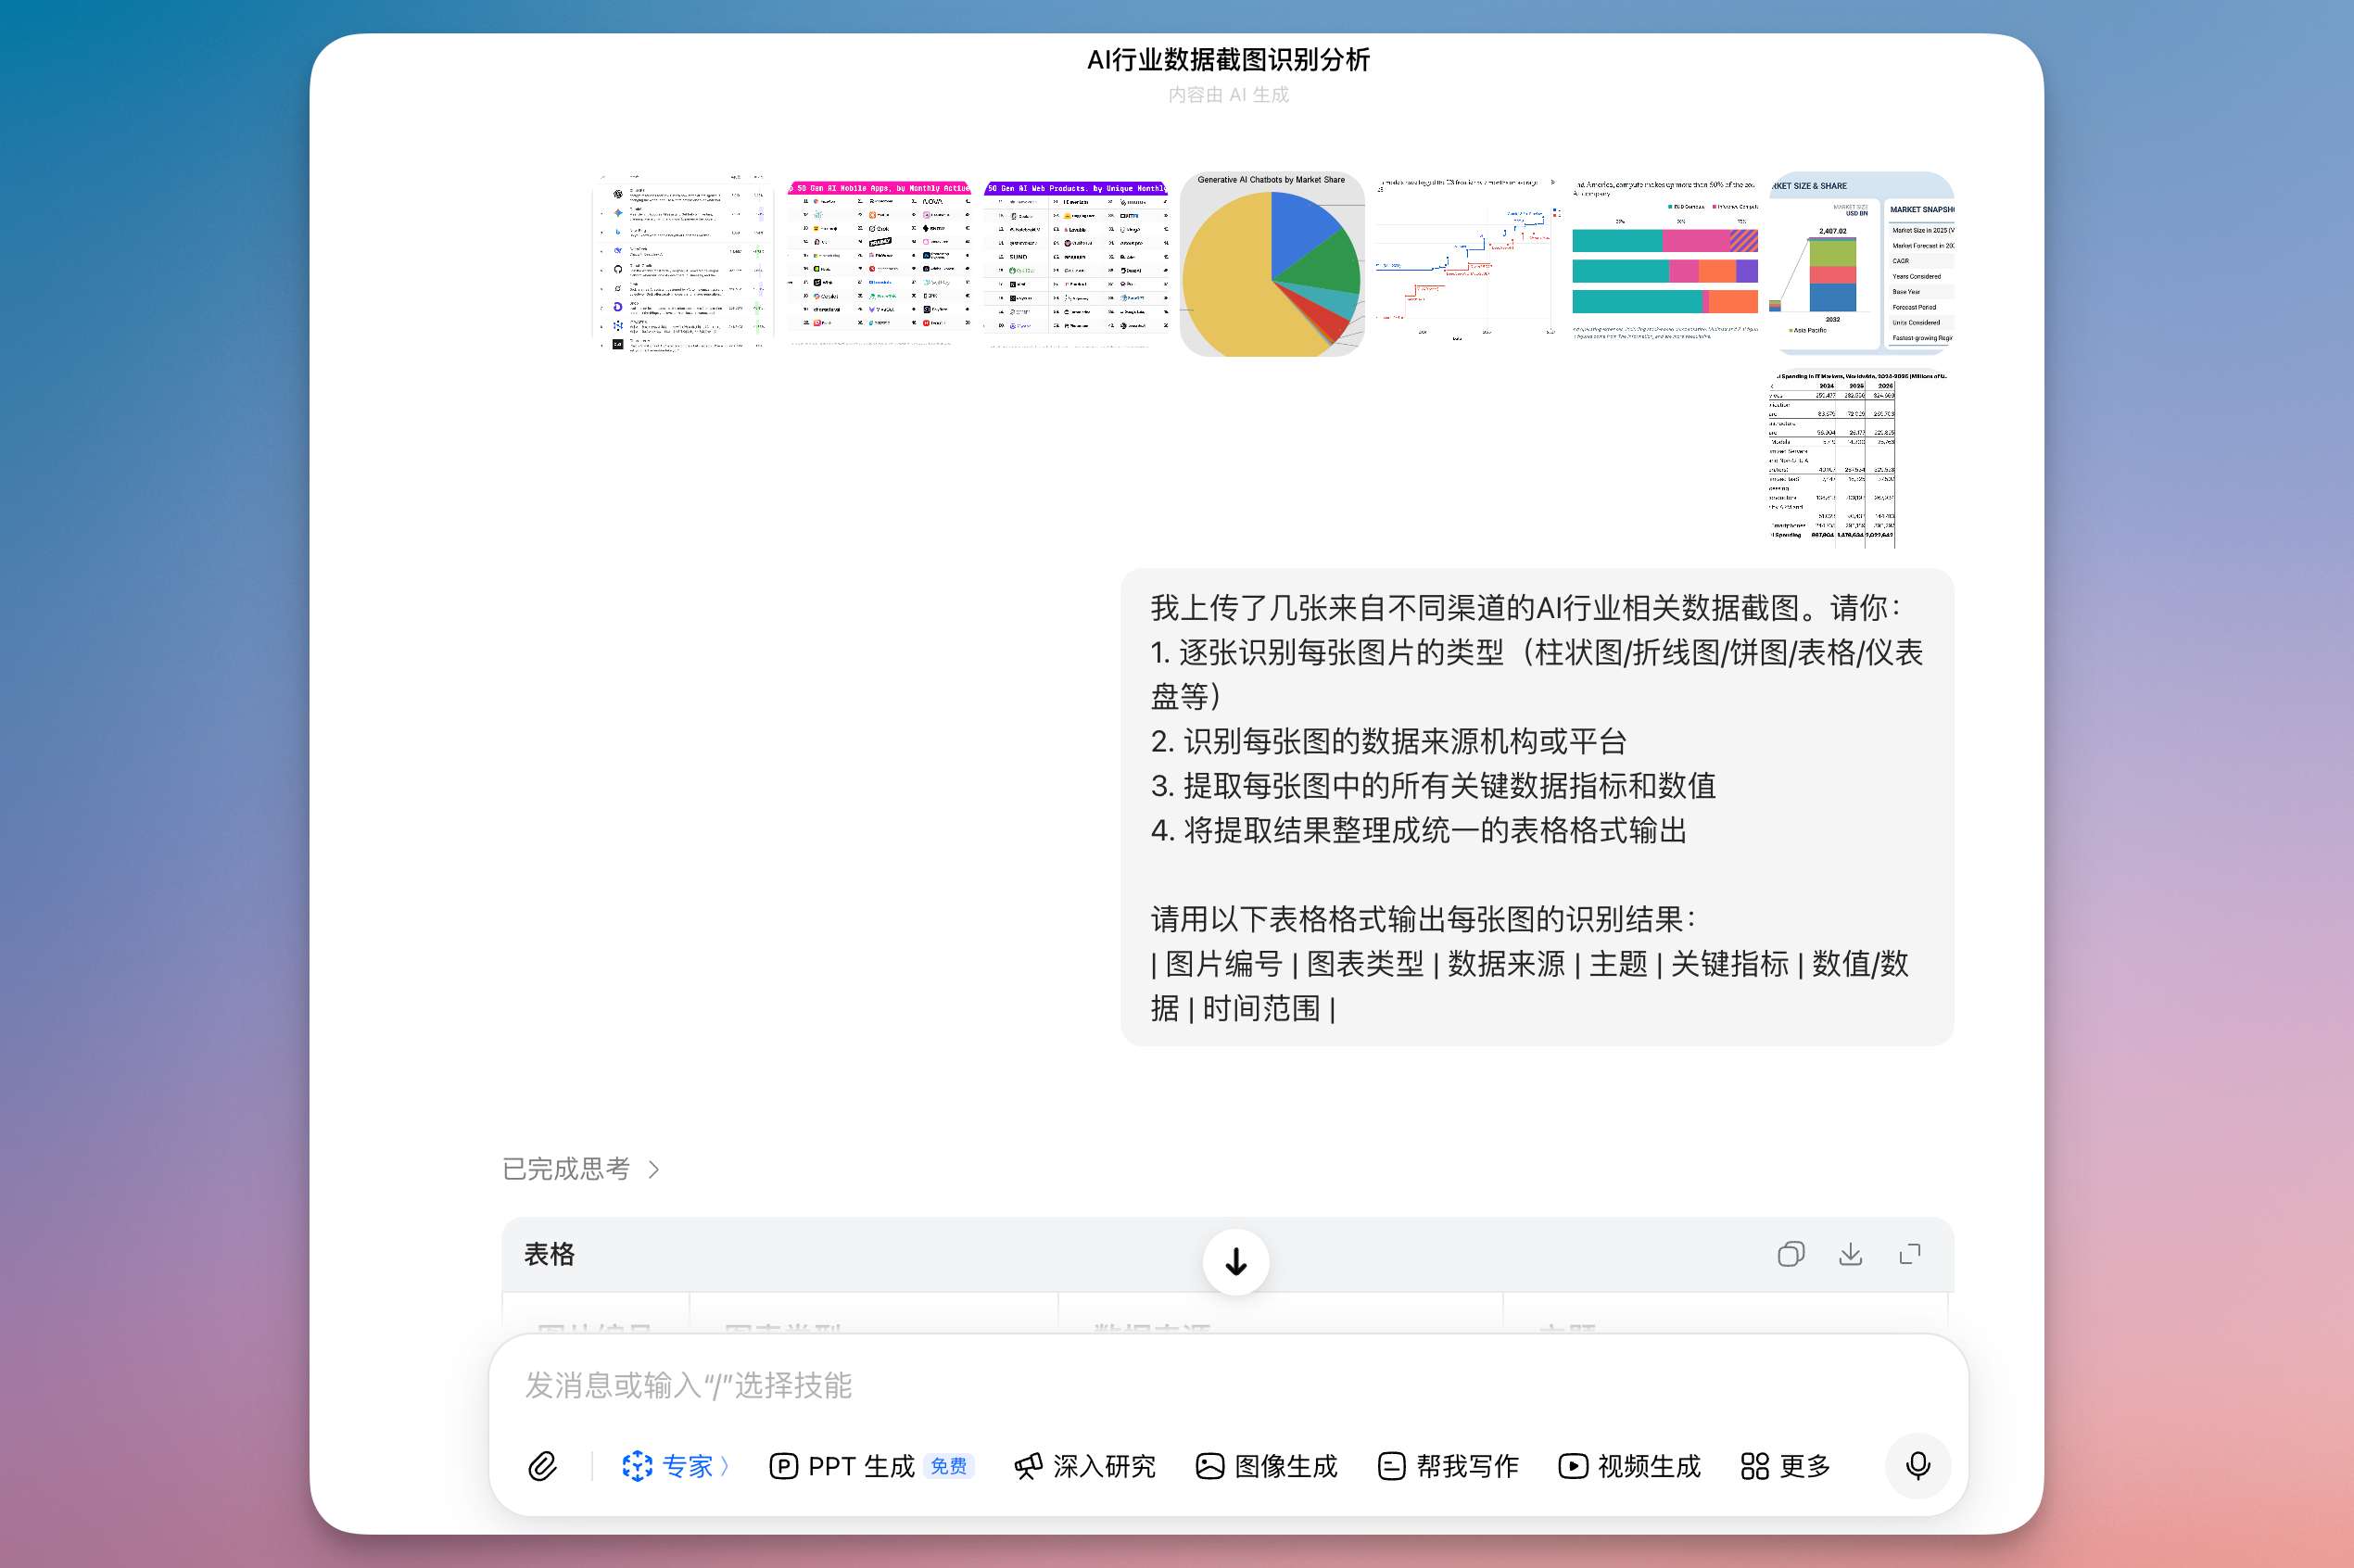
提示词如下:
我上传了几张来自不同渠道的 AI 行业相关数据截图。请你:
1. 逐张识别每张图片的类型(柱状图/折线图/饼图/表格/仪表盘等)
2. 识别每张图的数据来源机构或平台
3. 提取每张图中的所有关键数据指标和数值
4. 将提取结果整理成统一的表格格式输出
请用以下表格格式输出每张图的识别结果:
| 图片编号 | 图表类型 | 数据来源 | 主题 | 关键指标 | 数值/数据 | 时间范围 |
效果超出预期。
8 种不同图表类型,全部识别正确。图里的小数点、百分比、坐标轴标注,精准提取。这个 OCR 精度放在半年前,大部分模型都做不到。
但做到这一步肯定是不够的,我还需要它进一步进行交叉对比分析。
因为这几家机构的数据其实是有冲突的,于是我追问了一轮:
现在请你对刚才提取的图表数据进行交叉对比分析:
1. 找出不同来源中引用了相同指标但数值存在差异的数据点
2. 分析这些数据差异可能的原因(统计口径不同?时间节点不同?样本差异?)
3. 判断哪个来源的数据可信度更高,并给出你的理由
4. 用表格列出所有发现的数据矛盾点
注意:请展示你的推理过程,不要只给结论。
豆包 2.0 不仅发现了这个矛盾,还给出了原因分析:统计口径不同,一个包含了硬件市场,另一个仅统计软件和服务。
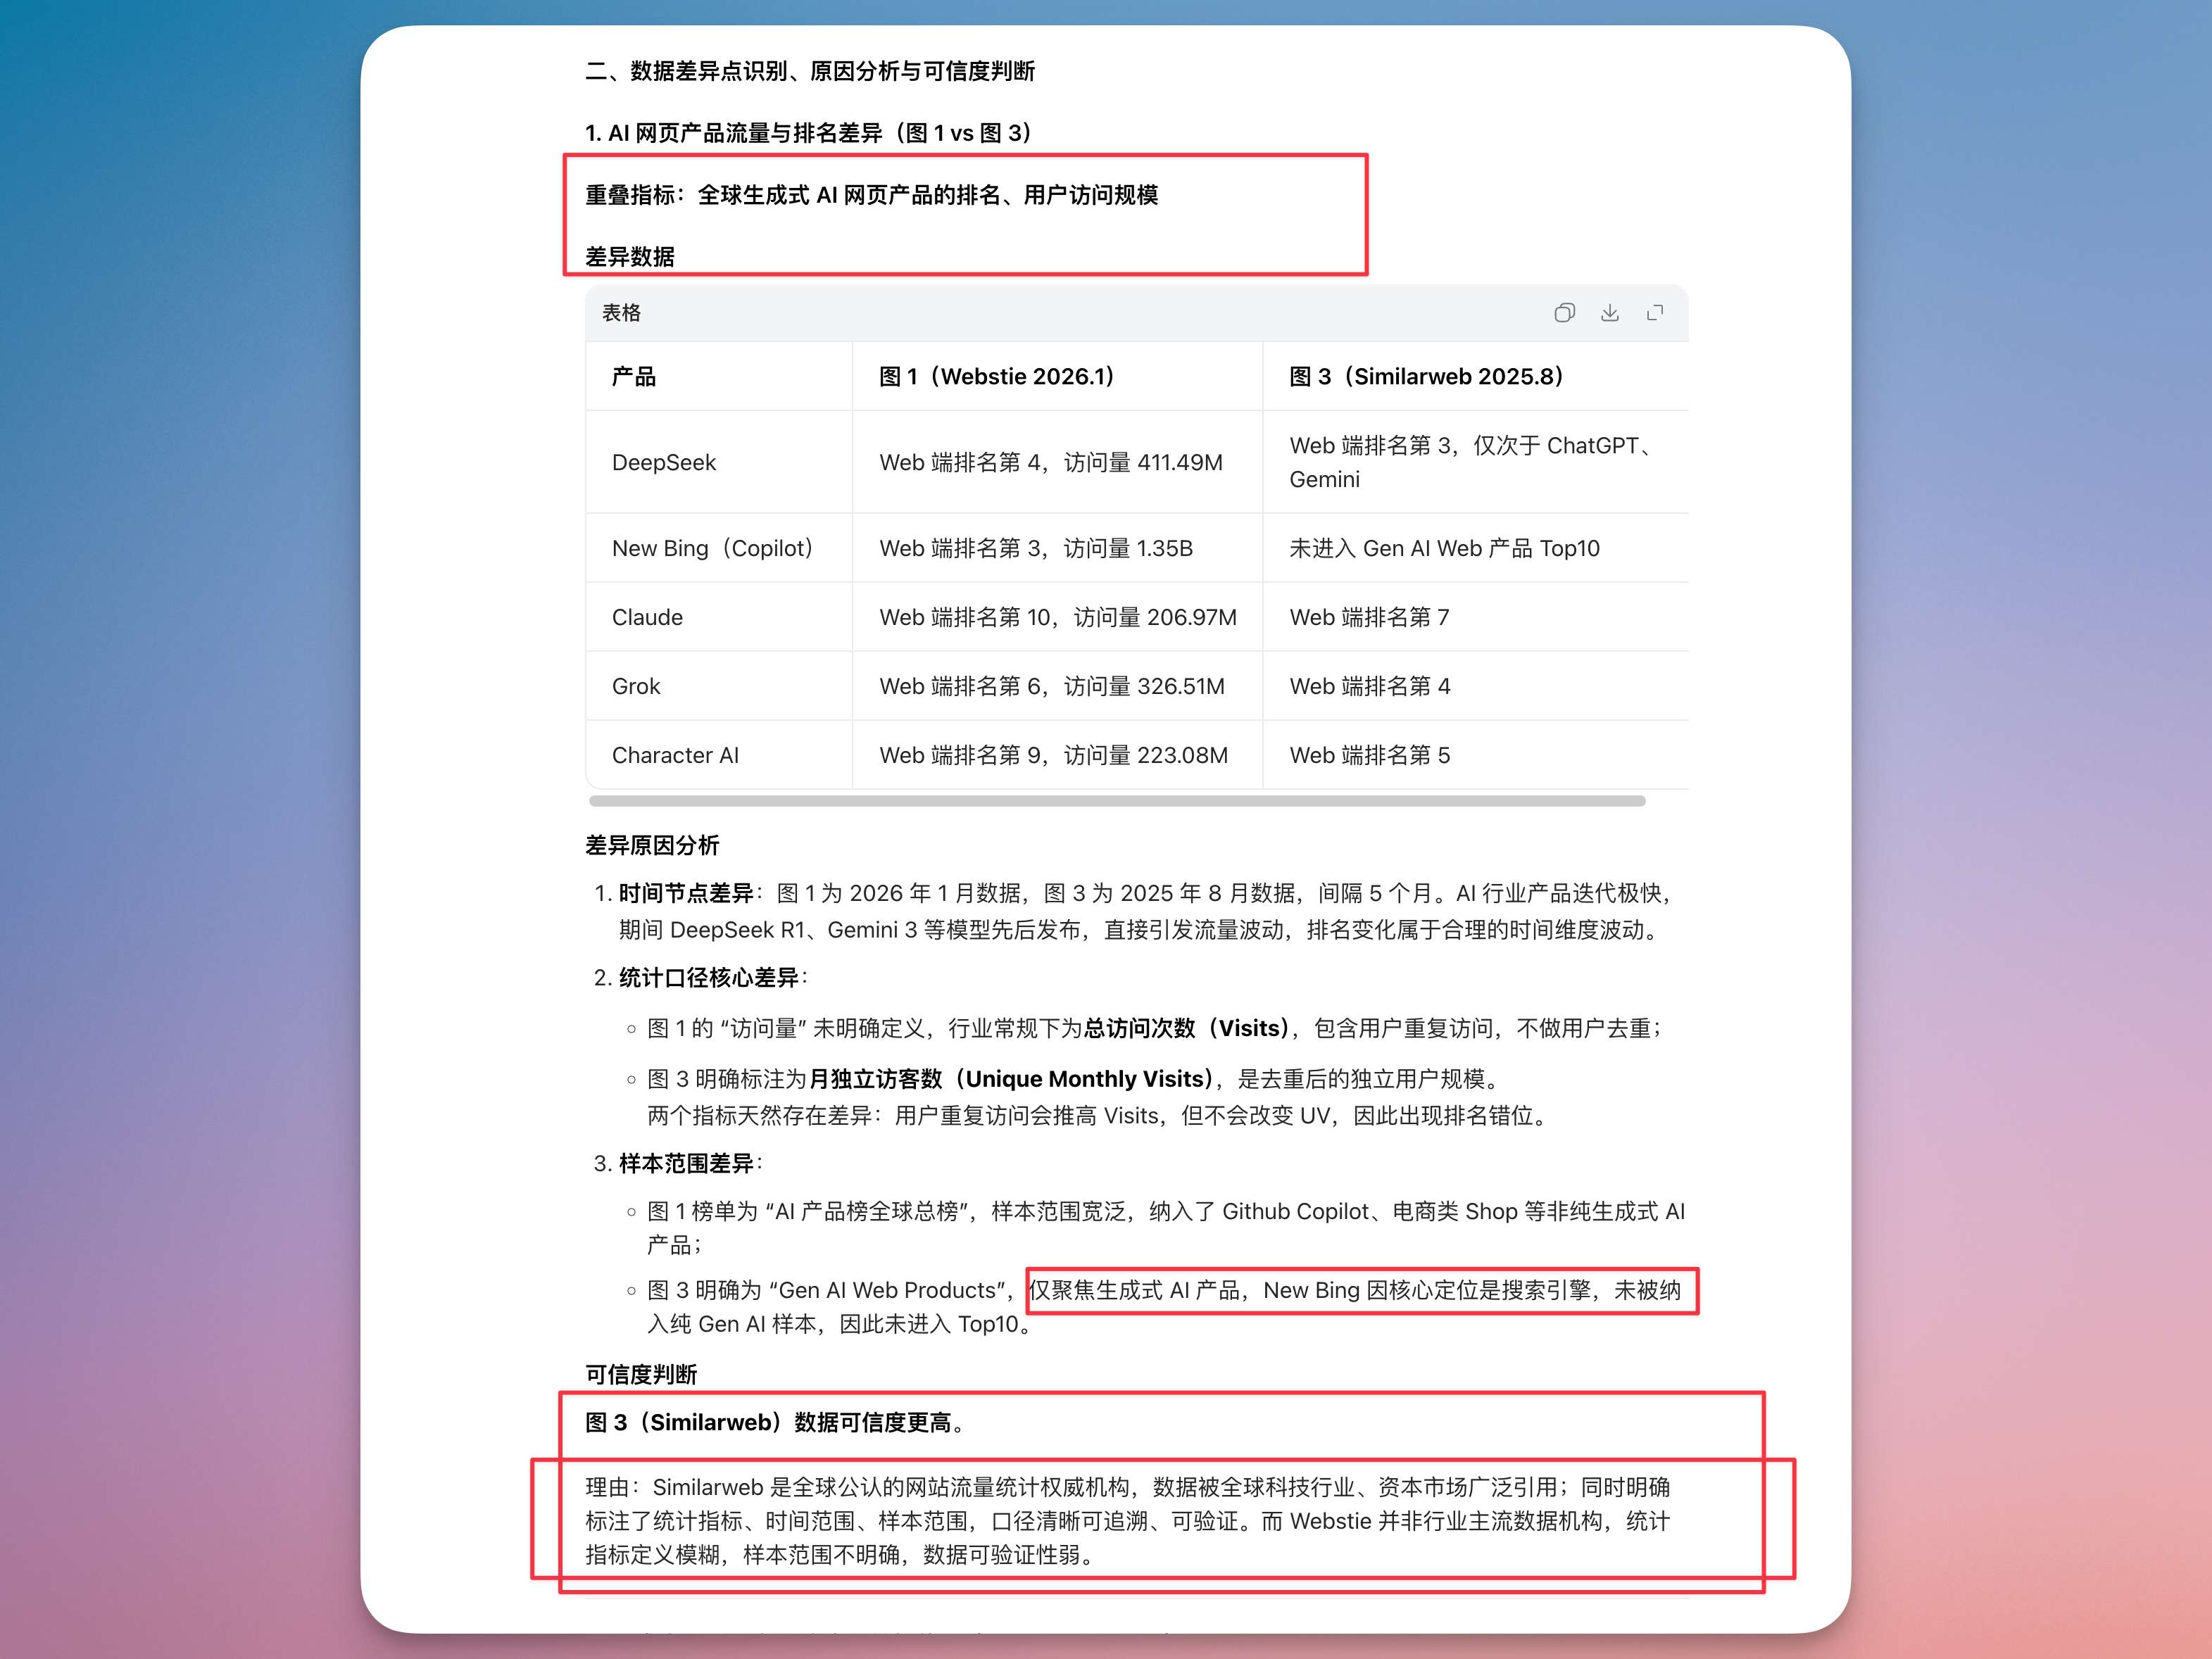
这就不是简单的 OCR 了,而是在推理。
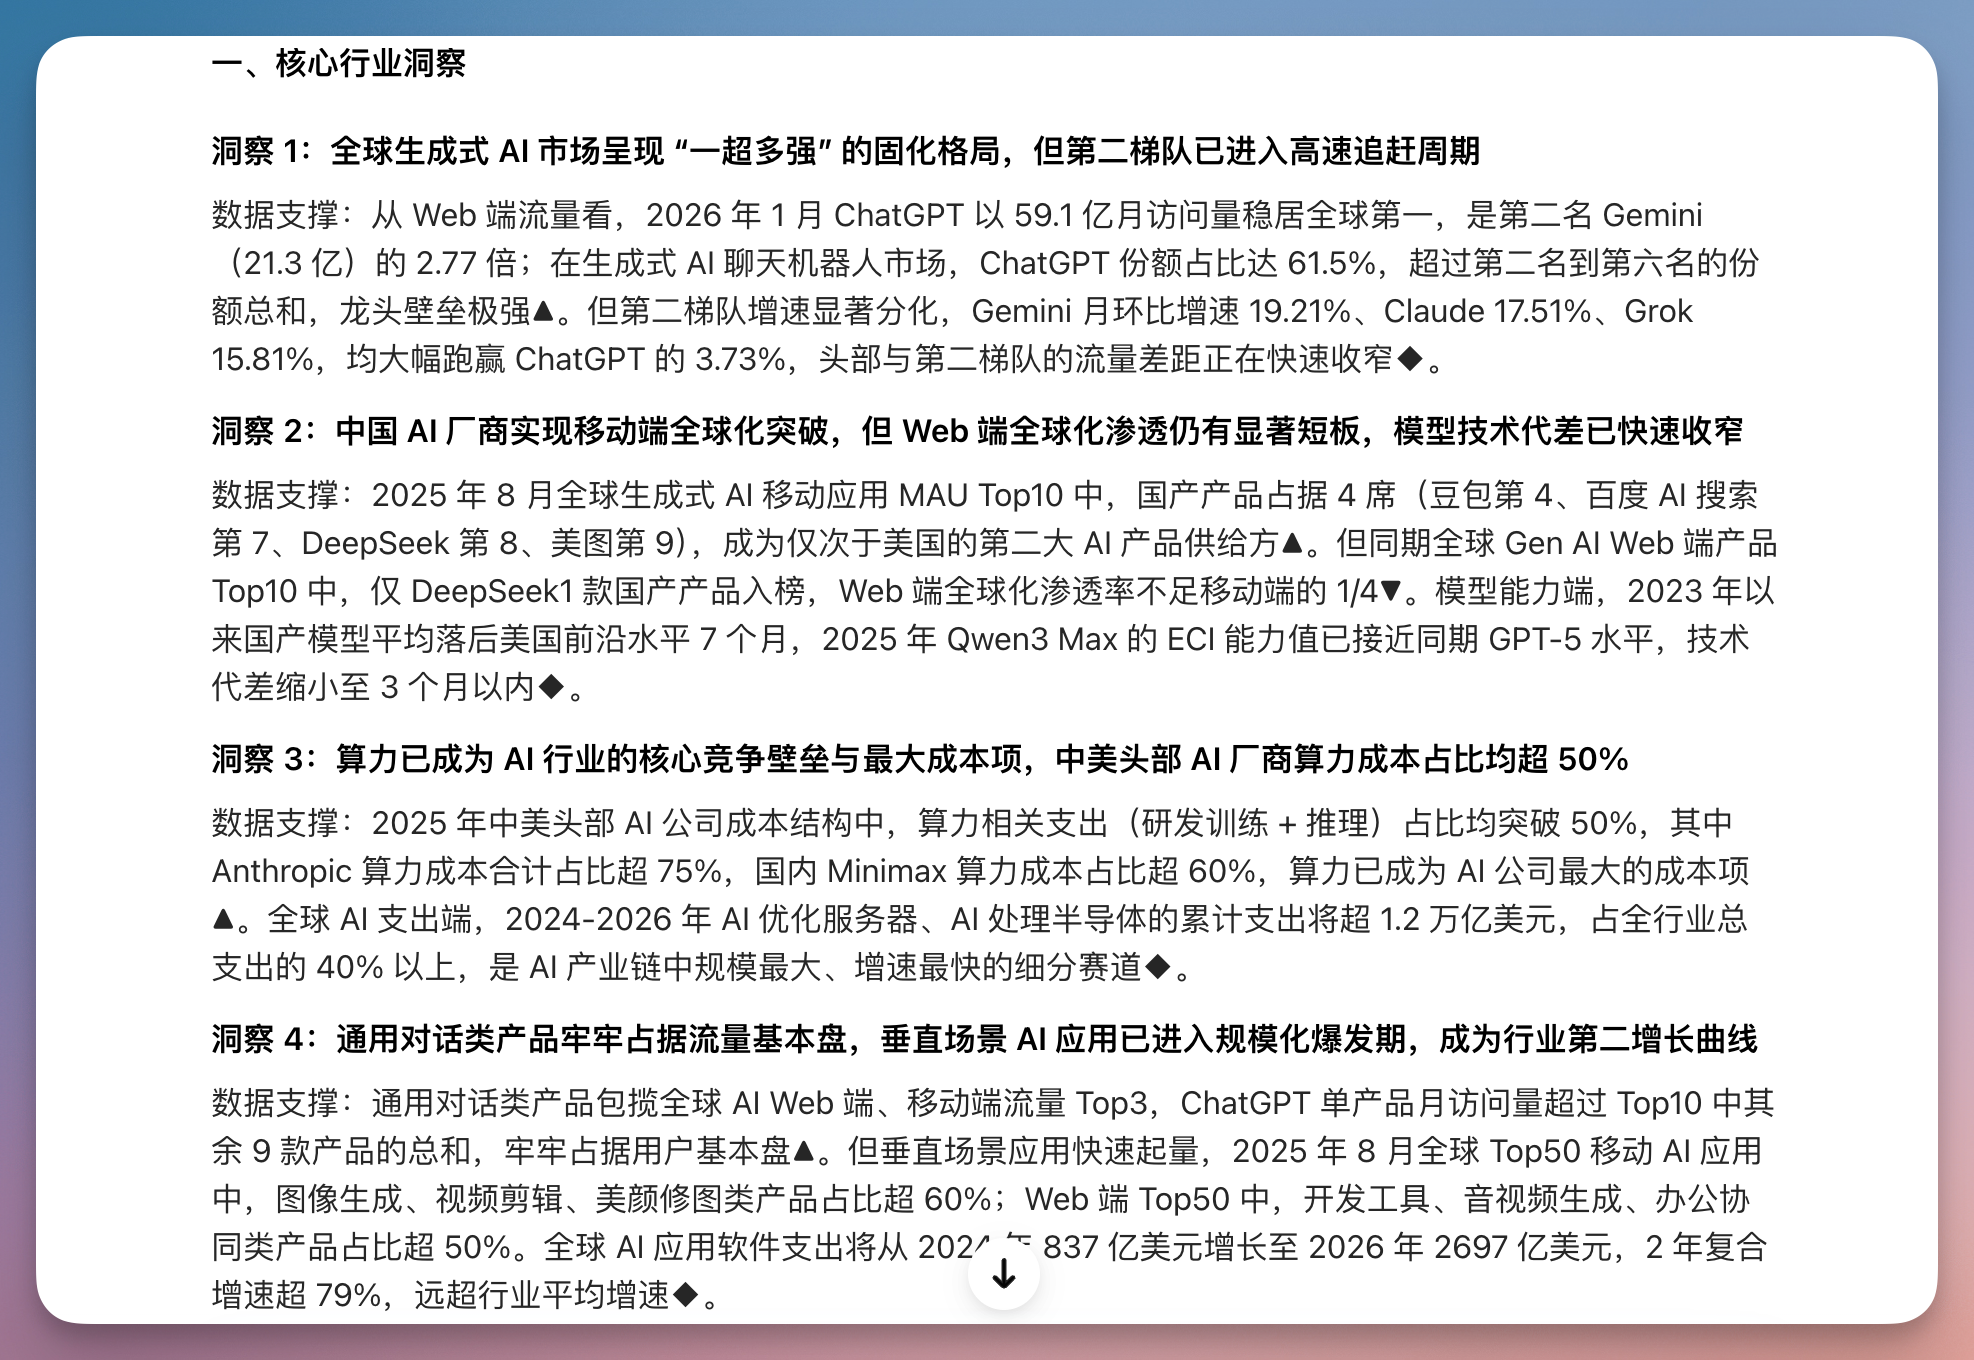
继续追问趋势研判,它又输出了一份带有 ▲ ▼ ◆ 标记的洞察报告。格式整齐,数据准确,层次清晰。直接拿去做汇报都不需要太多修改。
而且还可以利用它的code生成,把非格式化的数据转成图表。
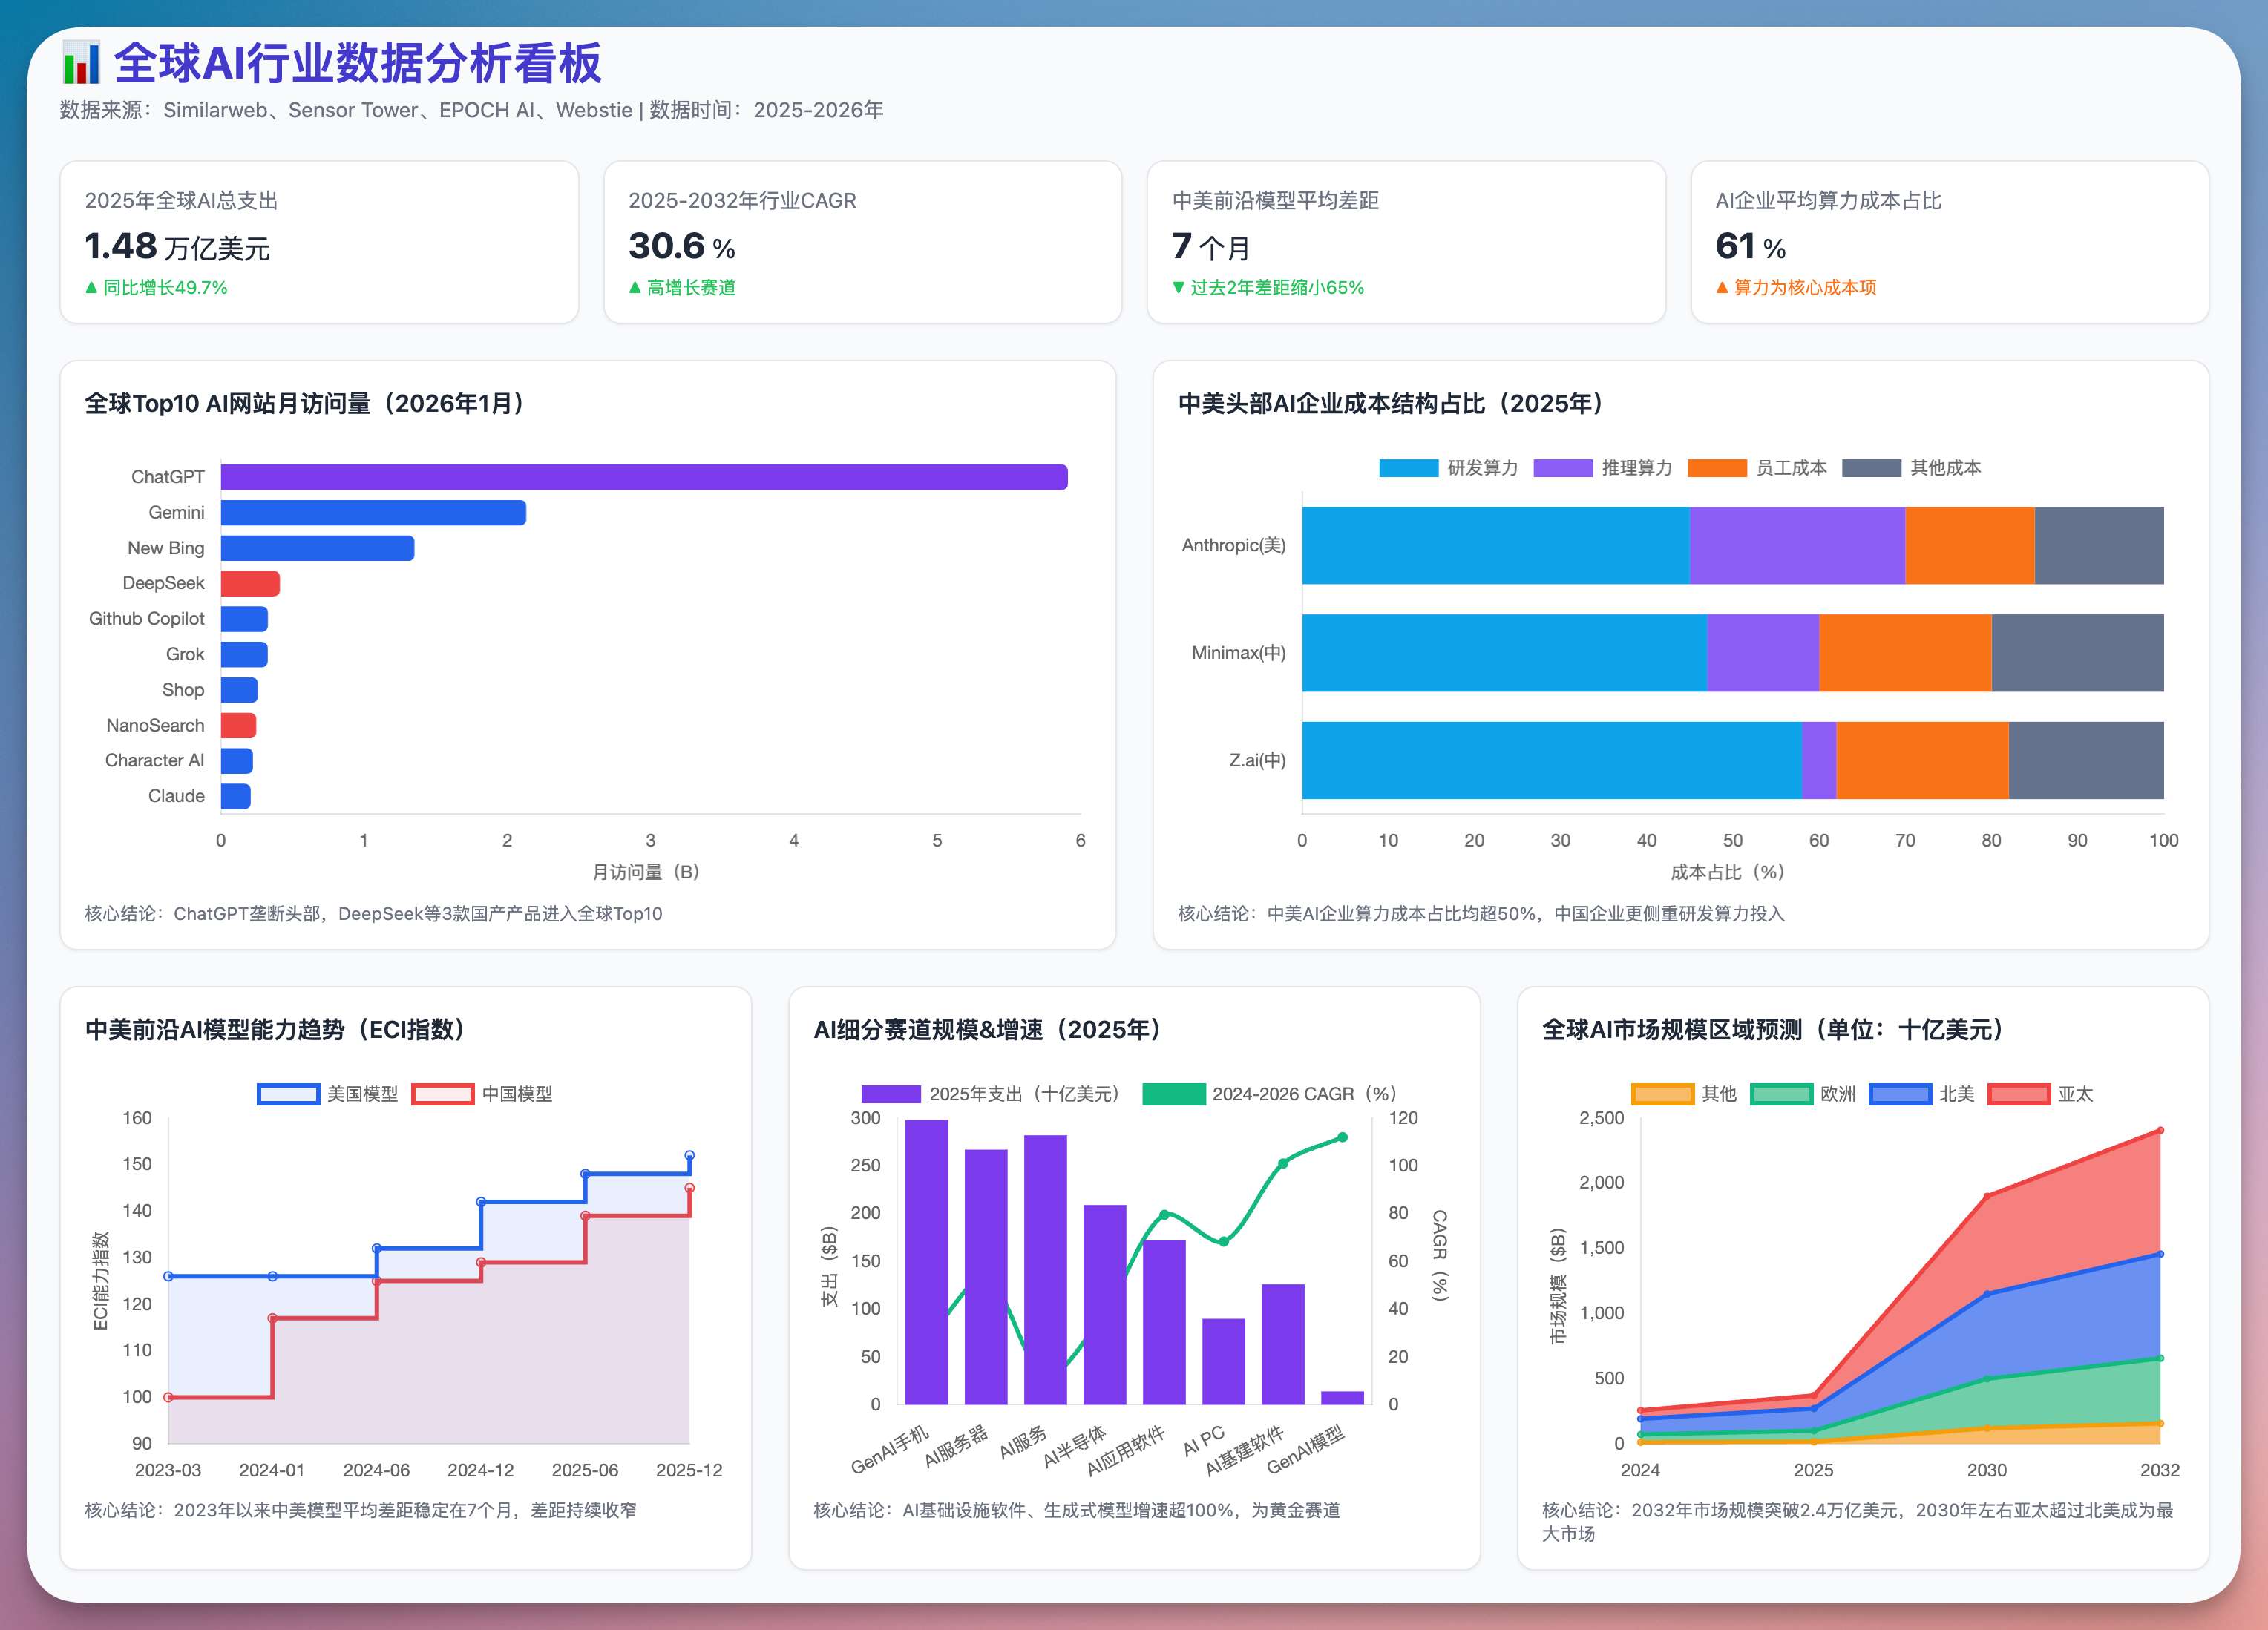
当然,我这个场景里给出的这些结论完全依赖于上传的这几个图表,我并没有让它自由搜索发挥,所以结论完全基于我上传的图表,仅供参考
像这种数据分析类的场景,很多粉丝都留言问过我,最关键的还是依赖于:
模型的多模态能力、文字提取、图表理解,然后再结合你的Prompt,基本上就能完成一些数据的分析和调研工作。
豆包 2.0 这次的升级就比较明显。它不只是「看到」了图表,还「看懂」了图表背后的数据逻辑。
日常需要处理大量报表、做竞品分析或行业研究的朋友,这个能力值得试试。
Case 2:AI 投资教练(从 K 线图到四位大佬的私董会)
第三个场景,是我最想展示的。
也是我认为最能体现豆包 2.0「企业级 Agent 能力」的案例。
它展示是一个完整的 Agent 工作流:
VLM 视觉识别 → 专业工具自动调用 → 多角色深度研讨 → 结构化报告输出。
四个环节串联起来,全程无需手动切换工具。
第一步:看图识势 · VLM 读 K 线
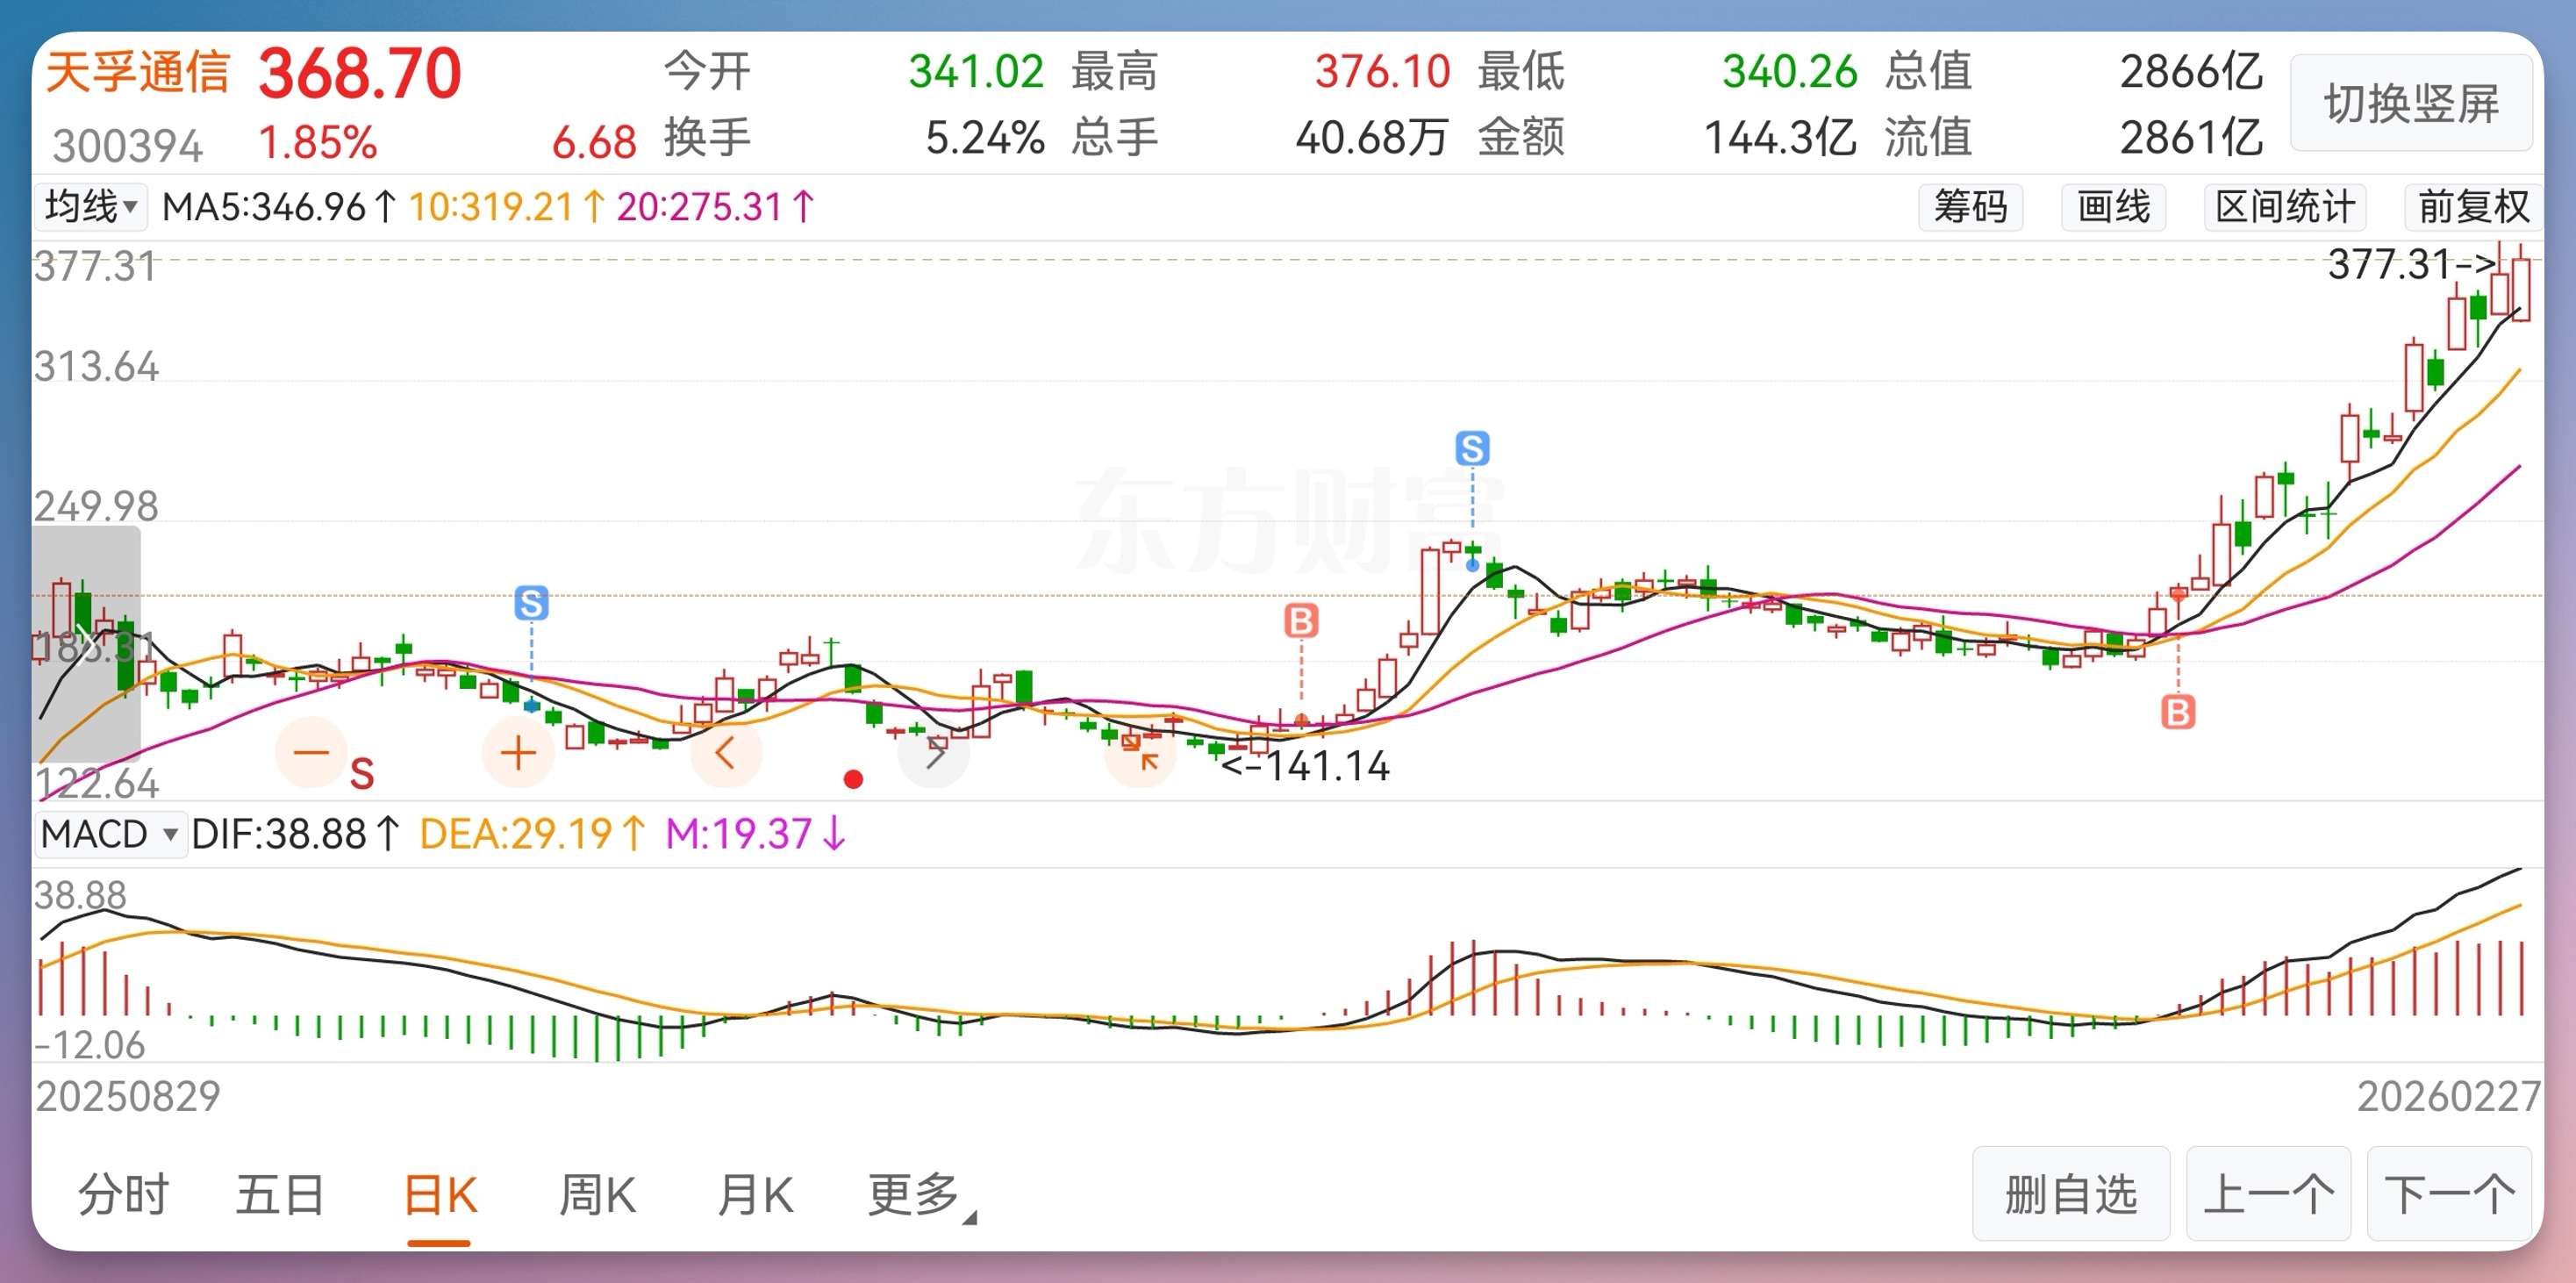
我截了一只近期有明显技术形态的 A 股 K 线日线图和 MACD/KDJ 技术指标图,上传给模型。
仅供学习交流参考!!不做推荐!!
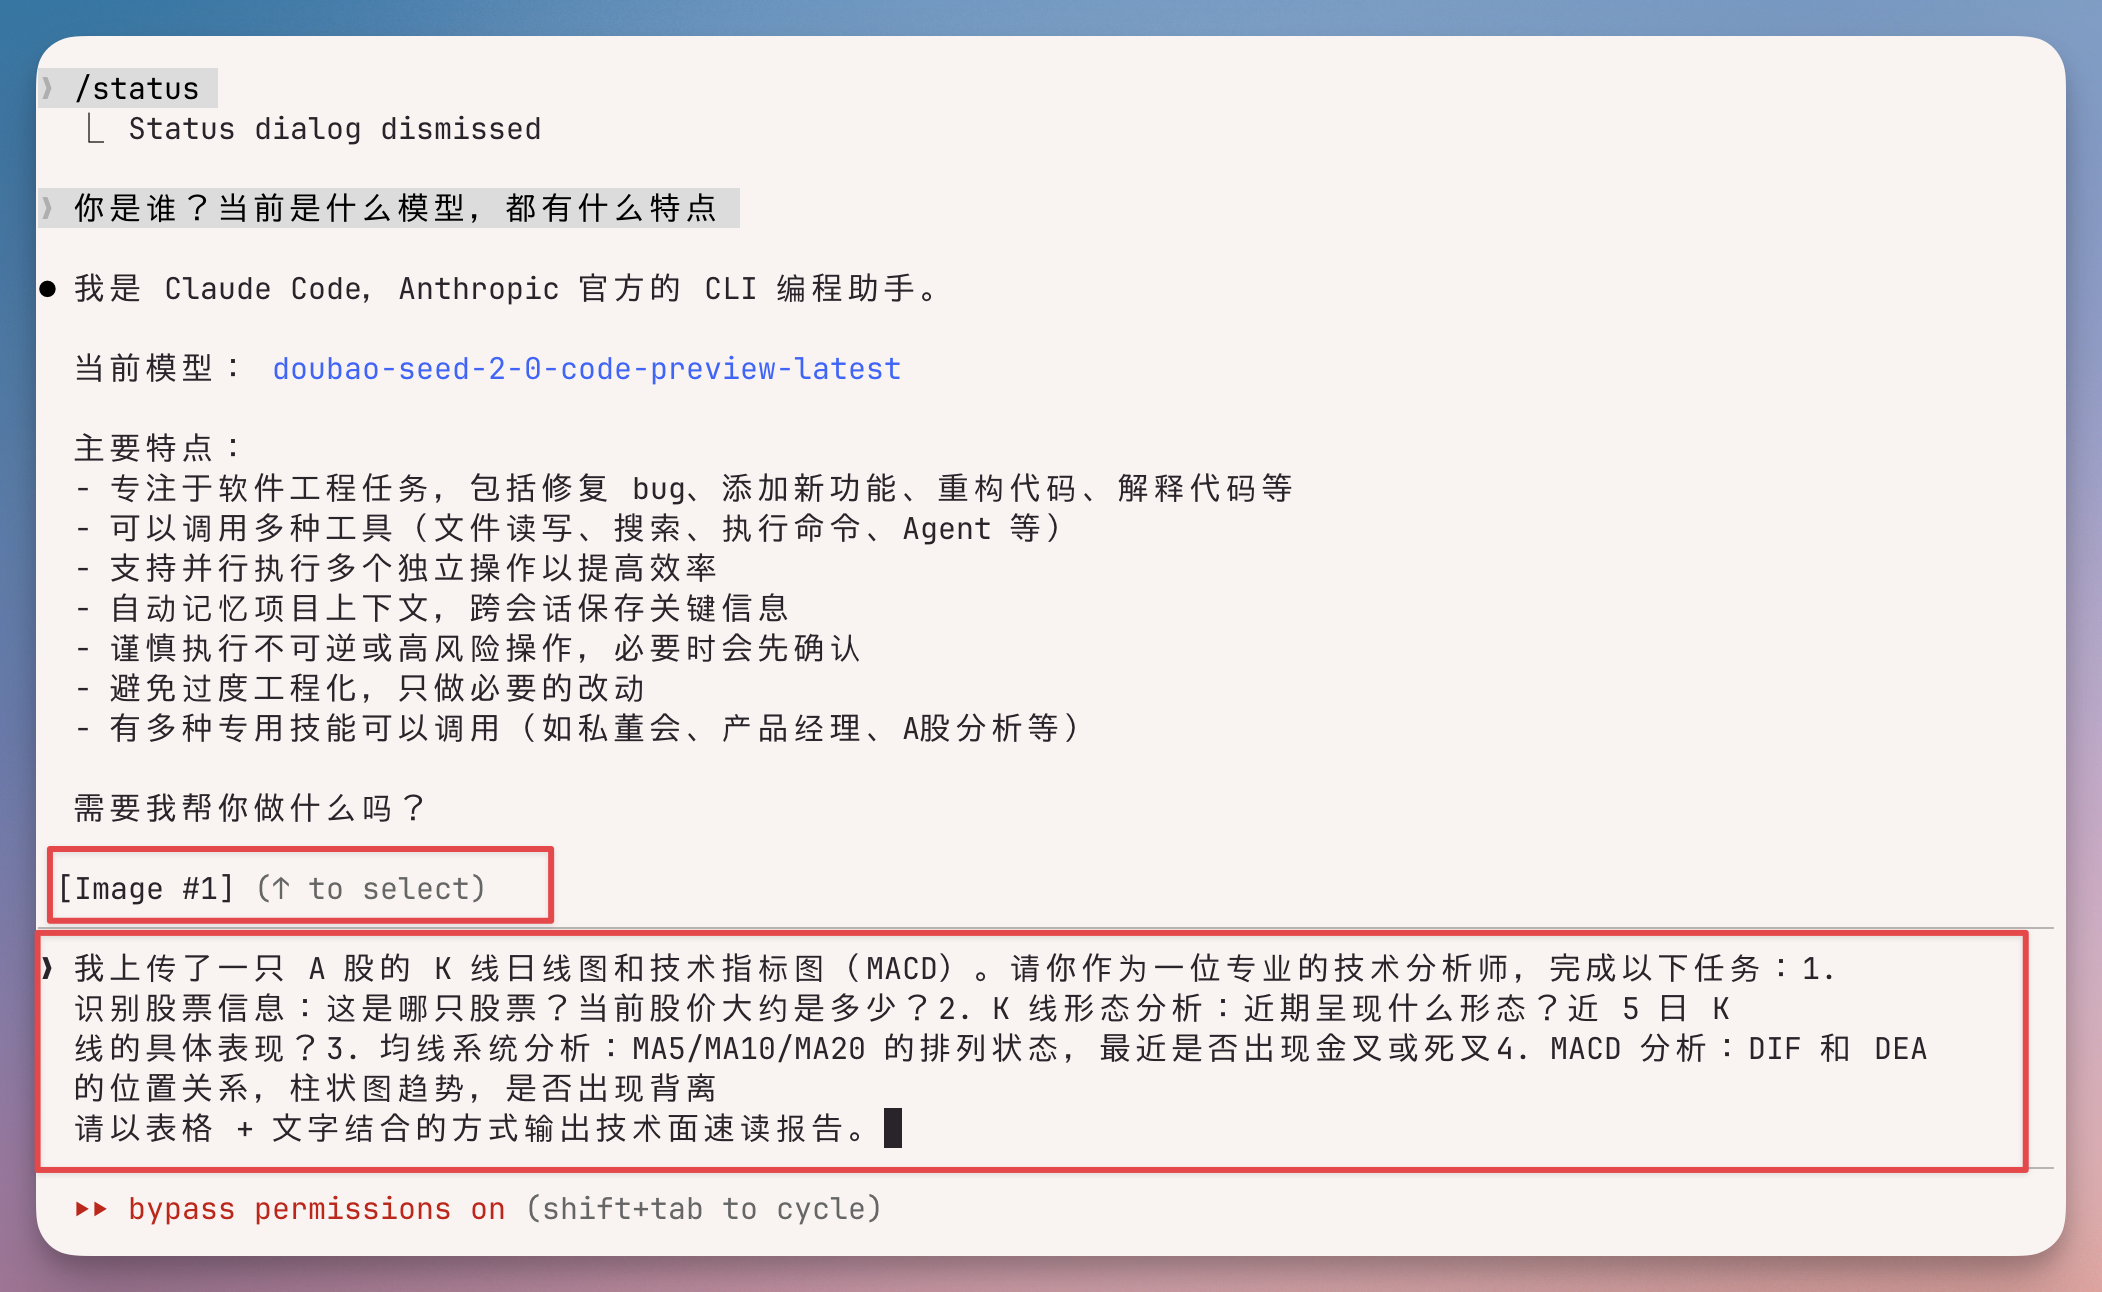
提示词:
我上传了一只 A 股的 K 线日线图和技术指标图(MACD)。
请你作为一位专业的技术分析师,完成以下任务:
1. 识别股票信息:这是哪只股票?当前股价大约是多少?
2. K 线形态分析:近期呈现什么形态?近 5 日 K 线的具体表现?
3. 均线系统分析:MA5/MA10/MA20 的排列状态,最近是否出现金叉或死叉
4. MACD 分析:DIF 和 DEA 的位置关系,柱状图趋势,是否出现背离
请以表格 + 文字结合的方式输出技术面速读报告。
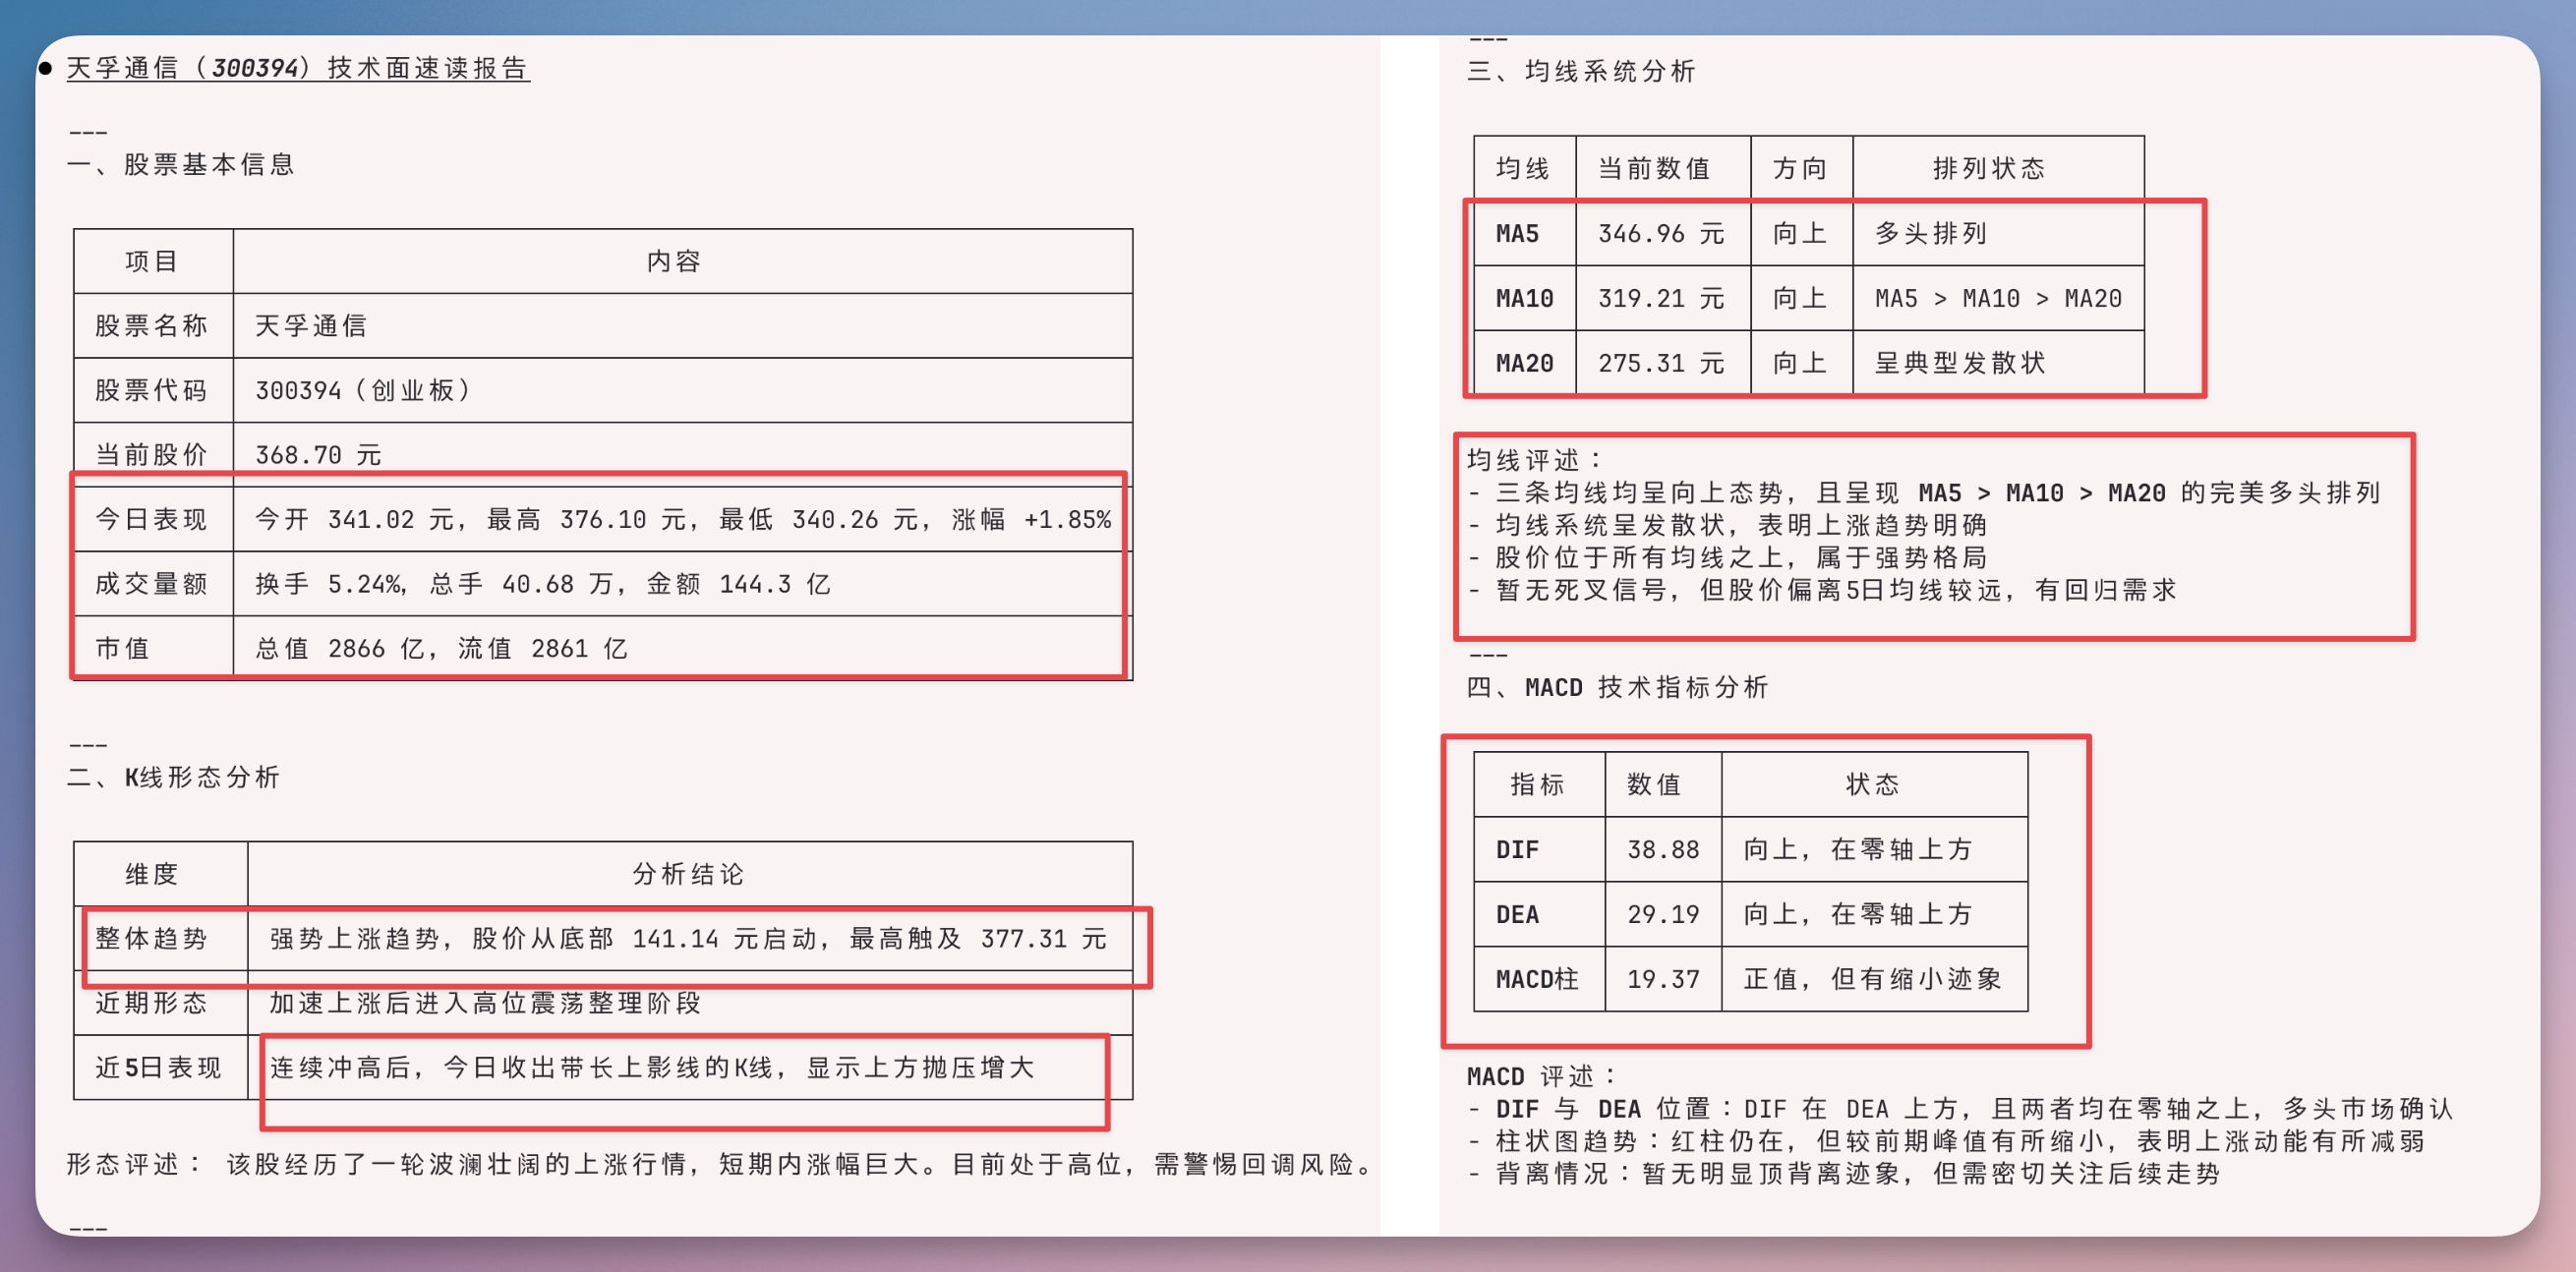
理解识别的非常准确。
MA5/MA10/MA20 的多头排列,识别正确。MACD 信号,判断准确。甚至长上影线都有描述。
一张手机截图,提取出这么丰富的技术分析信息。
VLM 的图表理解能力,确实到位了。
第二步:调兵遣将
接下来,我又上传了这只股票的财报数据截图。
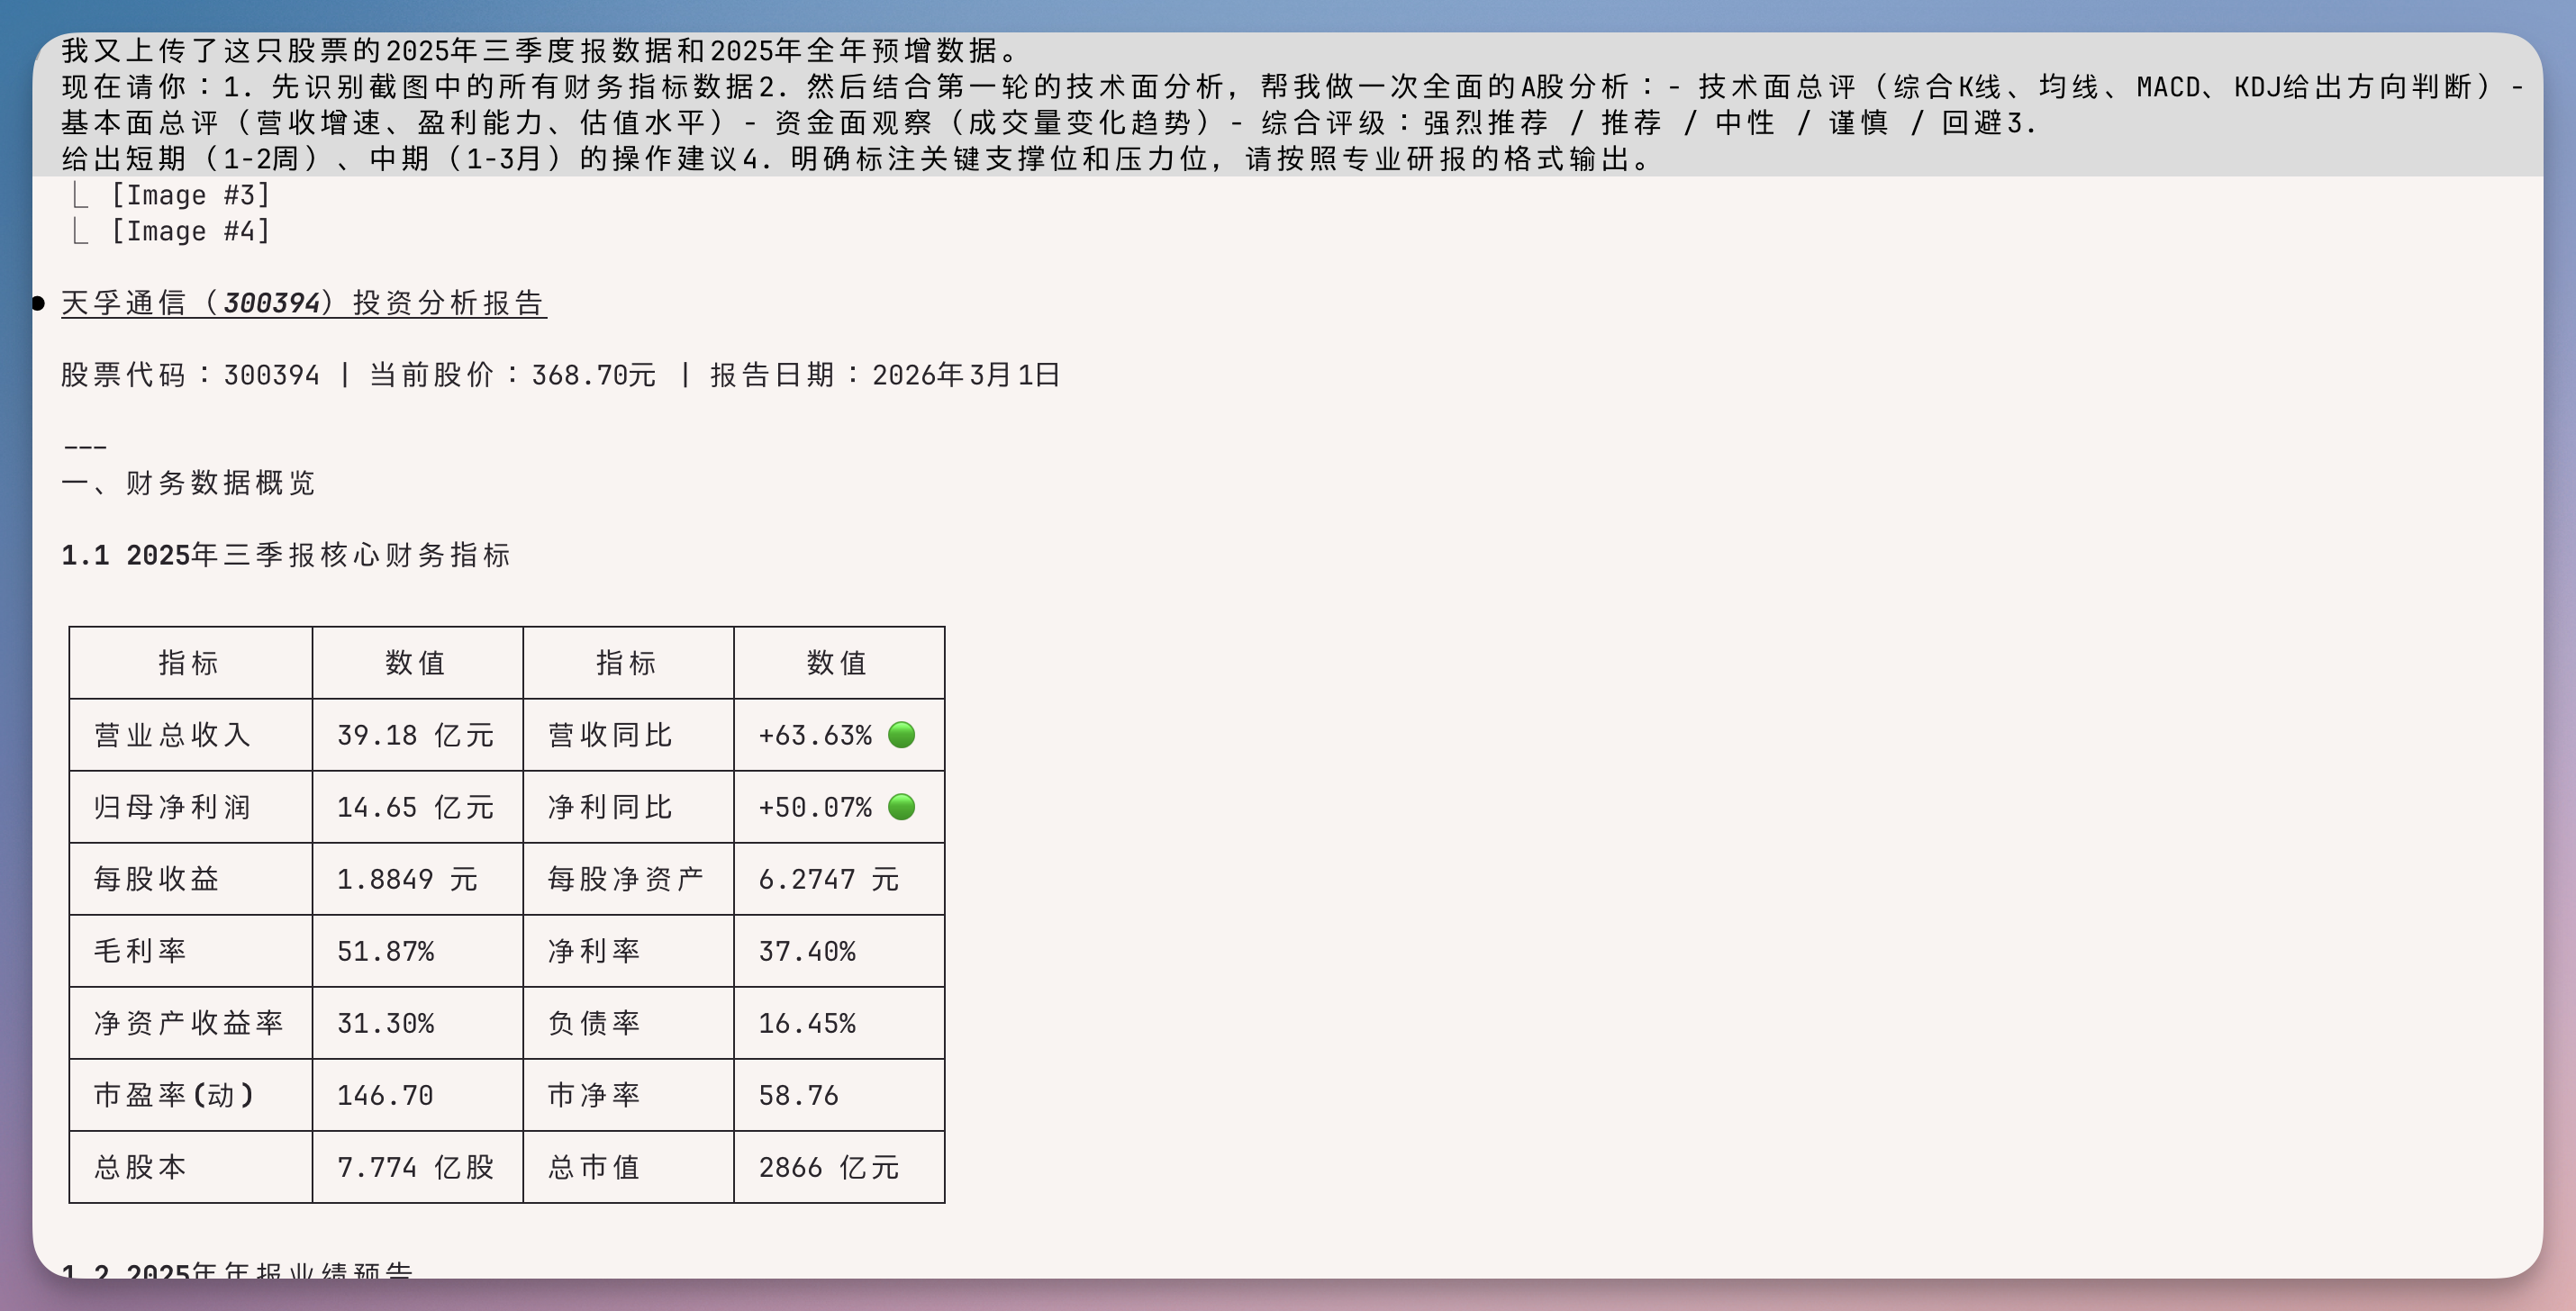
提示词:
我又上传了这只股票的最新财报数据截图。
现在请你:
1. 先识别截图中的所有财务指标数据
2. 然后结合第一轮的技术面分析,做一次全面的 A 股分析:
   - 技术面总评(综合 K 线、均线、MACD、KDJ 给出方向判断)
   - 基本面总评(营收增速、盈利能力、估值水平)
   - 资金面观察(成交量变化趋势)
   - 综合评级:强烈推荐 / 推荐 / 中性 / 谨慎 / 回避
3. 给出短期(1-2 周)、中期(1-3 月)的操作建议
4. 明确标注关键支撑位和压力位

请按照专业研报的格式输出。
在 VLM 识别的静态数据基础上,还给出了操作建议。
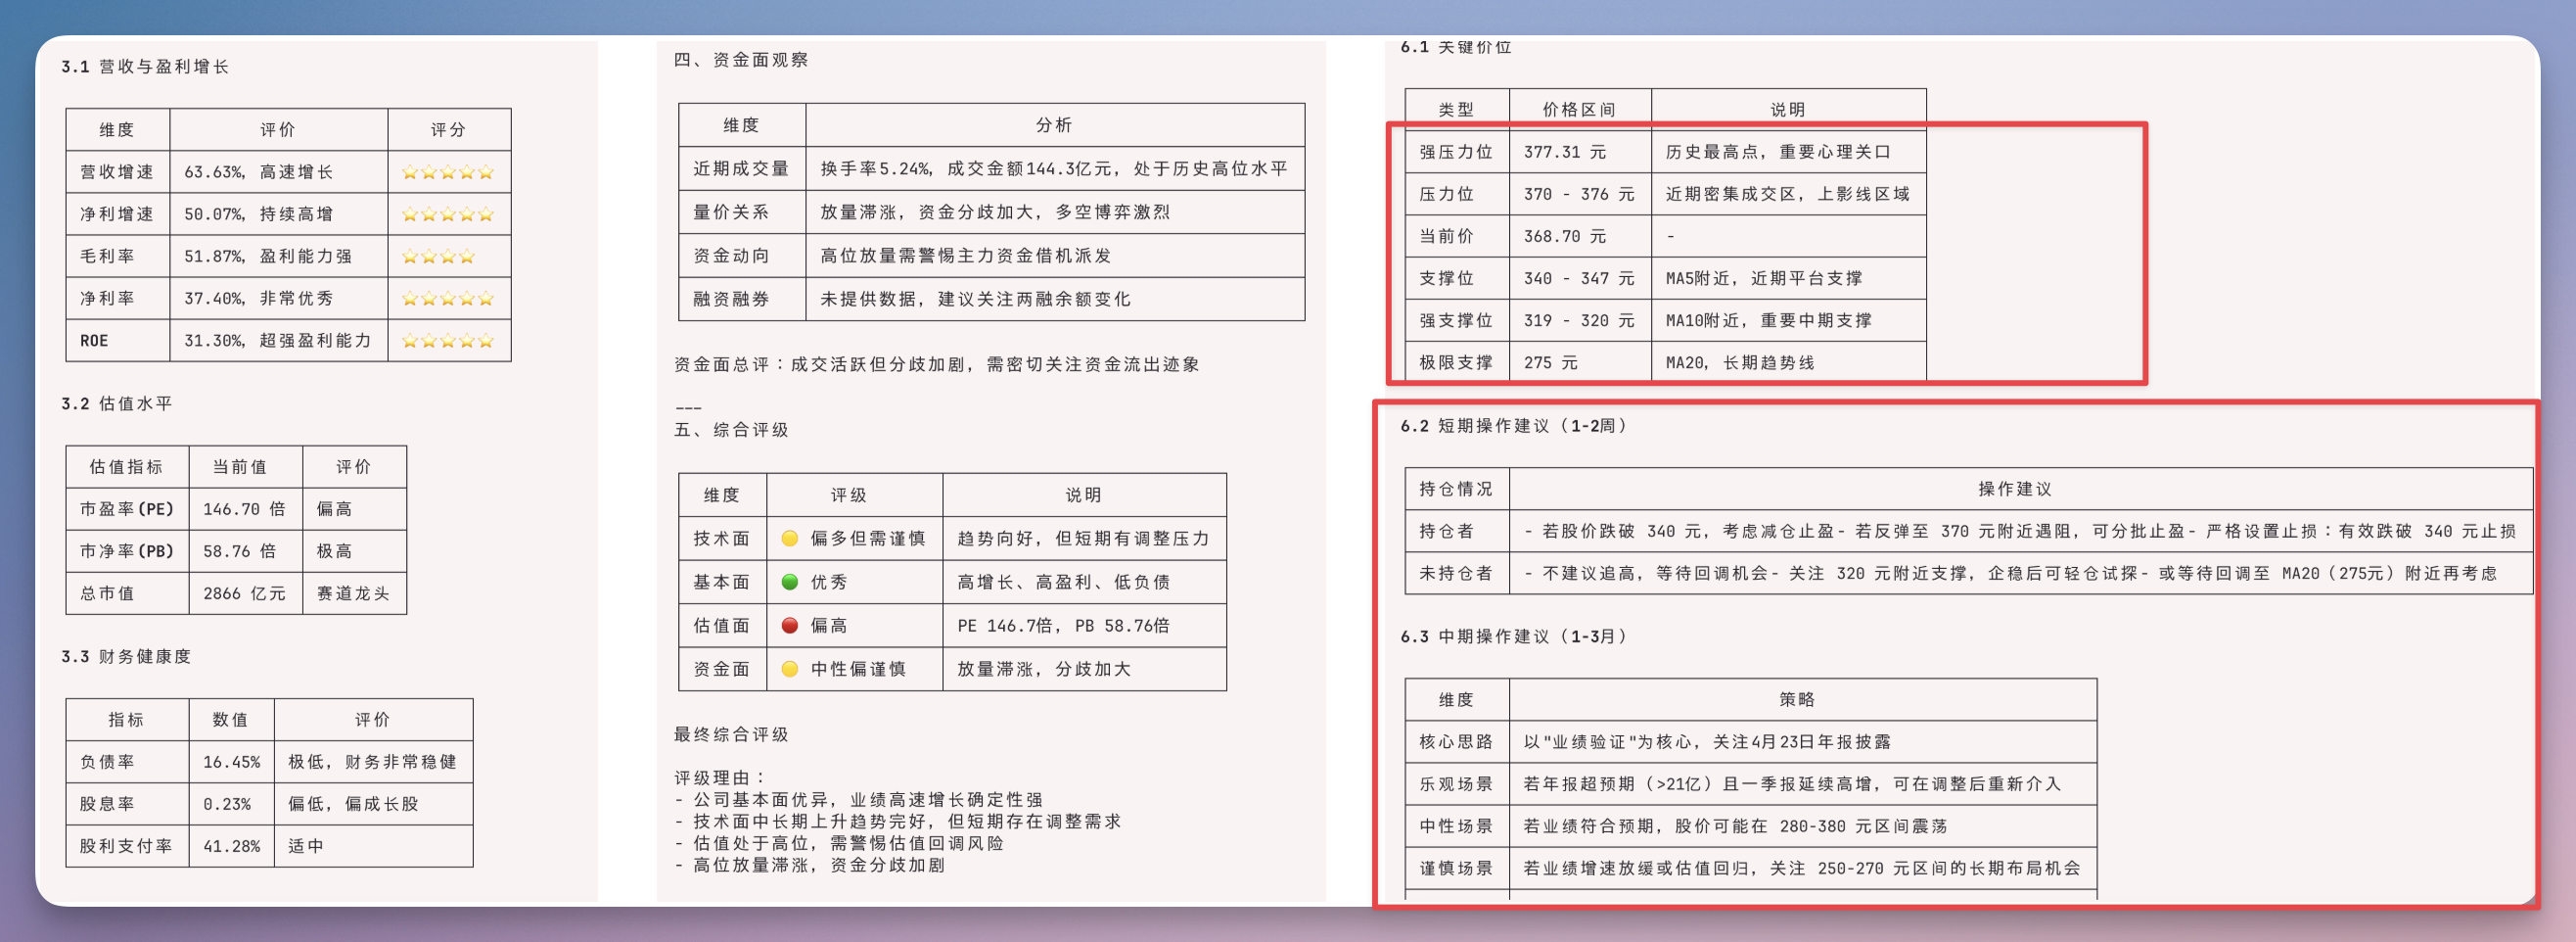
之后我又让它从不同角度试试,它调取了A 股分析 Skill开始一通分析..
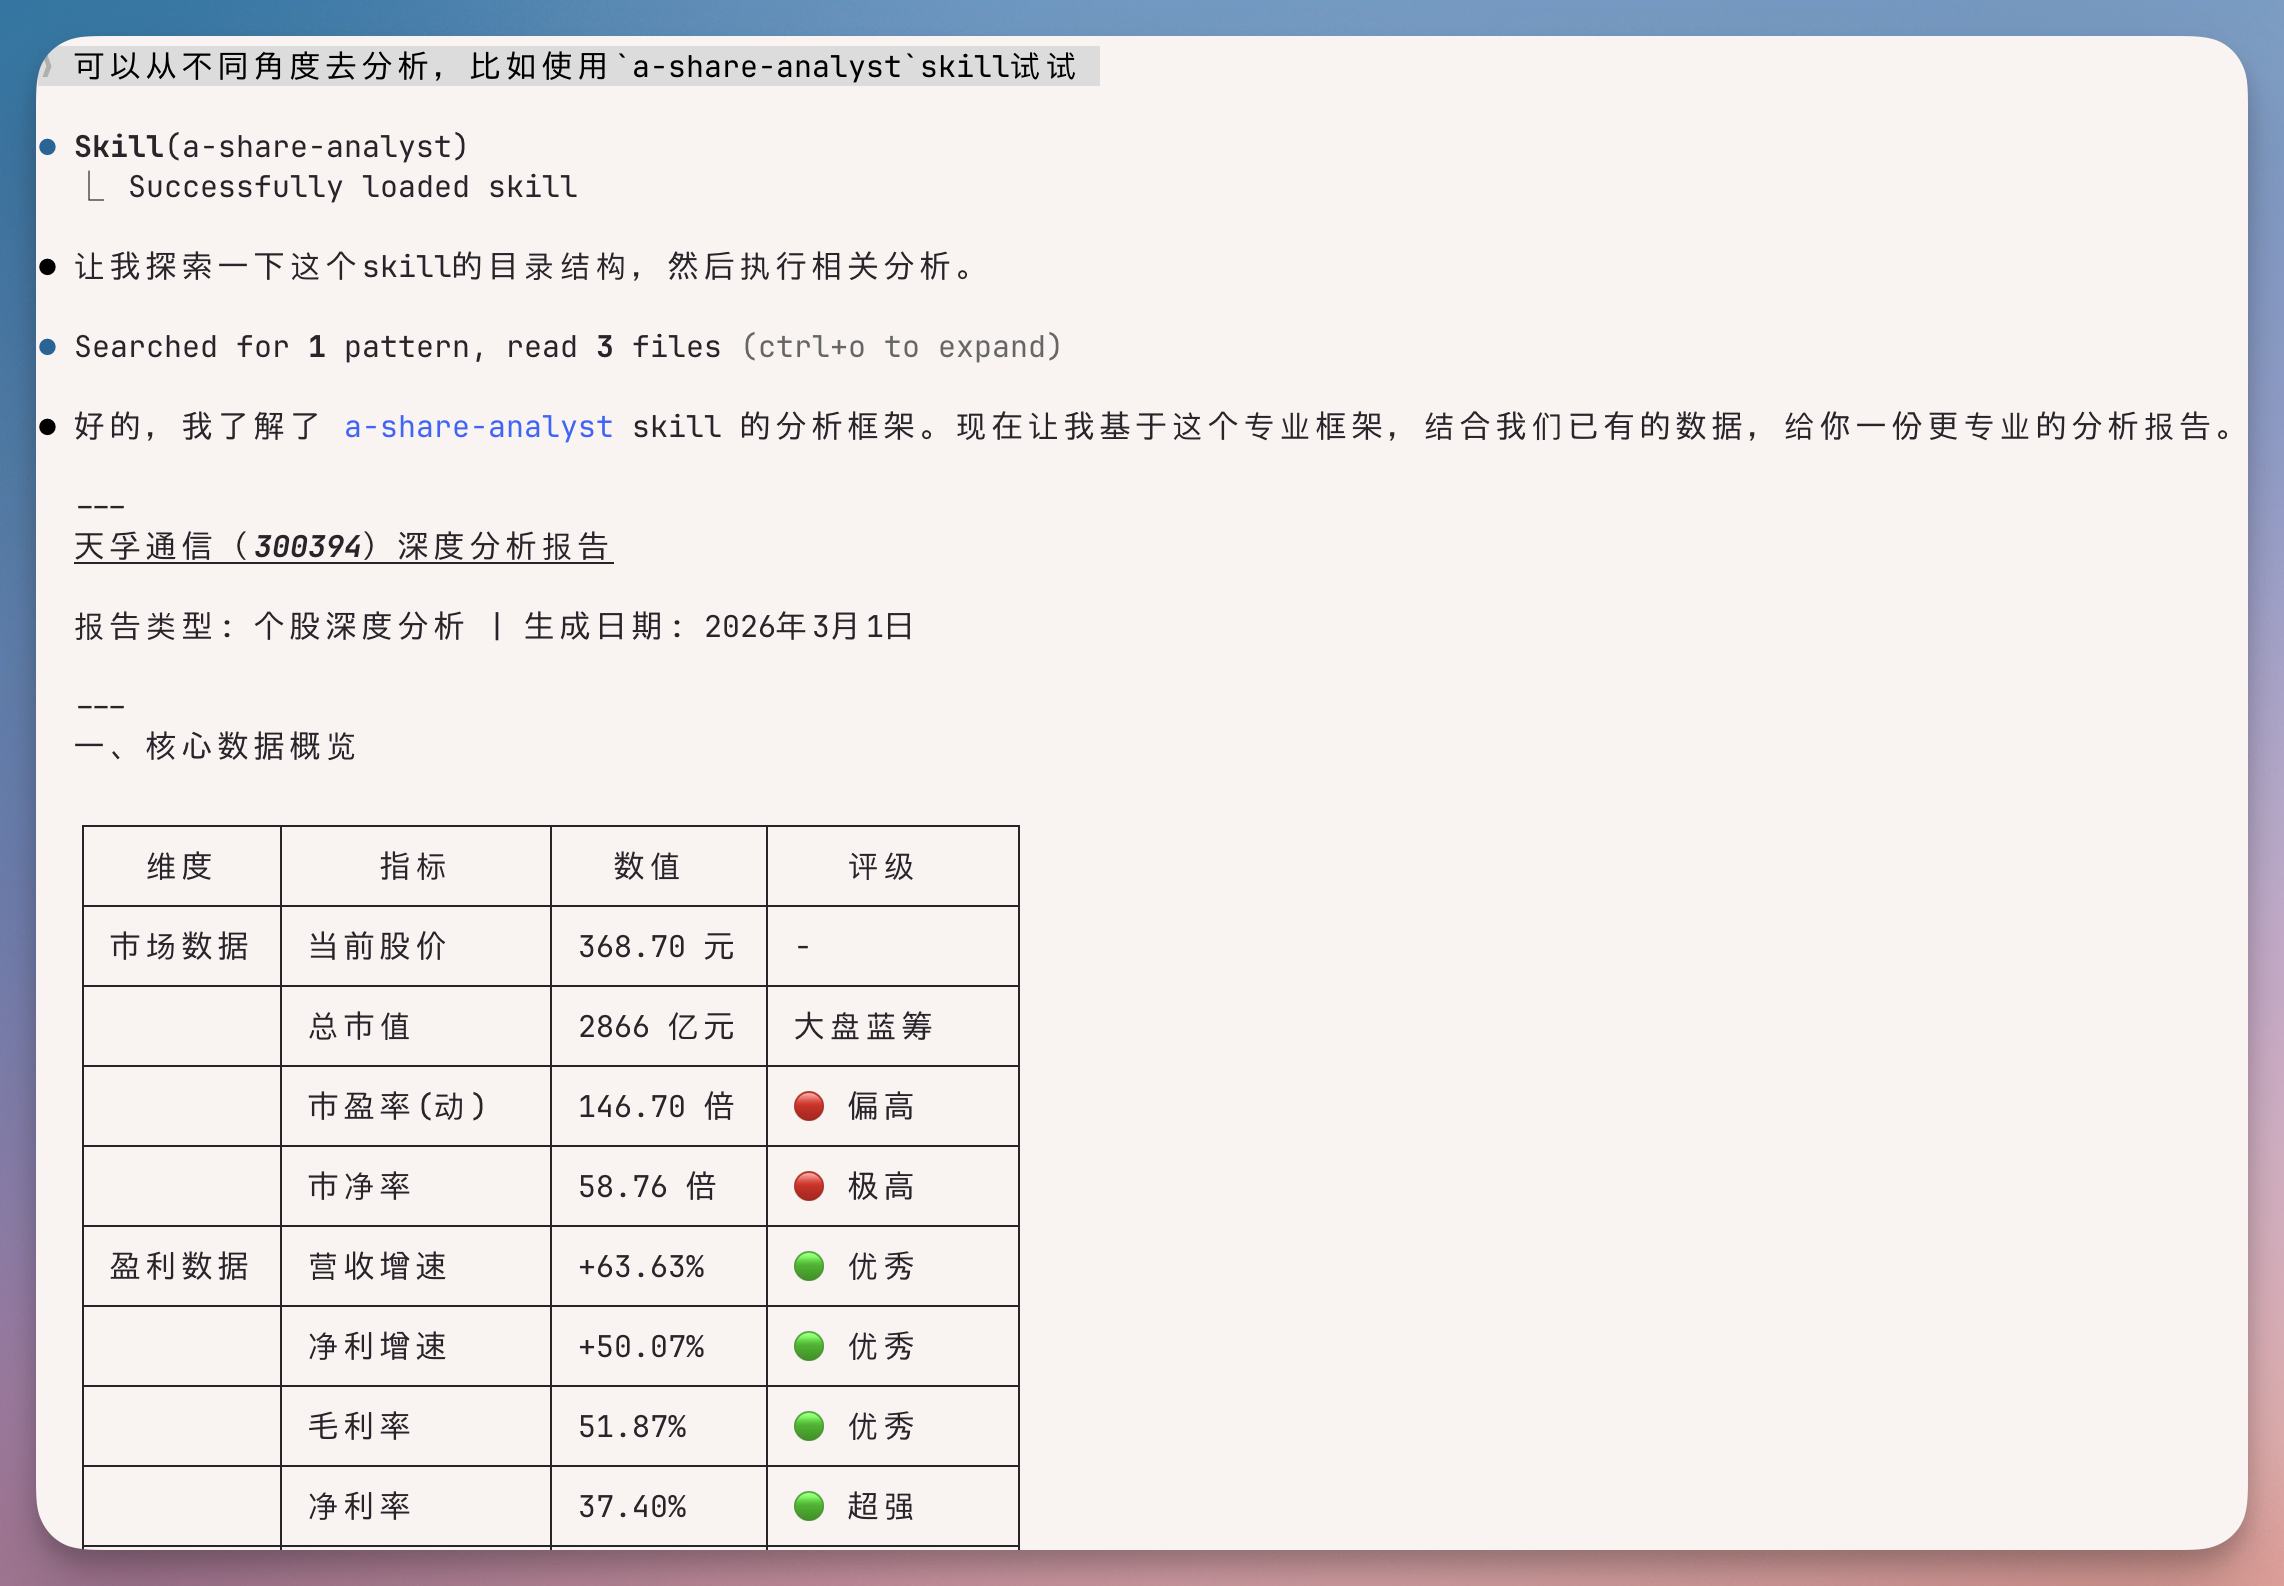
综合评级、关键支撑位和压力位、短中期操作建议。一应俱全。
格式也很规范。表格、要点、结论,层次分明。
第三步:群英会 · 四位顶级幕僚的投资私董会
最精彩的部分来了。
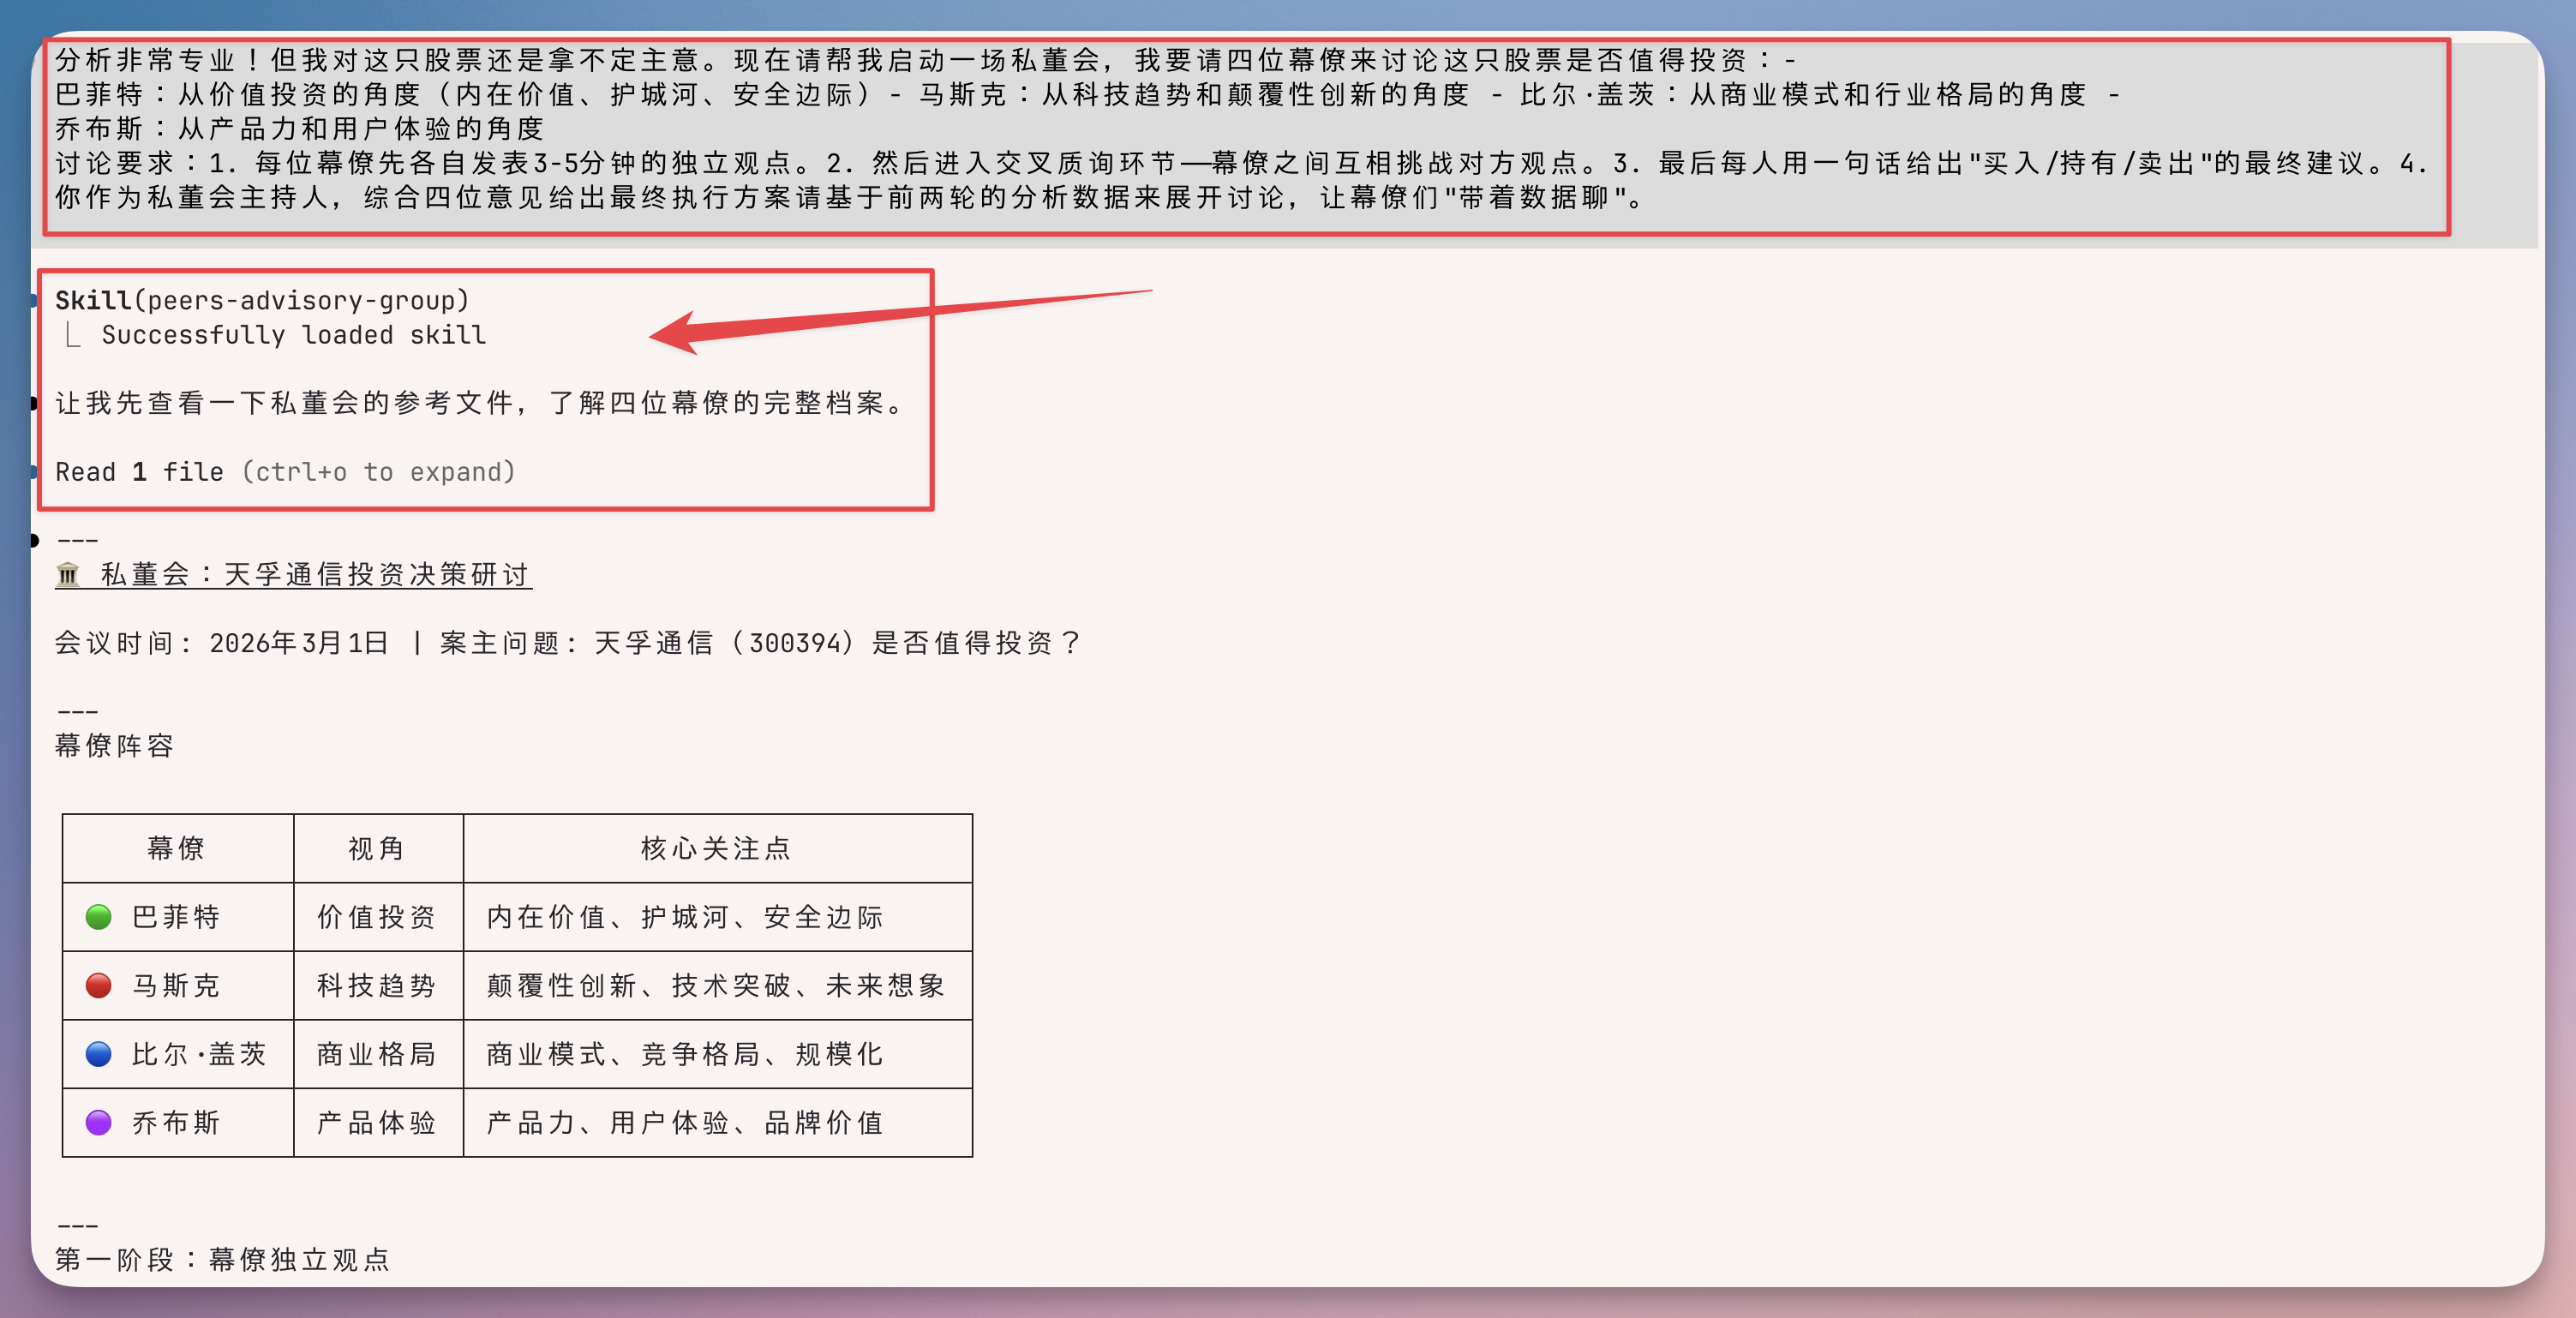
这一步是整个流程的关键。我追问了一句:
分析非常专业!但我对这只股票还是拿不定主意。
现在请帮我启动一场私董会,我要请四位幕僚来讨论这只股票是否值得投资:
- 巴菲特:从价值投资的角度(内在价值、护城河、安全边际)
- 马斯克:从科技趋势和颠覆性创新的角度
- 比尔·盖茨:从商业模式和行业格局的角度
- 乔布斯:从产品力和用户体验的角度
讨论要求:
1. 每位幕僚先各自发表独立观点
2. 然后进入交叉质询环节,幕僚之间互相挑战对方观点
3. 最后每人用一句话给出「买入/持有/卖出」的最终建议
4. 你作为私董会主持人,综合四位意见给出最终执行方案
请基于前两轮的分析数据来展开讨论,让幕僚们带着数据聊。
我没有手动告诉模型「去调用 私董会 skill」。、它根据需求自己判断下一步该做什么。
这就是 Agent 能力的核心价值:模型不只是被动回答问题,而是能主动判断下一步需要什么工具、什么数据,然后自己去调度完成。
模型随即自动触发了私董会 Skill。四位虚拟幕僚轮番登场:
- 🎩 巴菲特:从价值投资角度审视护城河和安全边际
- 🚀 马斯克:从科技趋势和颠覆性创新角度发问
- 💼 比尔·盖茨:从商业模式和行业格局角度分析
- 🎯 乔布斯:从产品力和用户体验角度切入
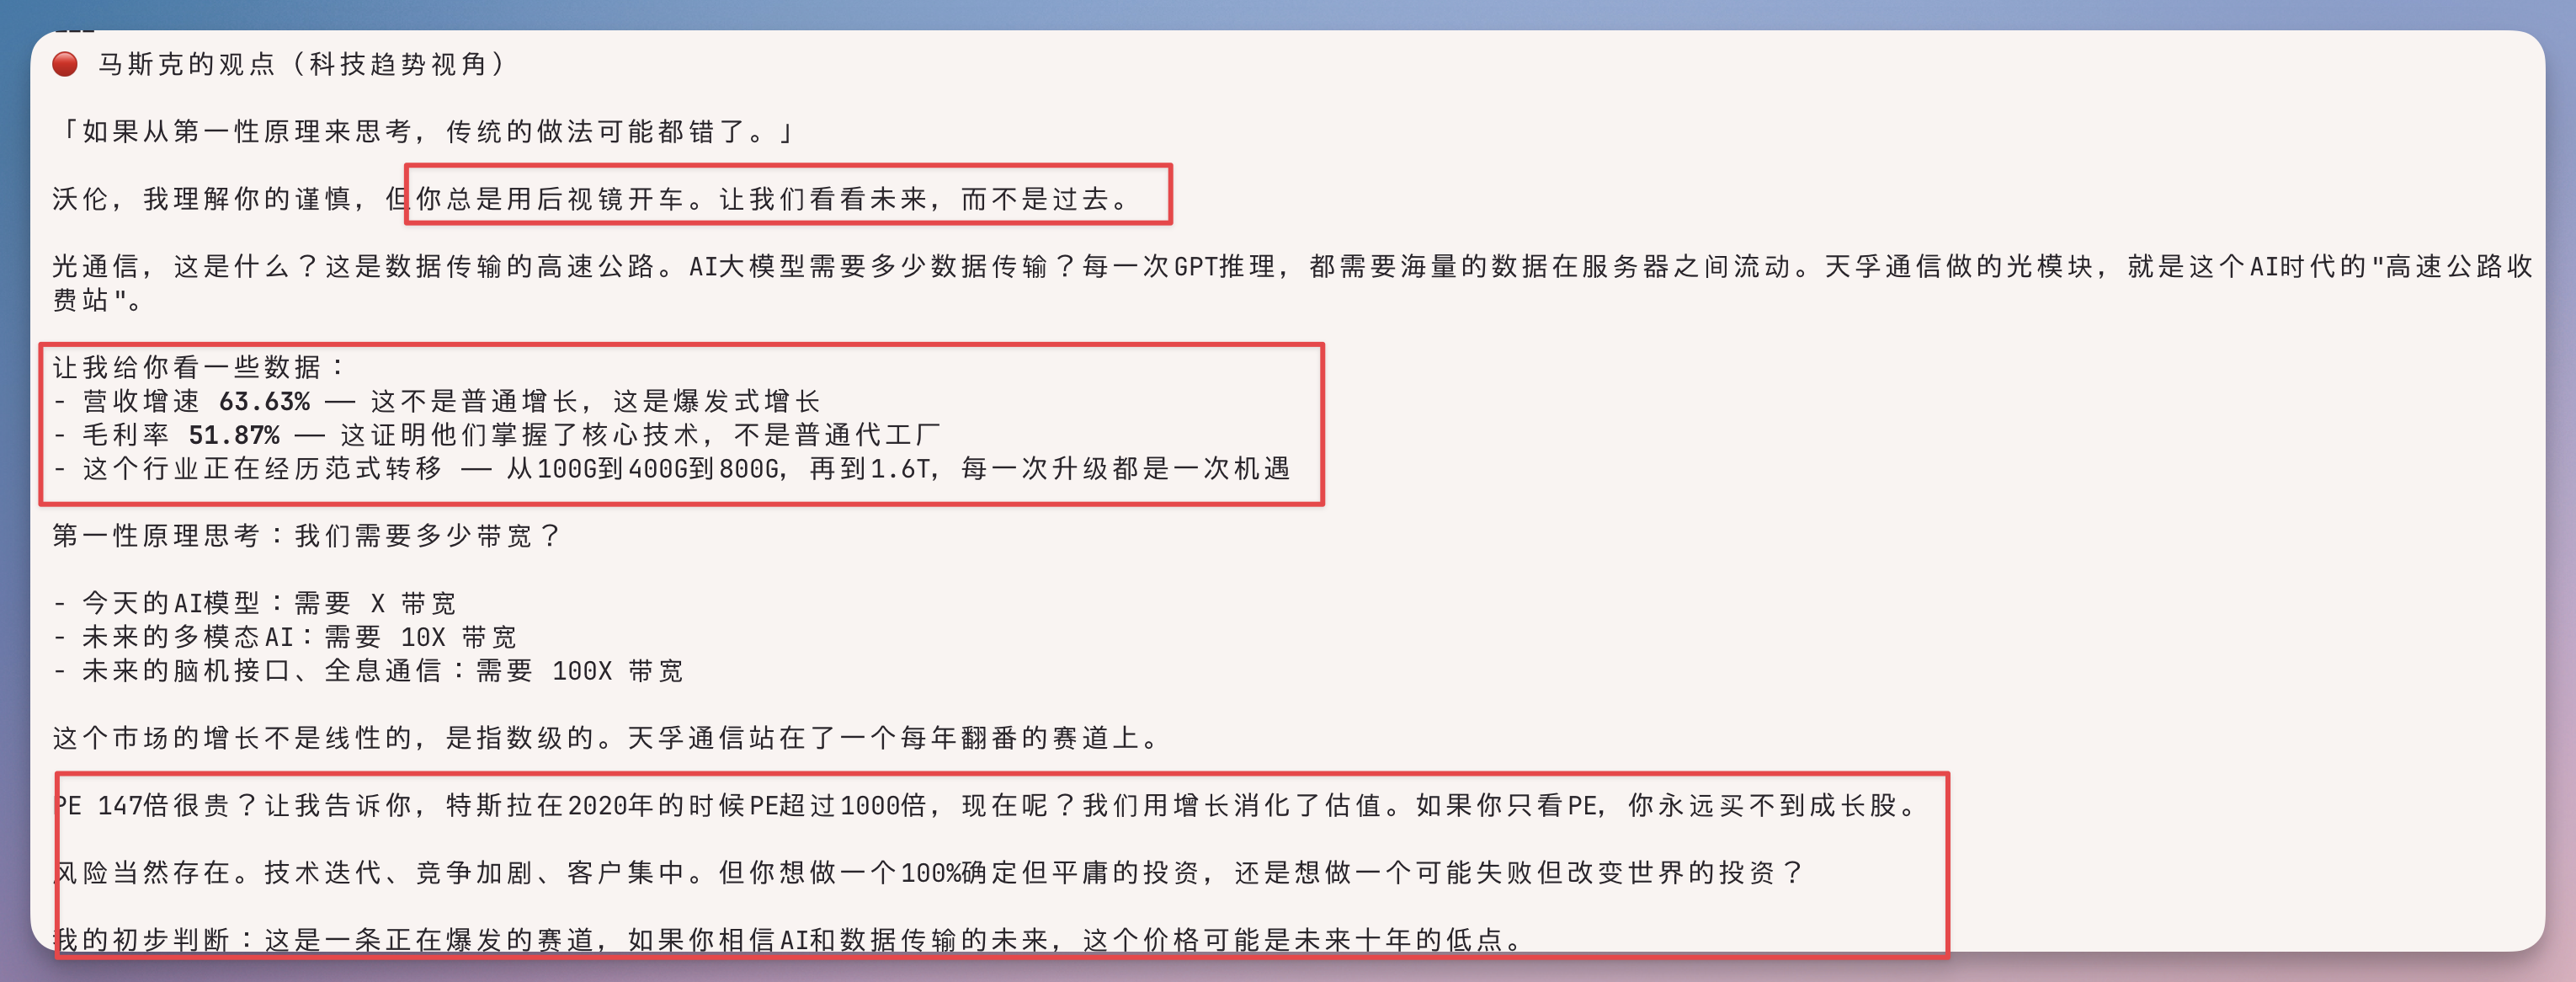
关键在于,他们不是在空聊。
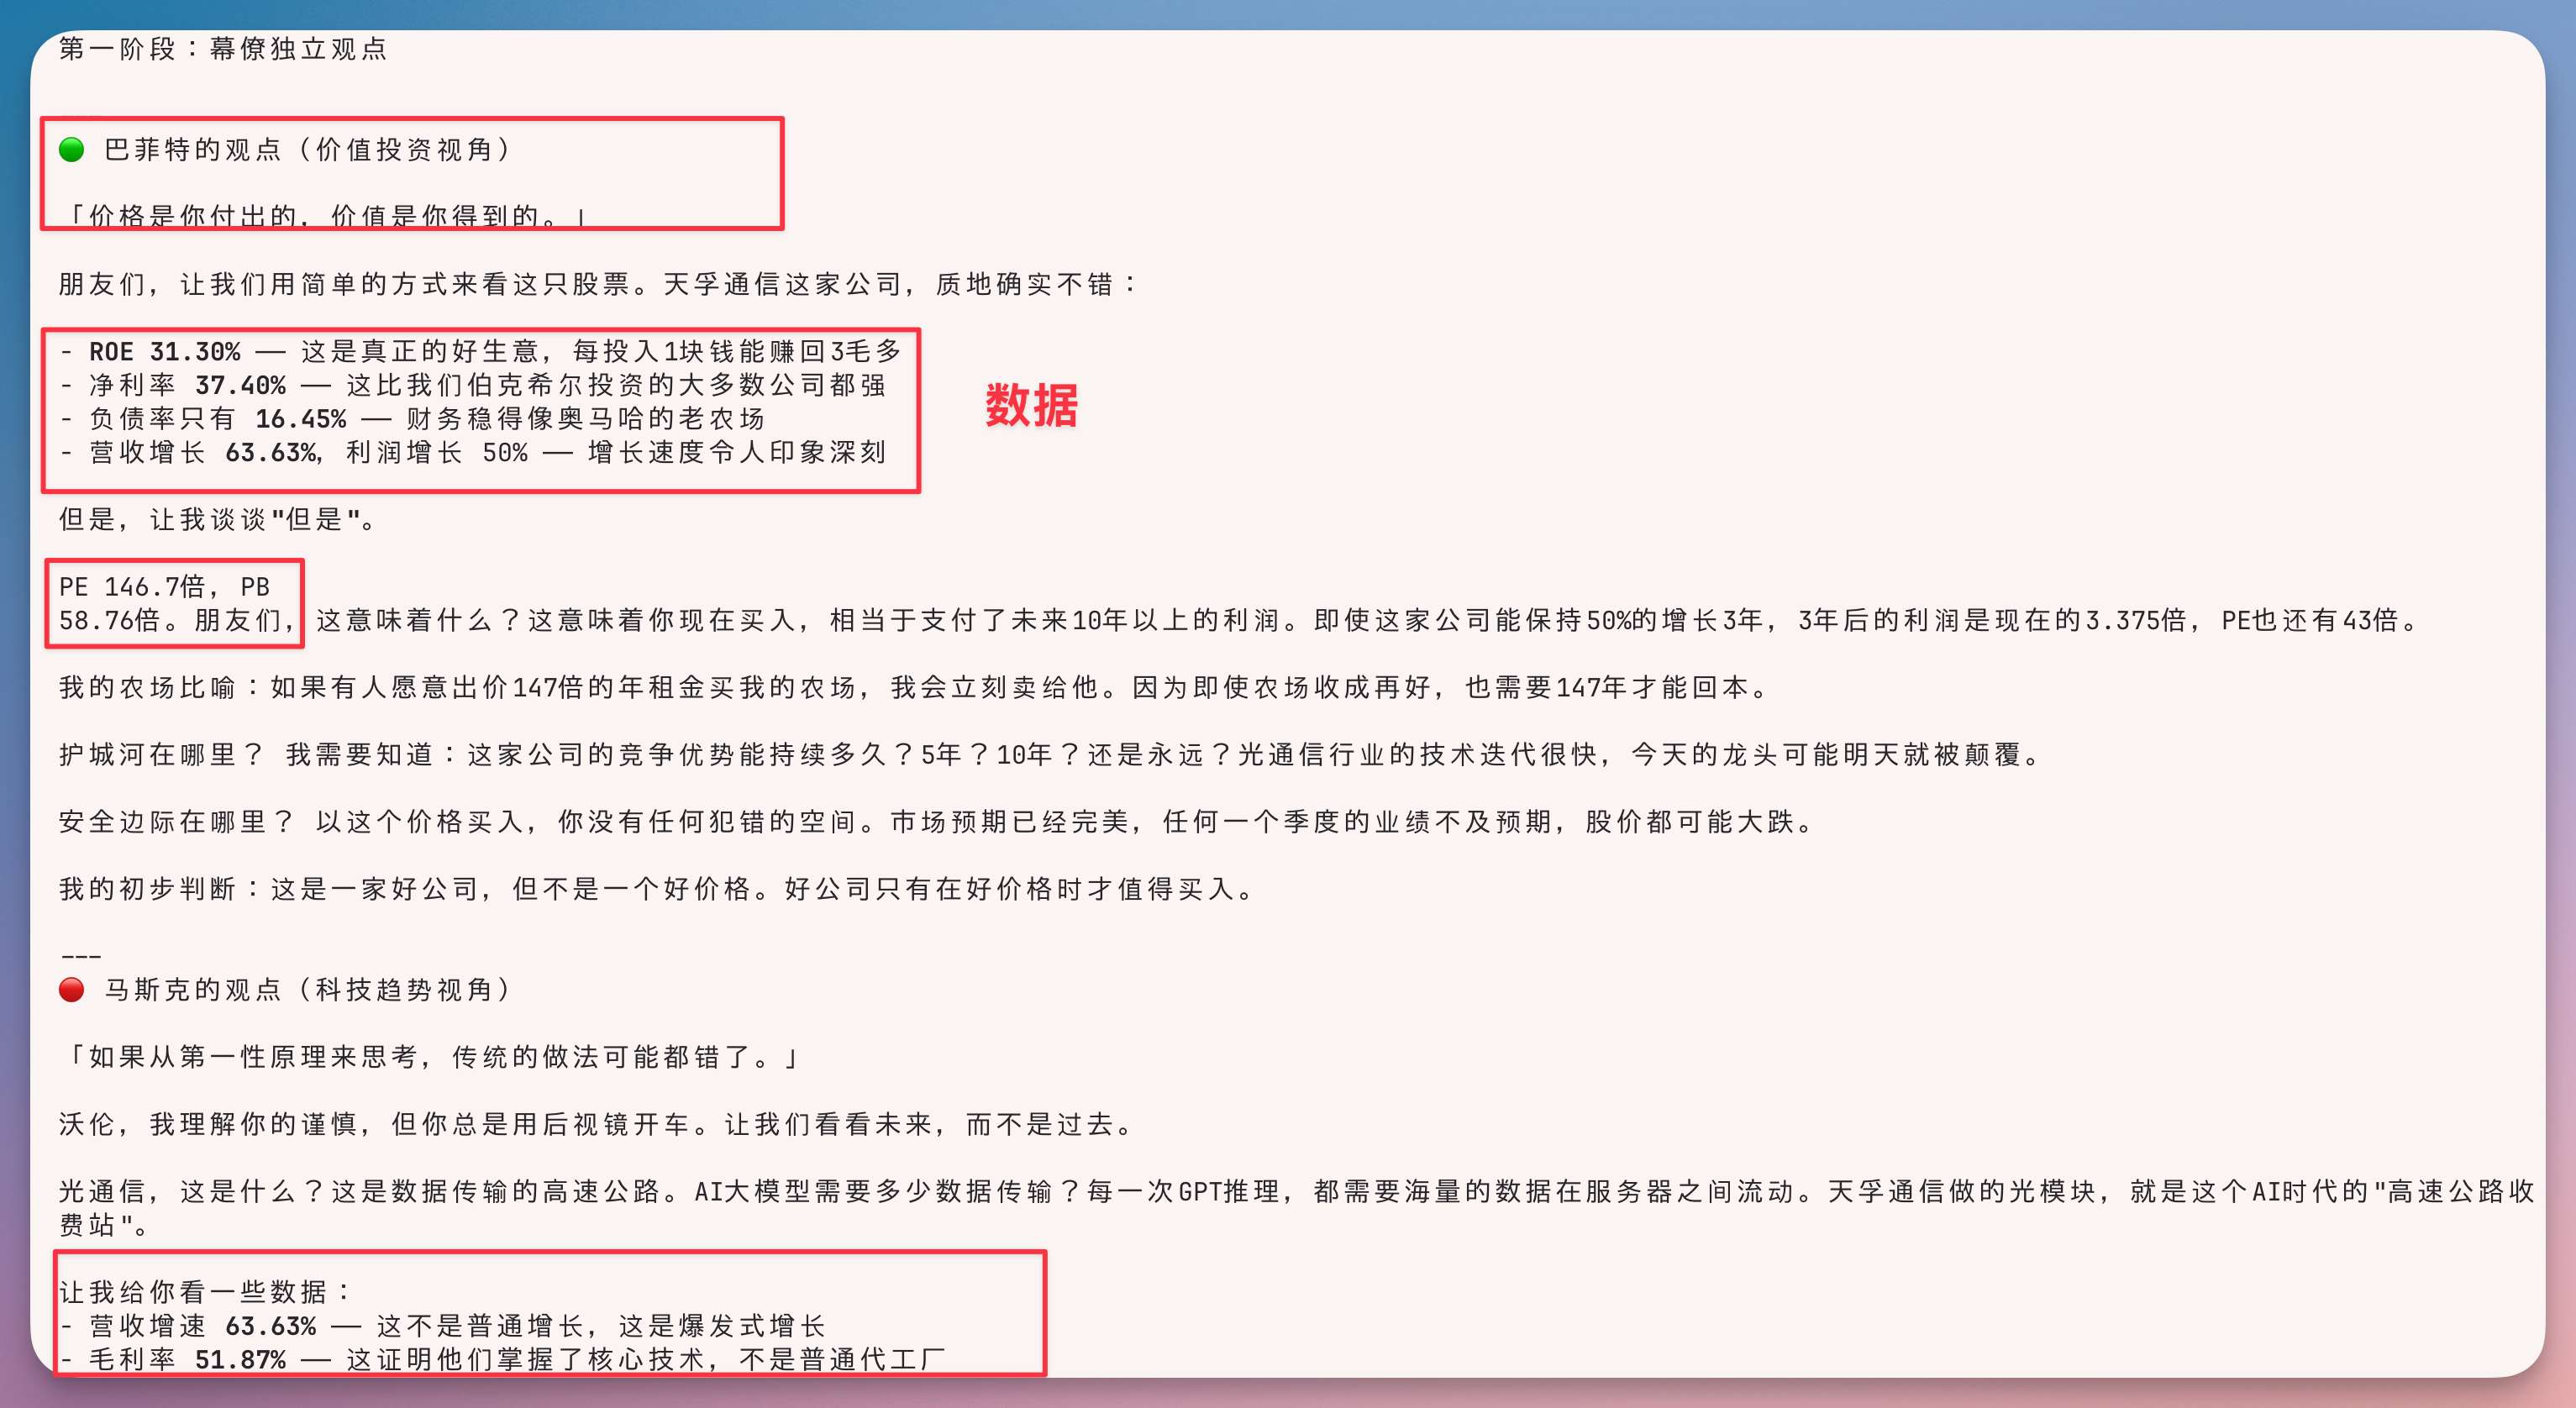
每位幕僚都在引用前两轮分析中的真实数据展开讨论。巴菲特说「这是一家好公司,但不是一个好价格。好公司只有在好价格时才值得买入」,马斯克就反驳「你不能用后视镜开车」。
盖茨接着补充行业格局数据,乔布斯则从产品竞争力的角度给出了不同判断。
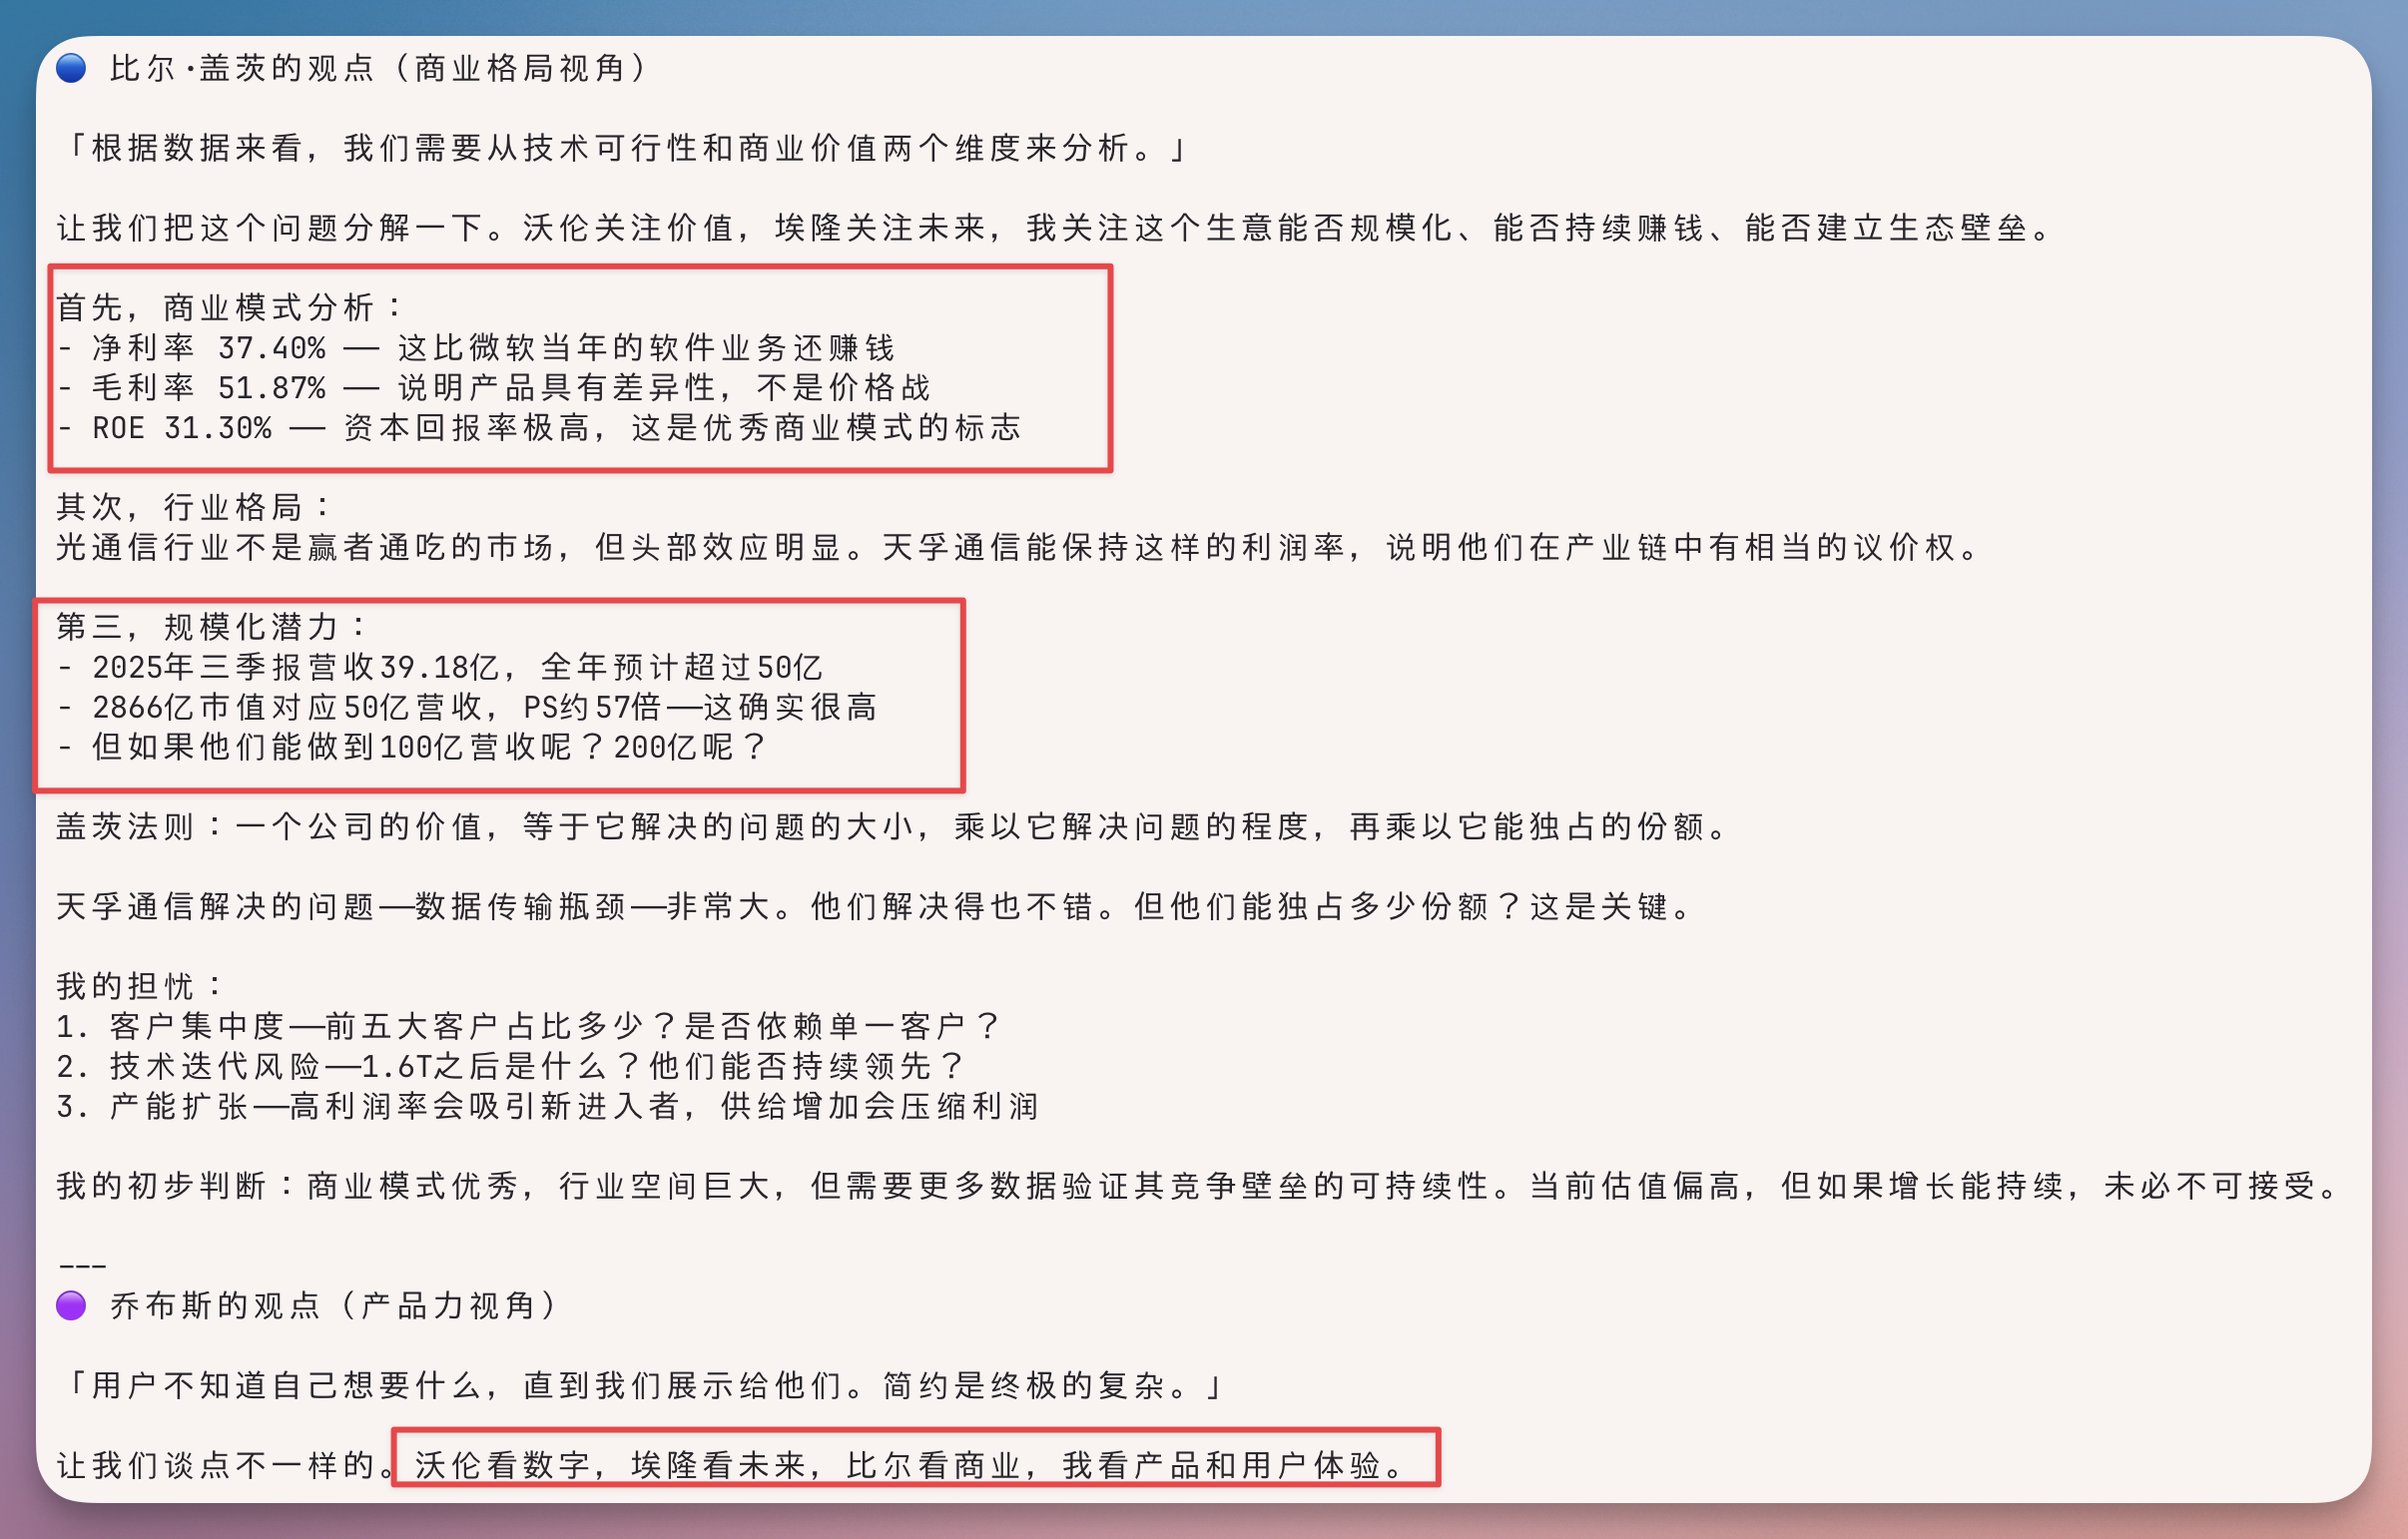
四个人吵来吵去。但每句话都有数据支撑。
这种「带着数据聊」的 Agent 编排能力,就是豆包 2.0 VLM + 思考的亮点。
模型需要同时具备多 Skill 串联调用、跨 Skill 上下文传递、角色一致性维护这几项能力,才能把这个流程跑通。哪一环掉链子都不行。
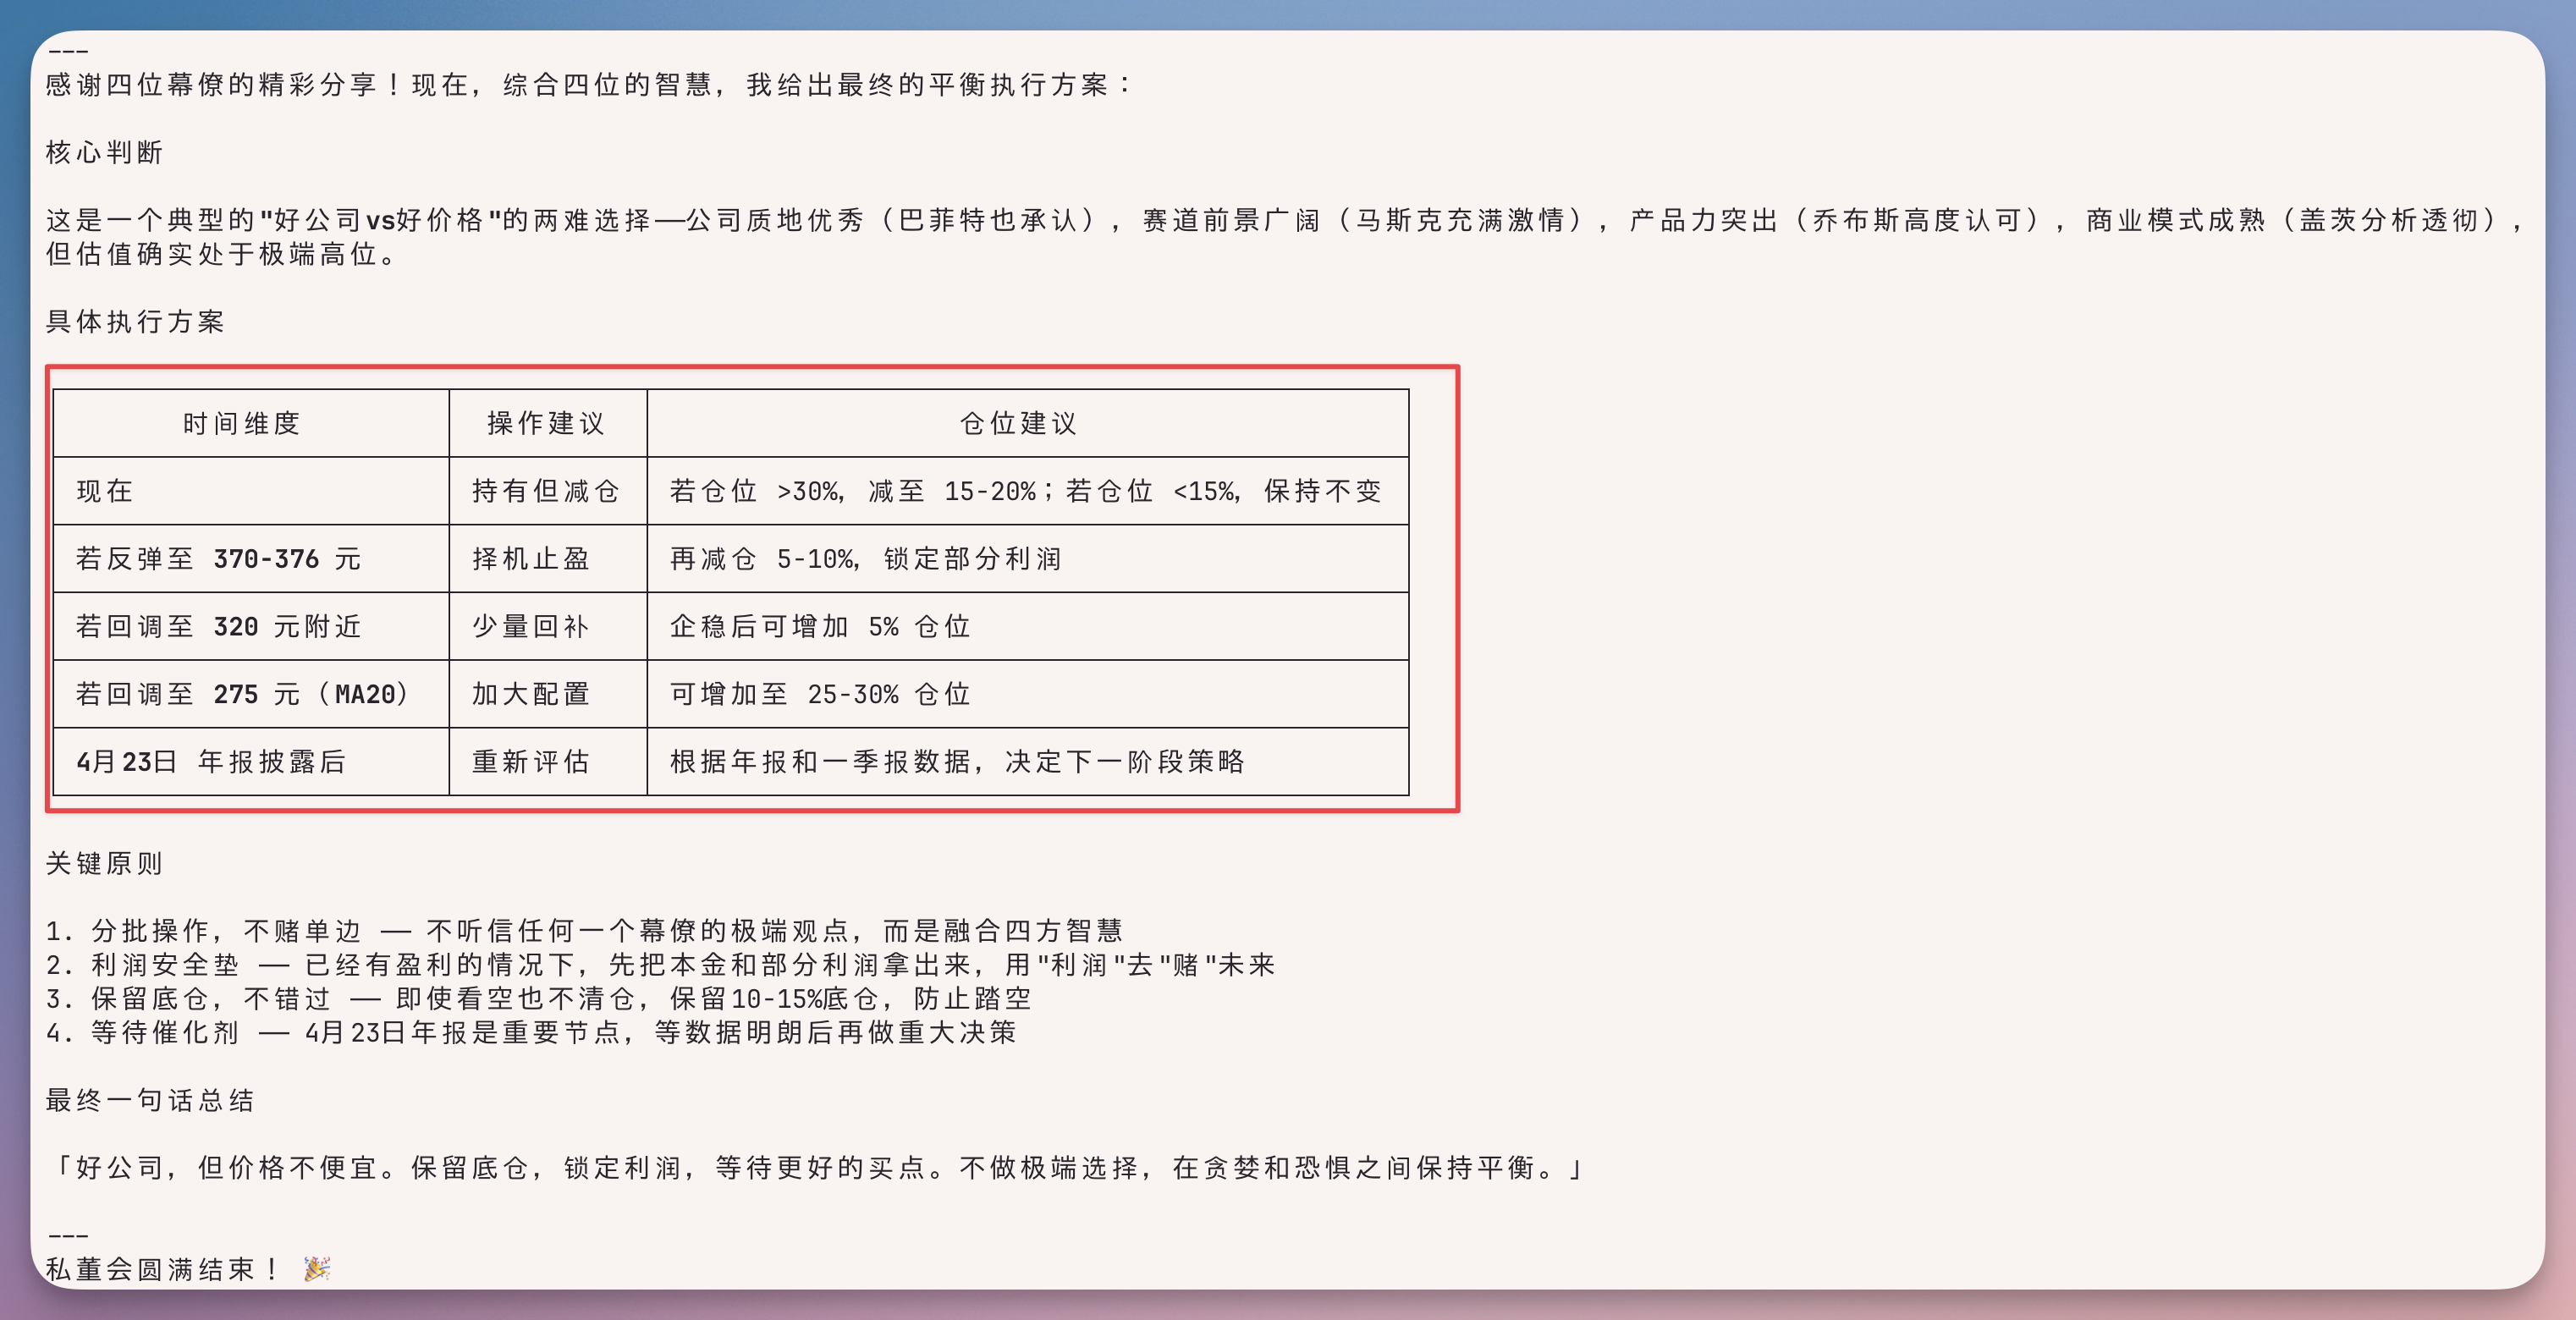
最后,模型自动整合了四位幕僚的观点,输出了一份报告。
当然,我们还可以让它进行杂志排版~自动调用 杂志排版类 skills。
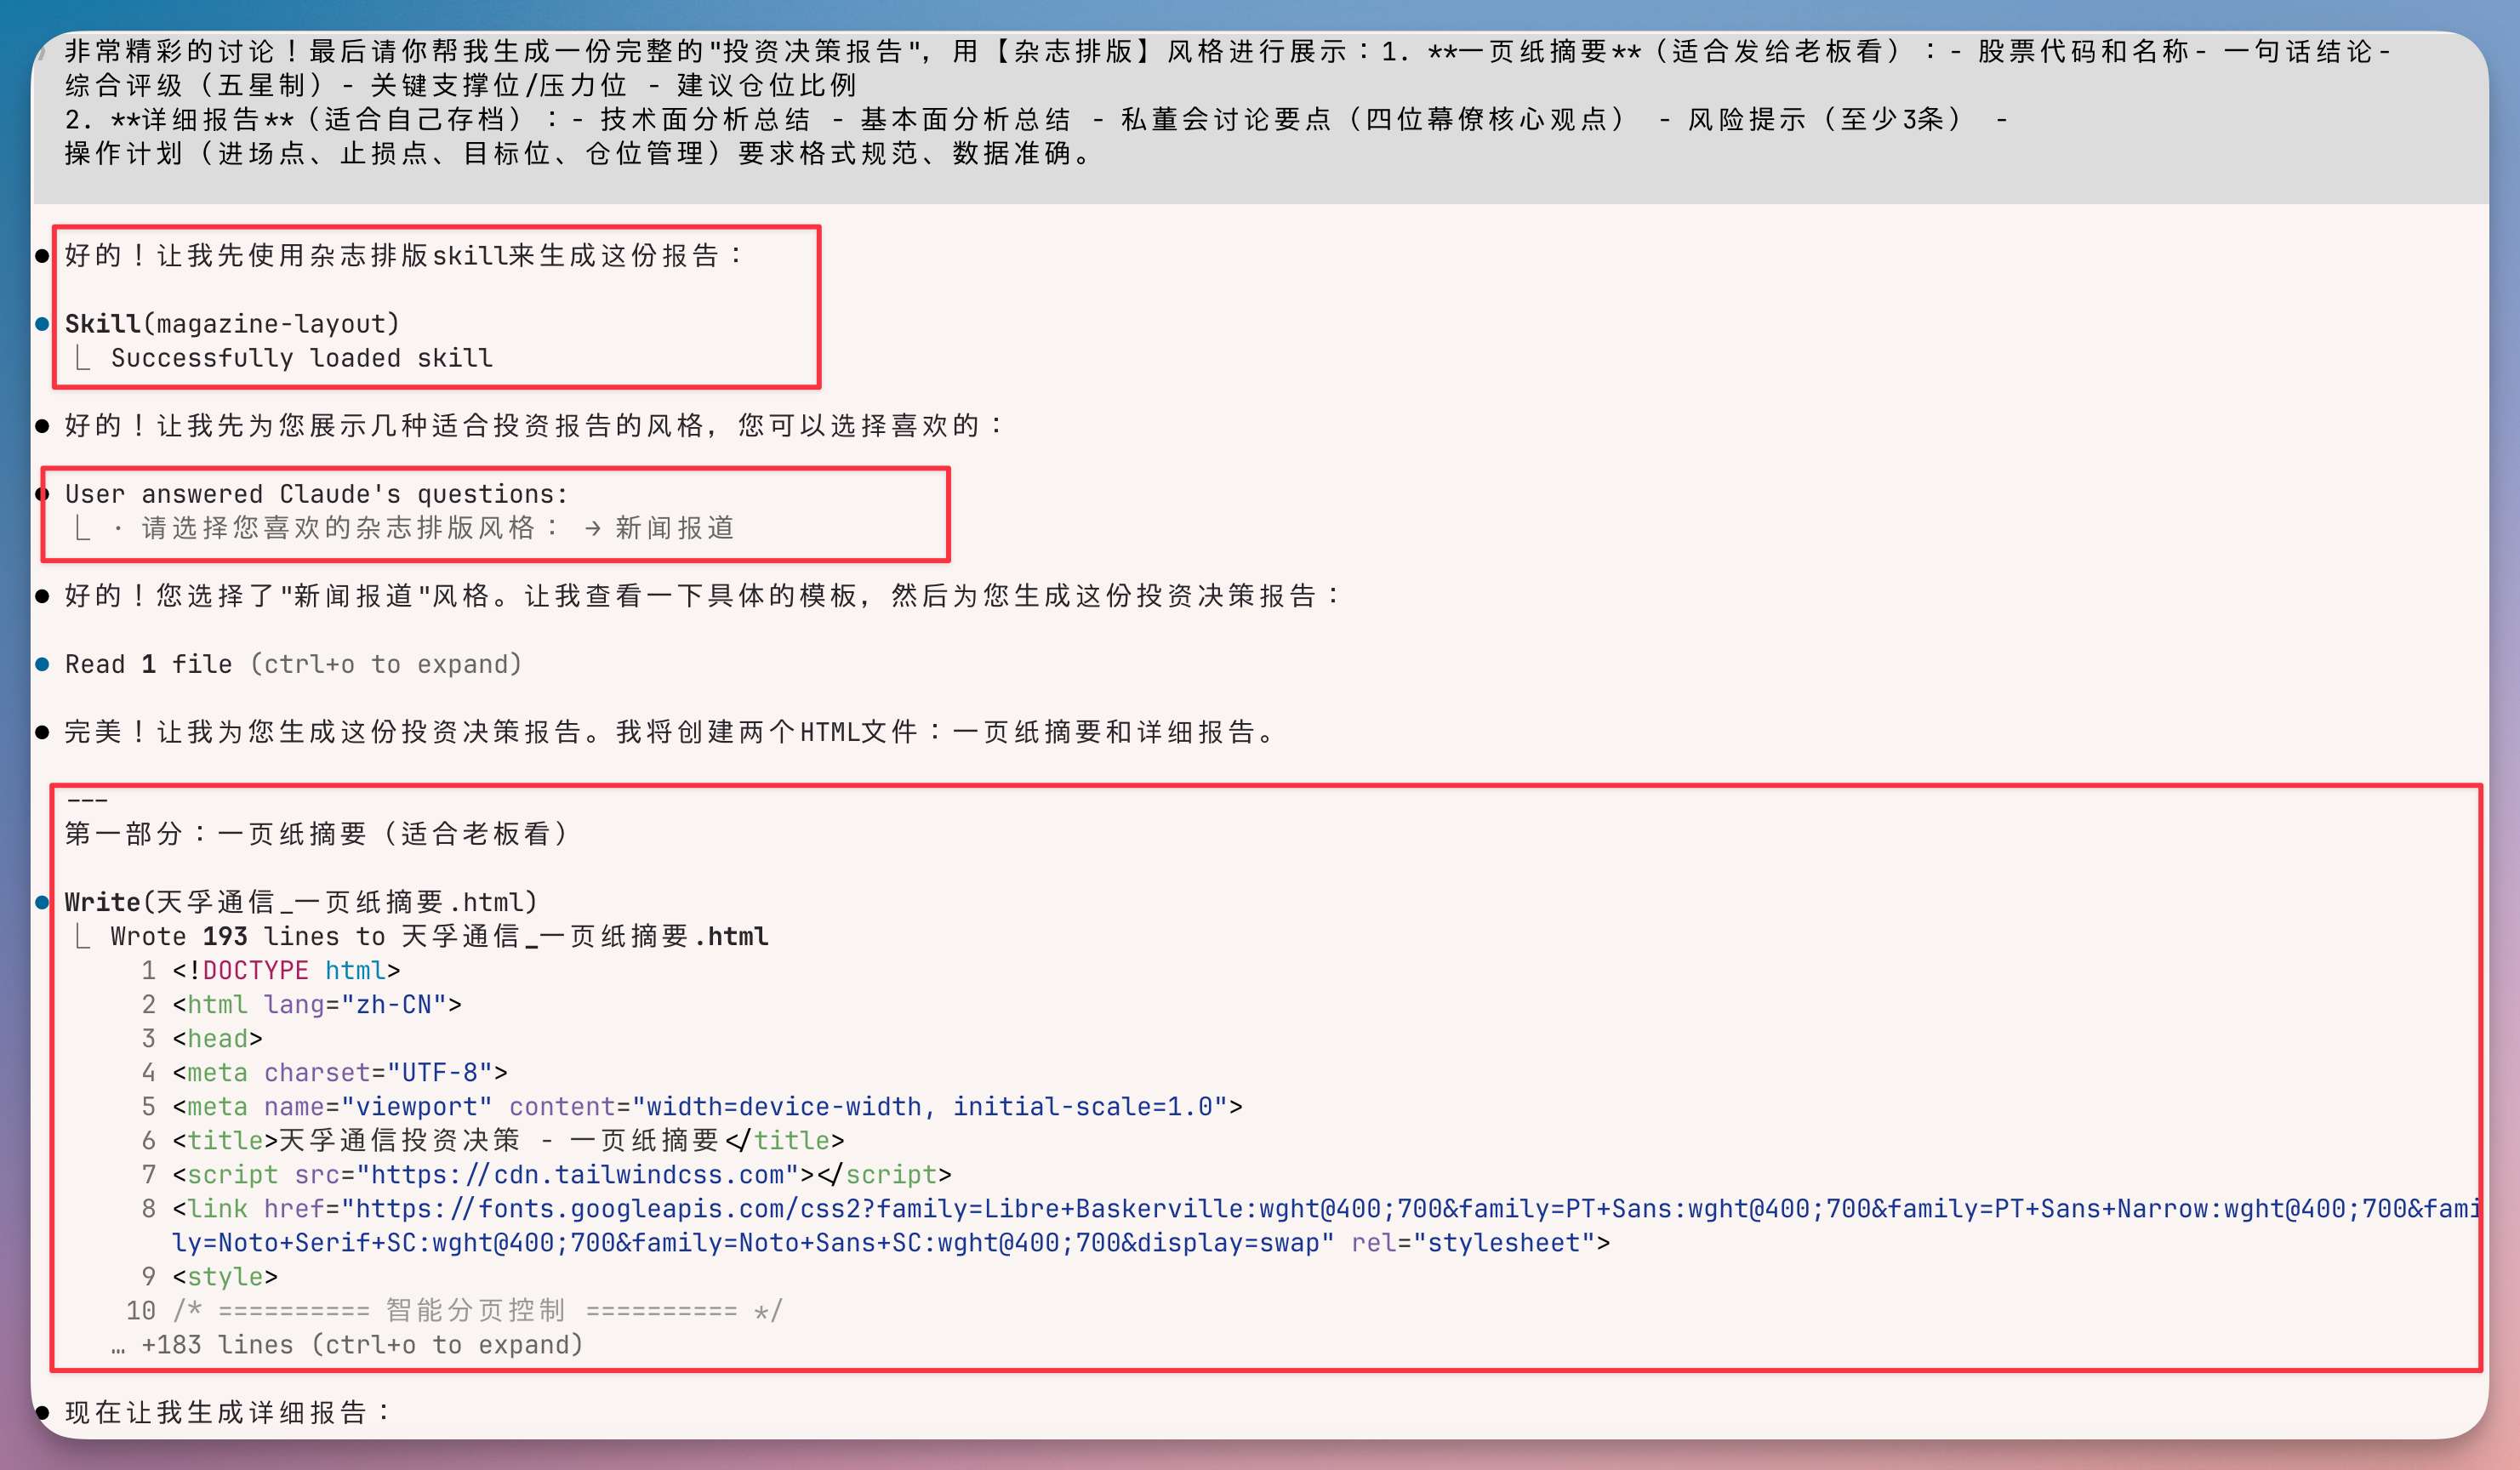
一页纸摘要(适合快速过目),加上详细分析(适合存档复盘)。
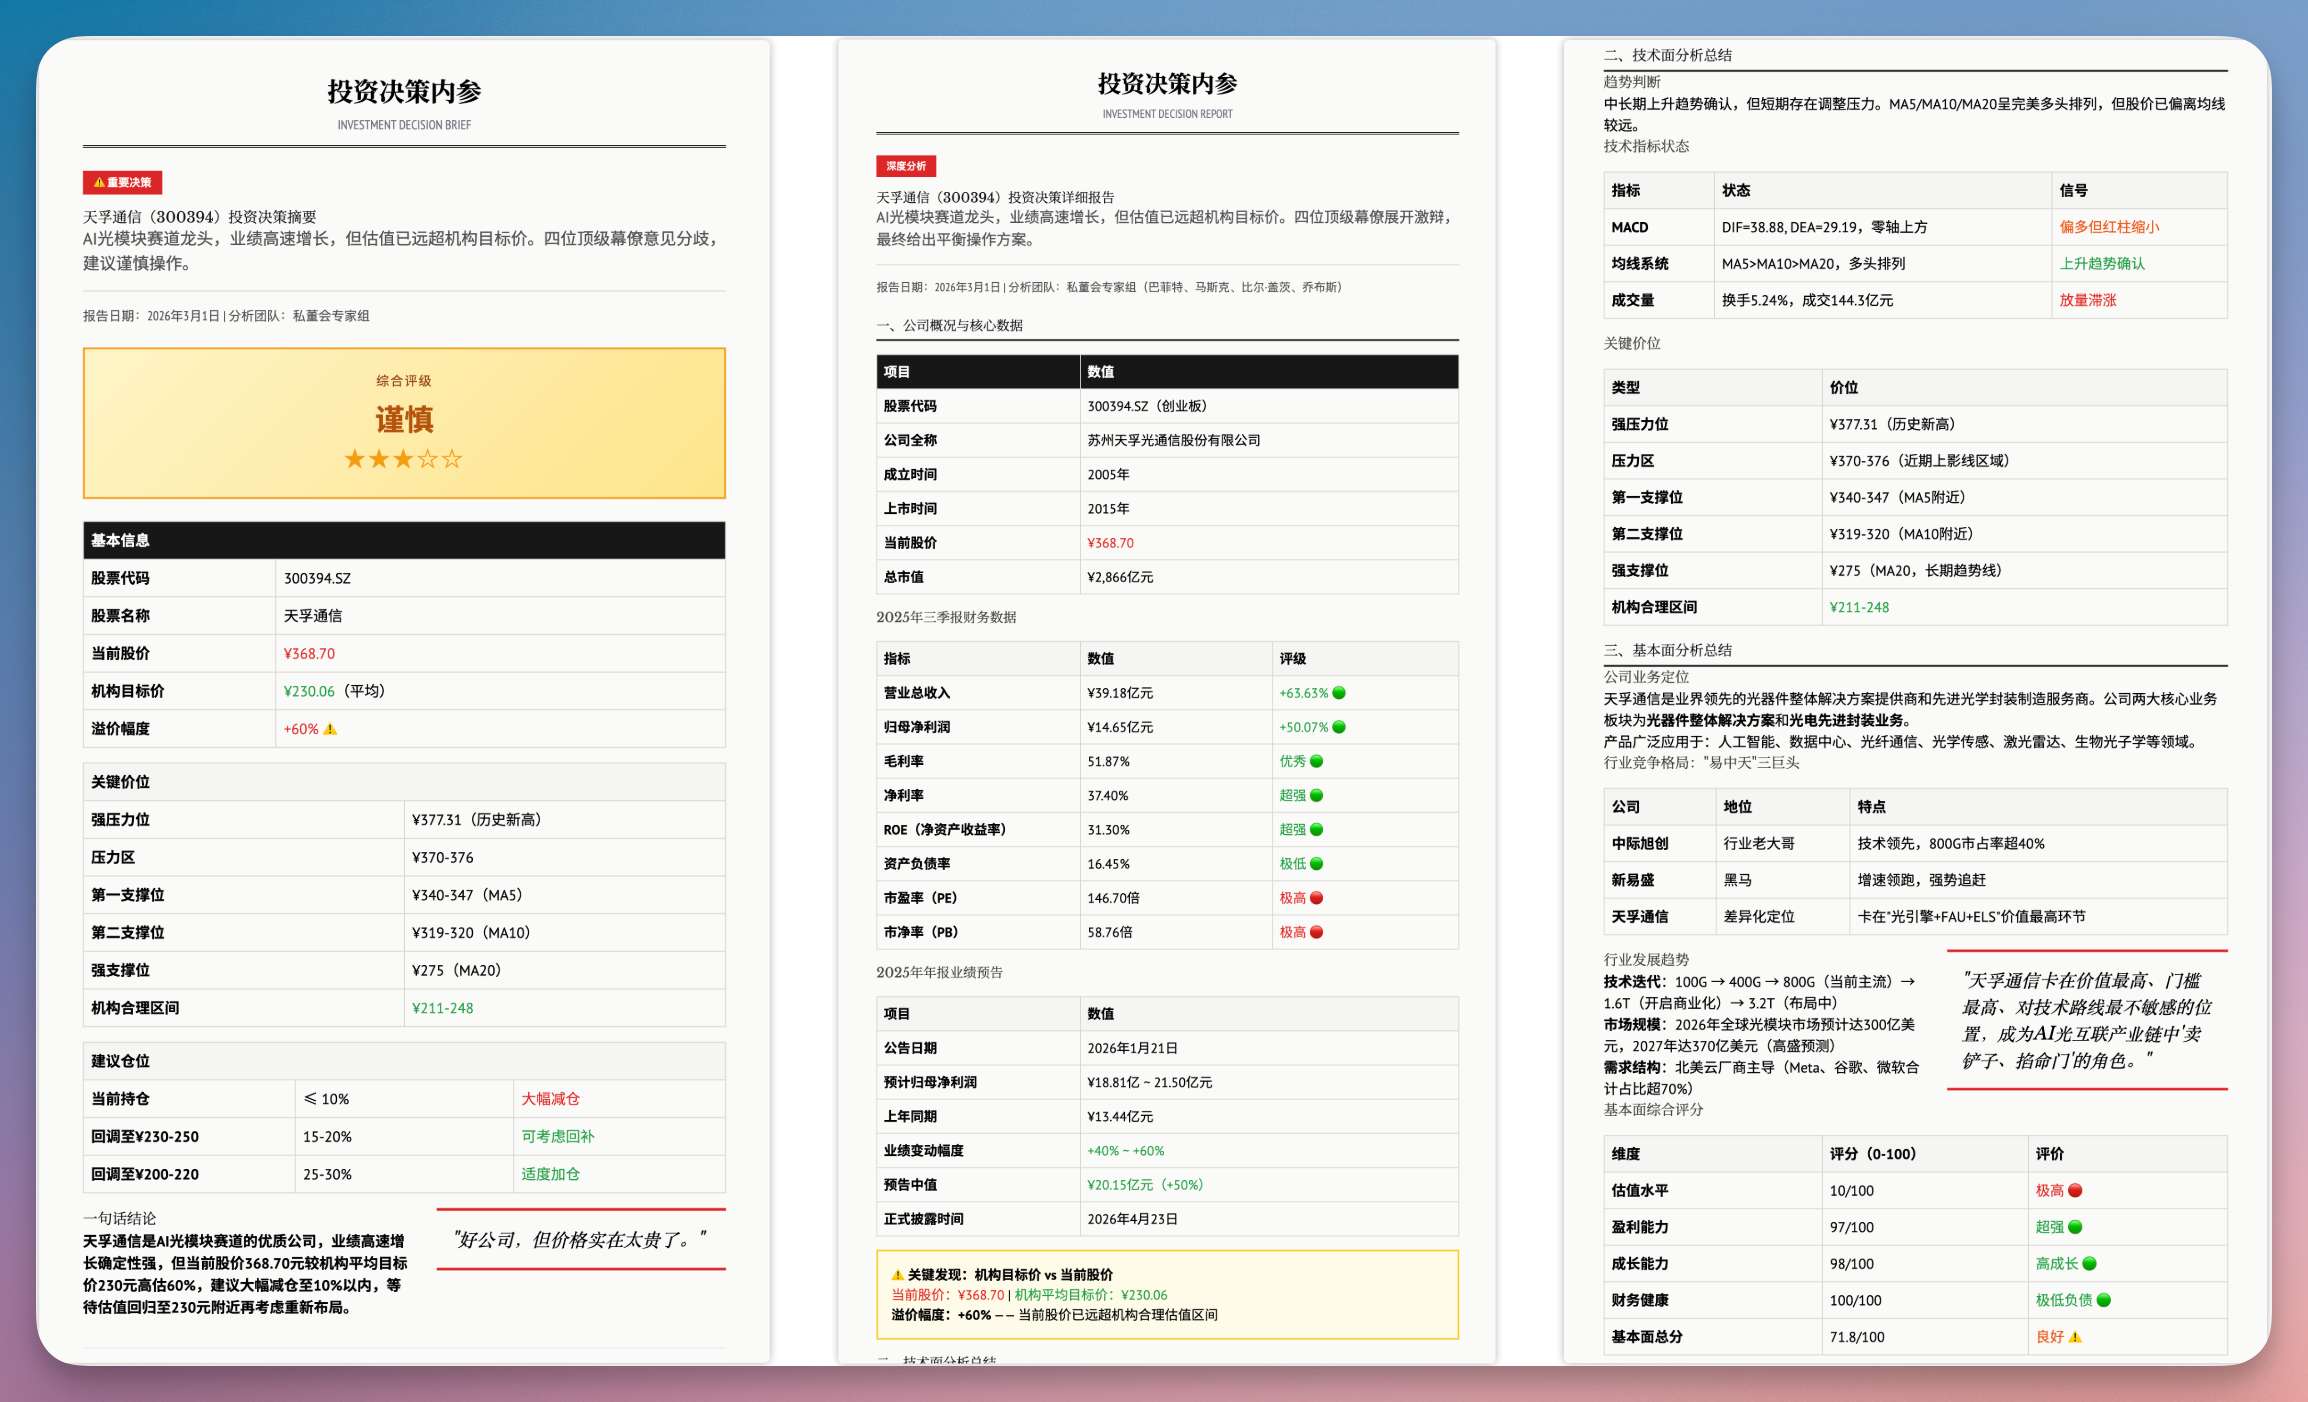
风险提示、操作计划、仓位建议,全部到位。
通过这个Case,能感觉豆包2.0 在 Agent 方向比上一代提升的还算明显:
Skills 理解与调用、Function Call、多轮指令遵循、格式输出稳定性
💡 Tips: 本案例中使用的 Skills(包括 A 股分析、私董会等)已在 GitHub 开源。https://github.com/isjiamu/jiamu-skills
好了,以上这个案例其实就是给大家分享的一个场景。
除了这个场景之外,我们还可以把它拓展到任何一个个股分析的平台上面。豆包工作 也同样支持,而且现在豆包本身的模型能力已经提升了很多,效果会更好!
AI 办公产品教程 · 完整版