
31 · 自媒体场景
长音视频怎样完成转写、字幕和高光切片
做内容的人都经历过这种折磨:同事丢来一段会议录音、直播回放或者访谈视频,让你整理一下,顺便剪几条能发的。
做内容的人都经历过这种折磨:同事丢来一段会议录音、直播回放或者访谈视频,让你整理一下,顺便剪几条能发的。
这个过程最费精力和时间的就是反复拖进度条。比如:听到一个产品名不确定,退回去;看到一句像金句,又得重新找开头和结尾;最后字幕做出来了,还要担心时间轴重叠、数字写错、片段断章取义。
接下来我就在豆包工作里用一段 4 分 47 秒的真实中文口播,把整条链路跑了一遍,带大家看看这种情况应该怎么做。
原始音频
→ 带时间码逐字稿
→ 清洁稿
→ 111 条 SRT 字幕
→ 10 个待人工回听点
→ 5 个高光候选
→ Top 3 排序
→ 人工确认后再决定是否剪辑
注意,这次实测素材是 4 分 47 秒。更长素材可以沿用同一流程,但要分段抽查、保留原始时间码,批量导出前再回听一遍。
先选工具
| 任务 | 最优组合 | 为什么 |
|---|---|---|
| 音频转逐字稿、清洁稿和 SRT | 豆包工作本地文件理解 + asr-subtitles + 文件生成与自检 |
不用额外授权外部账号,能直接从音频产出时间码和文件 |
| 从文本筛高光 | 新工作任务 + 内置文本分析 | 只看清洁稿和听辨清单,不会边筛边重新猜音频 |
| 真正剪辑、导出 | 人工确认后再接视频工具 | 高光候选不是成片,先回听能避免把人名、数字和产品名剪错 |
我也看了 Descript 连接器。它覆盖导入、转写、编辑和发布,但需要连接外部账号并共享相应信息。有点麻烦,感兴趣的朋友可以去用一用。
任务一:先得到能校对的文字,而不是一篇漂亮摘要
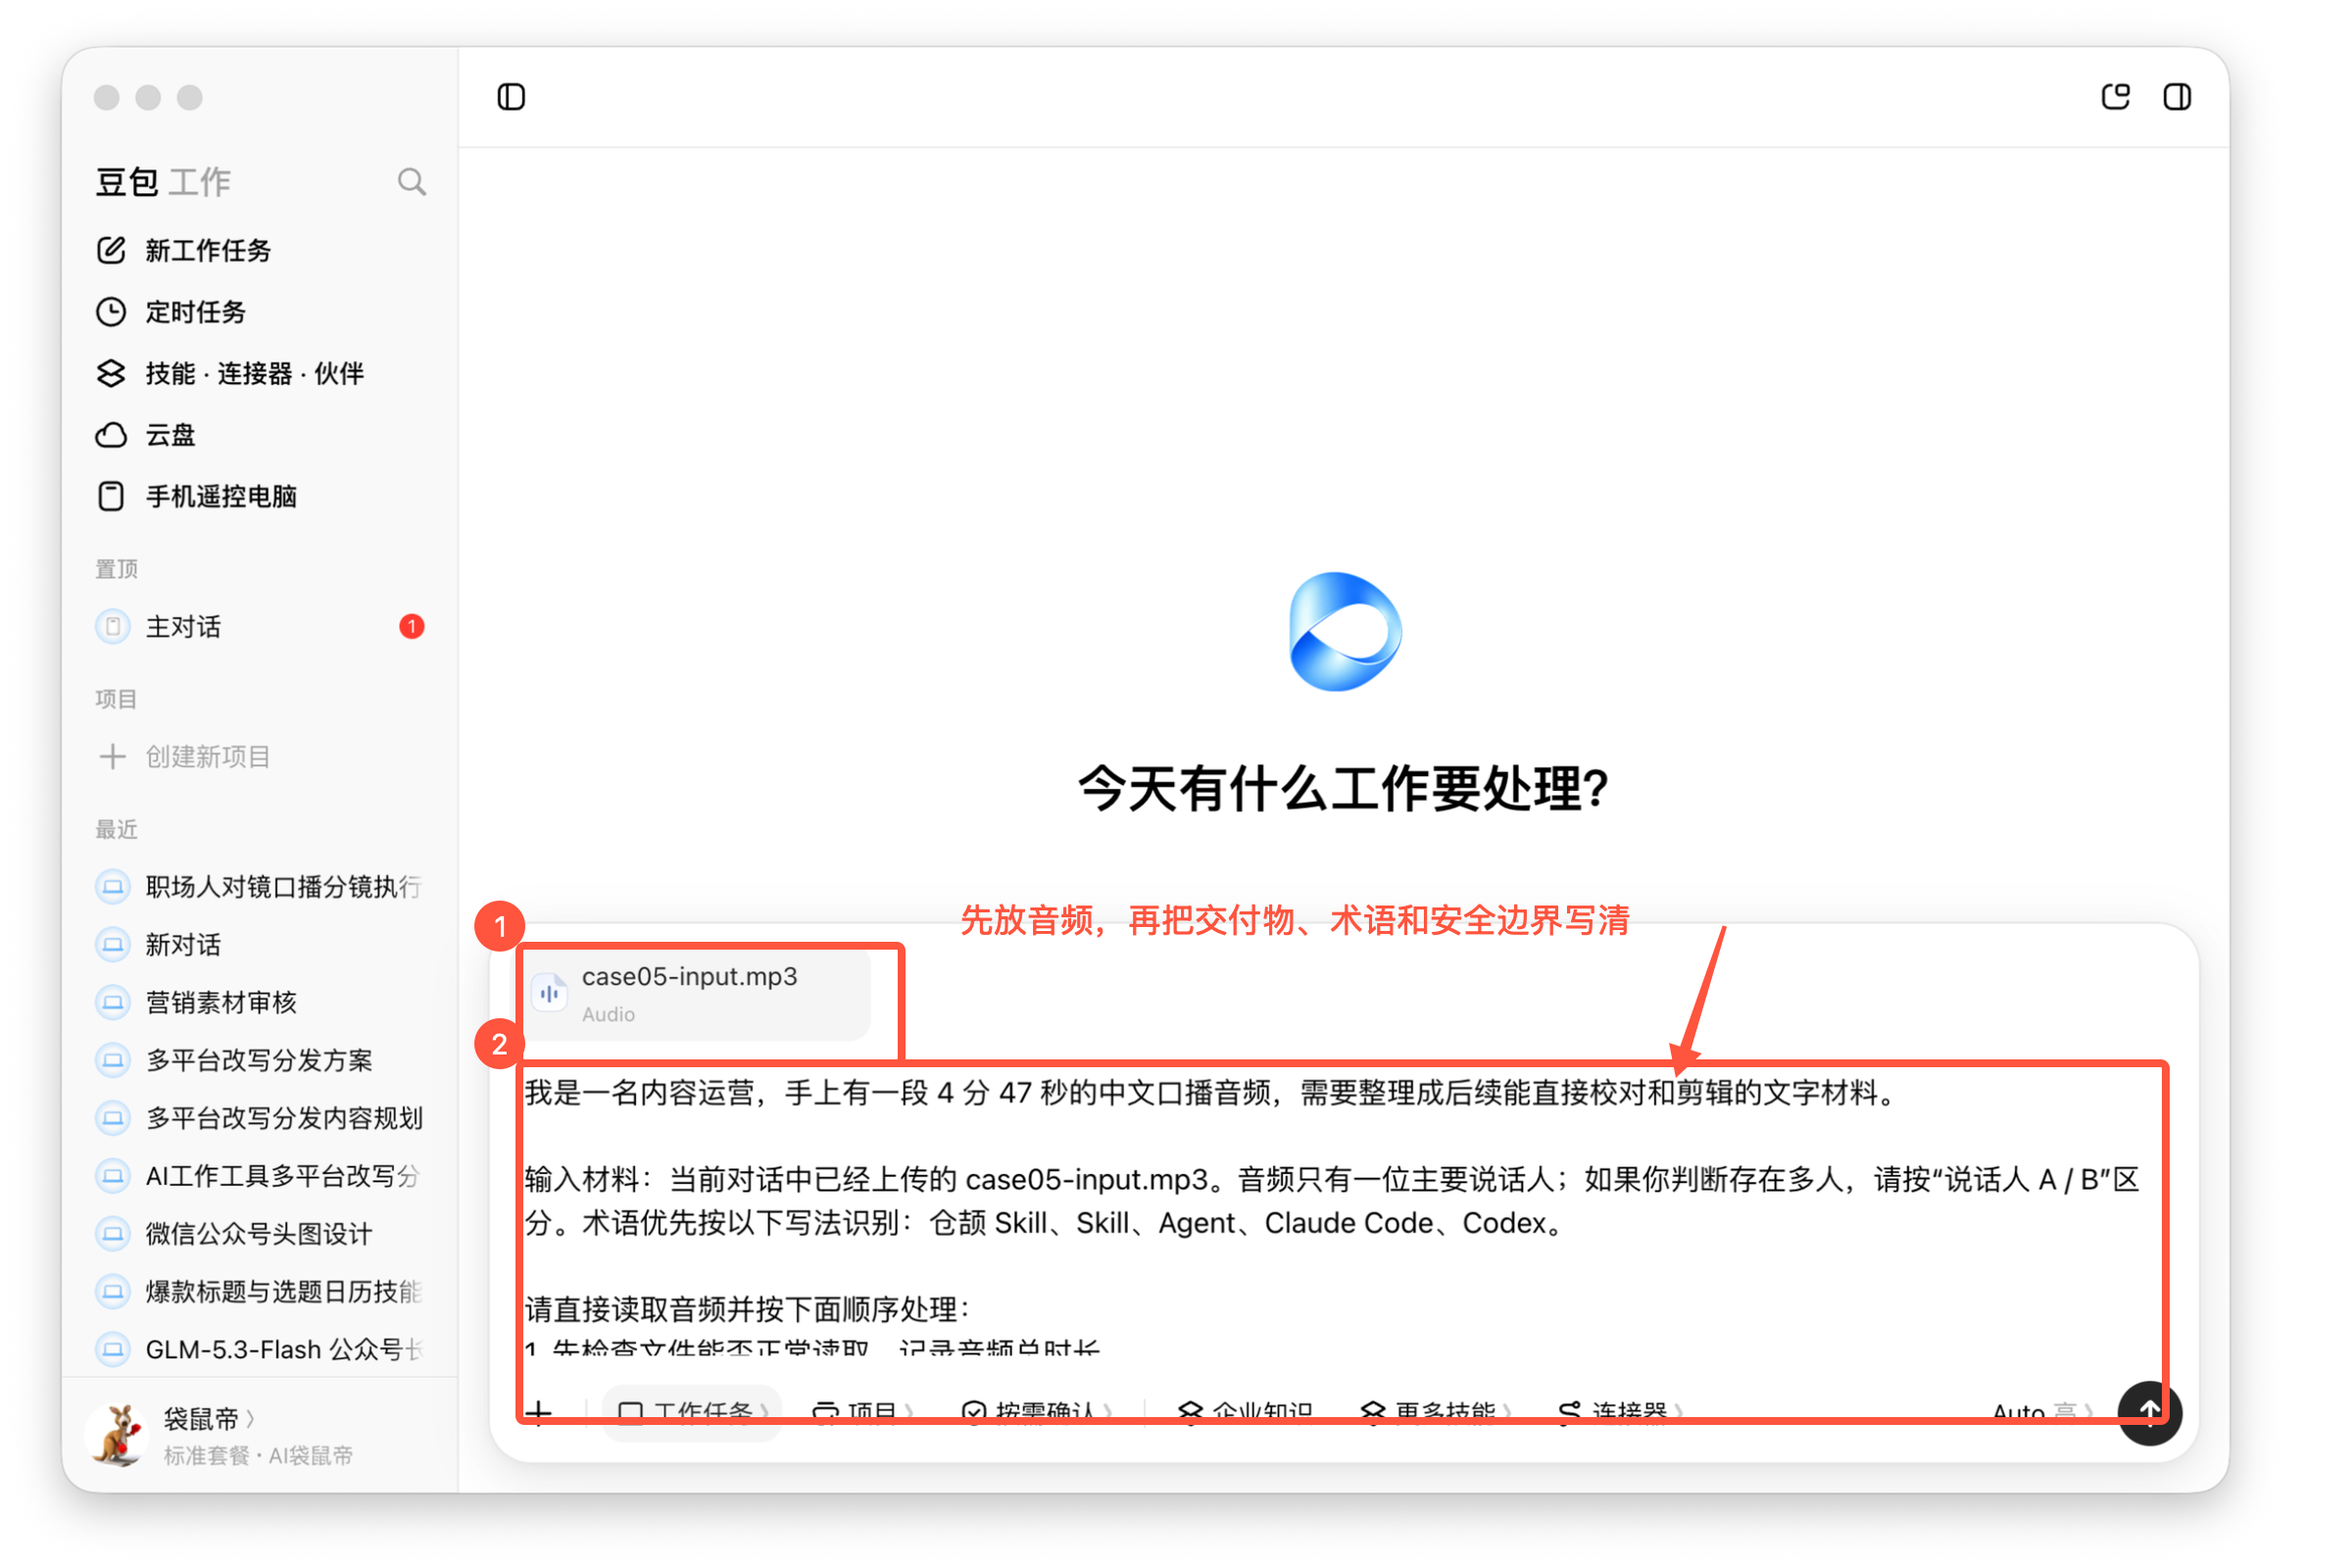
第一步:把音频和交付标准写进提示词
新建工作任务后上传音频。这次的样例总时长 286.96 秒,约 4 分 47 秒。提示词里把逐字稿、清洁稿、SRT、人工听辨清单和自检一次写清。
可直接复制的实测提示词
我是一名内容运营,手上有一段中文口播音频,需要整理成后续能直接校对和剪辑的文字材料。

输入材料:当前对话中已经上传的【音频文件名】。音频只有一位主要说话人;如果你判断存在多人,请按“说话人 A / B”区分。术语优先按以下写法识别:【填写产品名、人名、英文缩写】。

请直接读取音频并按下面顺序处理:
1. 先检查文件能否正常读取,记录音频总时长。
2. 生成忠实逐字稿,保留 mm:ss 时间码;口头重复、停顿词也保留。
3. 另做一份清洁稿,只删除明显口头重复和无意义停顿,不改变观点、数字、产品名和语气。
4. 生成标准 SRT 字幕:编号连续,时间轴不重叠;单条尽量 1—2 行,每行不超过 18 个汉字;不要把一句话切得无法理解。
5. 把无法确认的词标成【听不清 mm:ss】或【术语待确认 mm:ss】,不要猜写。
6. 做一次自检:抽查开头、中段、结尾,检查时间码连续性、SRT 重叠、术语写法和逐字稿 / 清洁稿是否混淆。

最终请交付:
A. 带时间码逐字稿
B. 清洁稿
C. 完整 SRT 字幕
D. 人工听辨清单
E. 自检结果

请保存为 4 个文件:逐字稿.md、清洁稿.md、字幕.srt、人工听辨清单.md,并在聊天里给出总时长、字幕条数、待听辨数量和文件路径。

安全边界:不要发布、上传到其他平台或修改任何线上内容;无法确认的信息保留标记。
第二步:带时间码转写
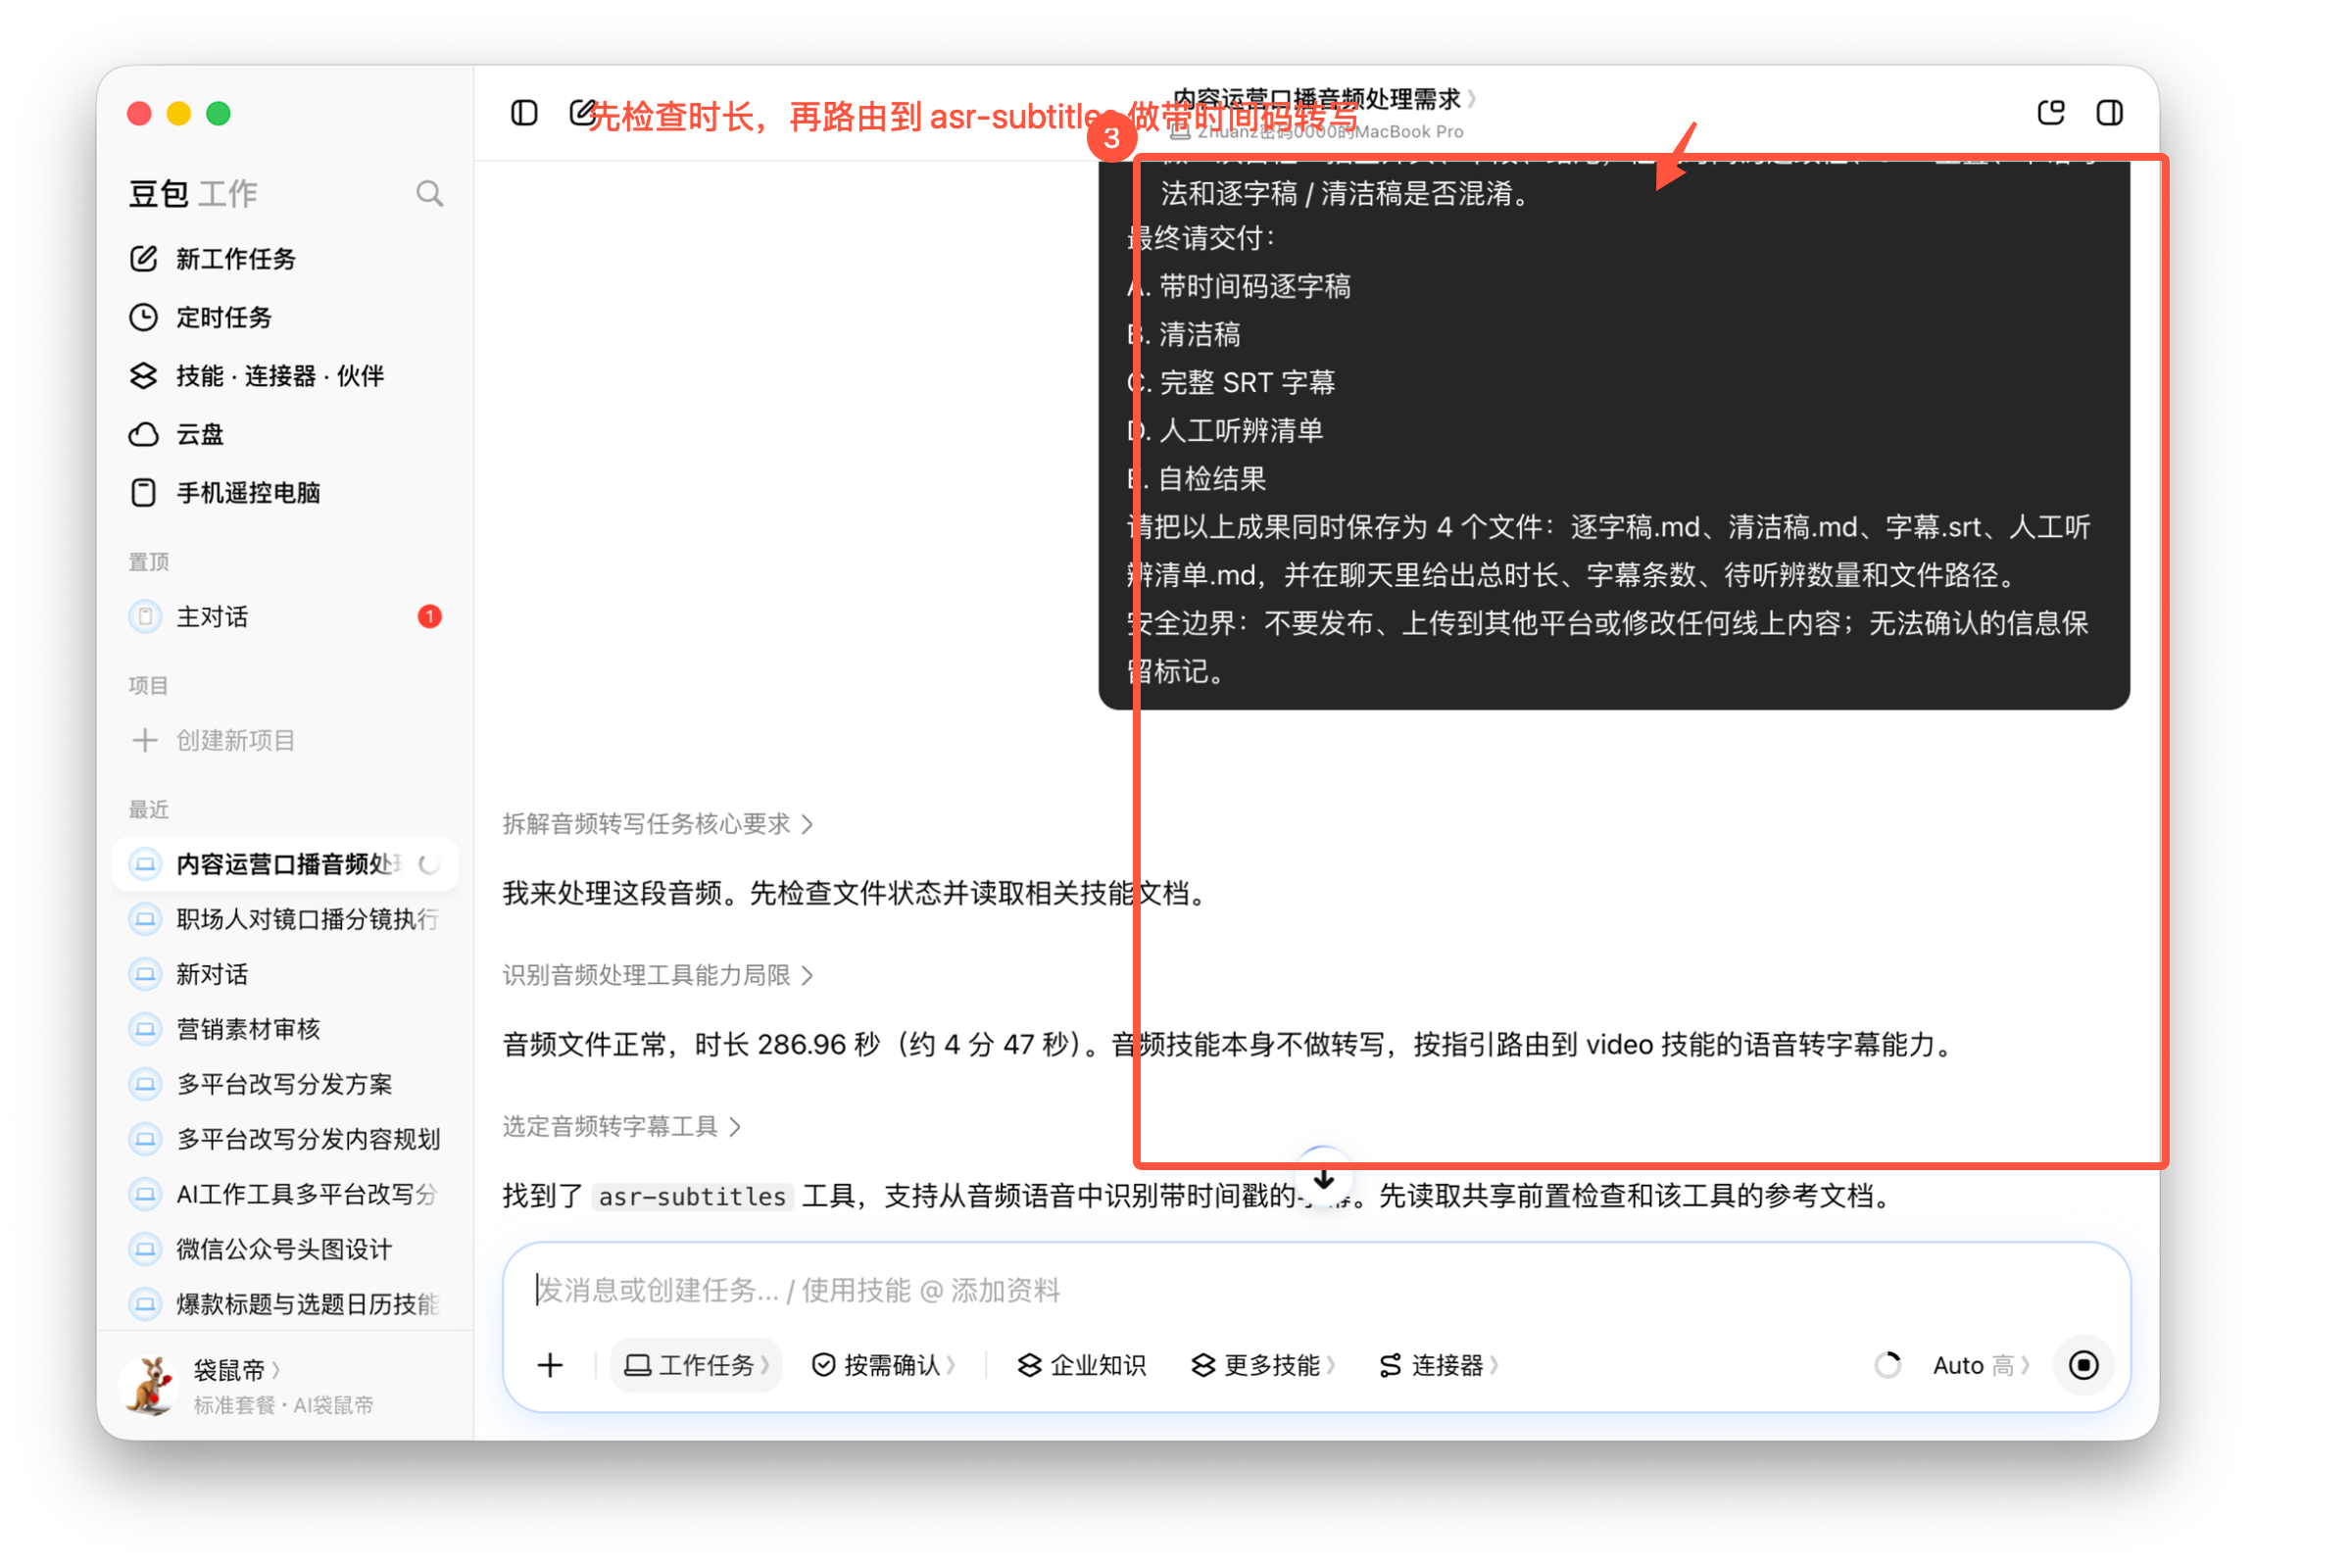
任务开始后,豆包工作先确认文件能读取,得到 286.96 秒时长;随后判断普通音频能力不负责转写,转而调用 asr-subtitles。这一步很关键:如果过程里只出现“理解内容、总结观点”,最后通常只会得到一篇摘要,不会有能对回原音频的时间码。
实测结果:不确定的地方需要带人工确认
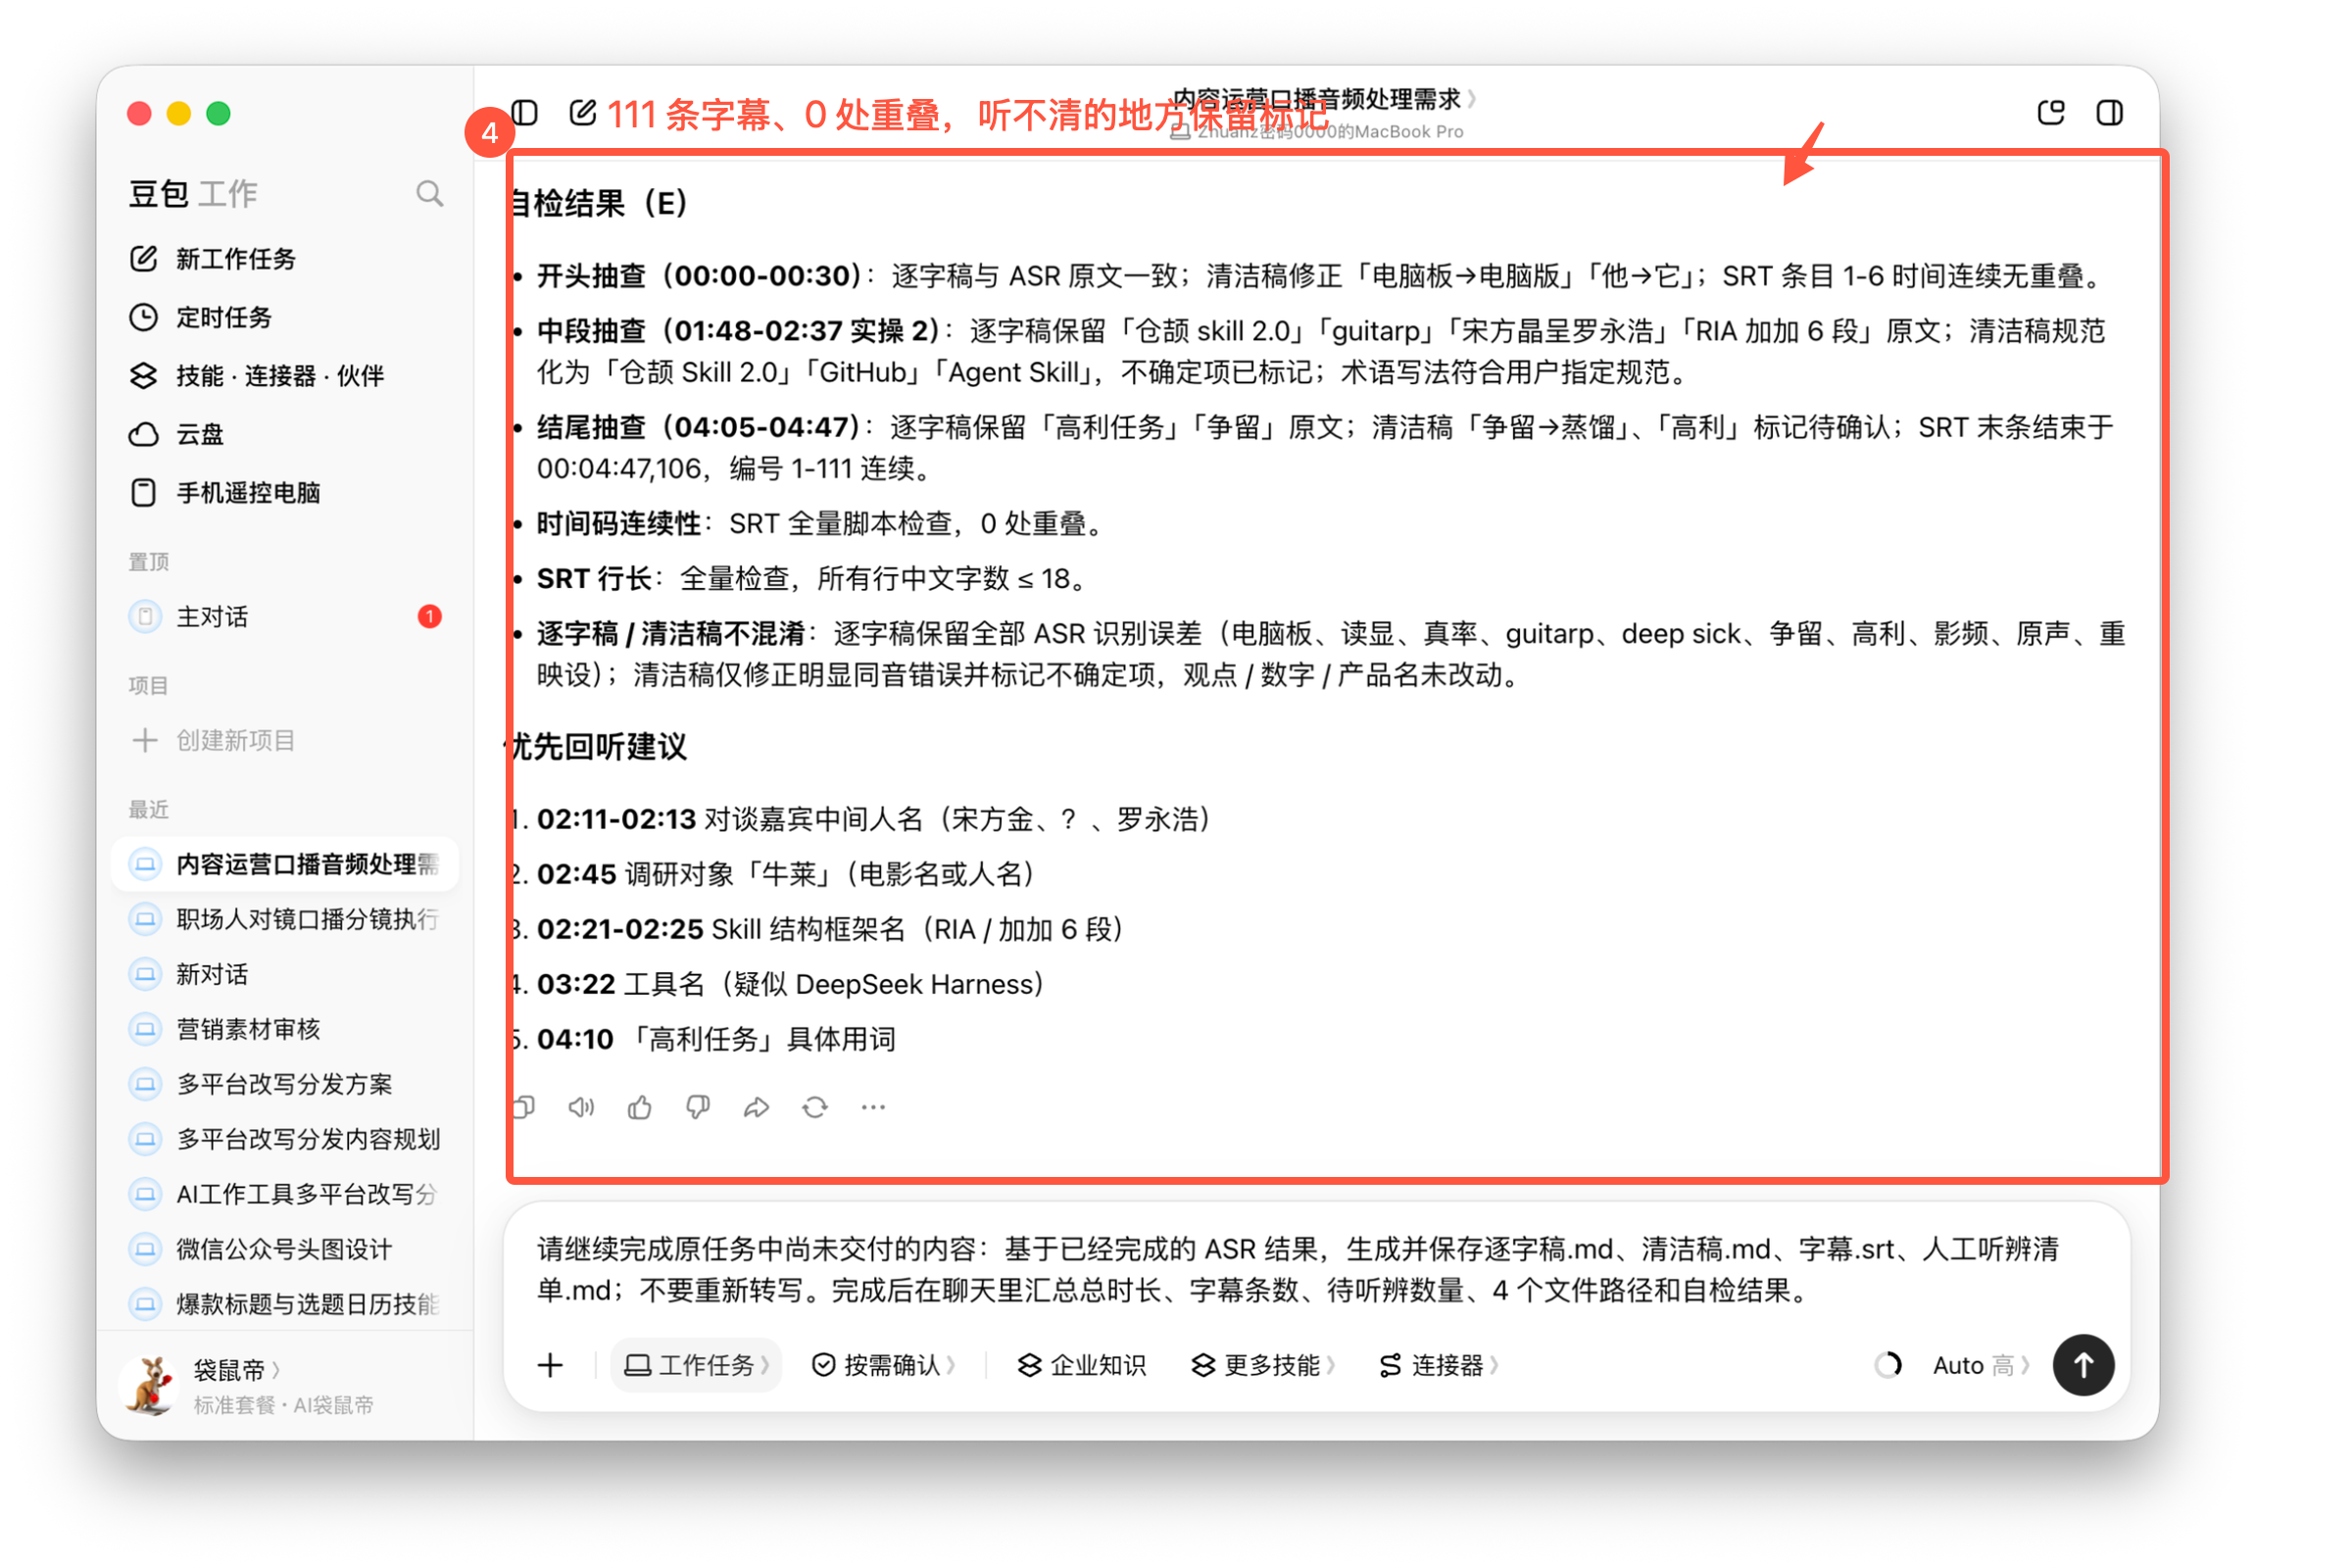
最终交付包括逐字稿、清洁稿、字幕和人工听辨清单。SRT 共 111 条,时间轴检查是 0 处重叠,每行中文不超过 18 个字。
在这个过程中,它没有把听不清的地方硬猜成一句通顺的话。反而留下 10 个待人工确认点,例如嘉宾人名、工具名、显卡型号、文件名和数字。另有 11 个能根据上下文确认的同音误识别,被单独记为“已修正”。
任务二:另开任务,只读校验过的文本
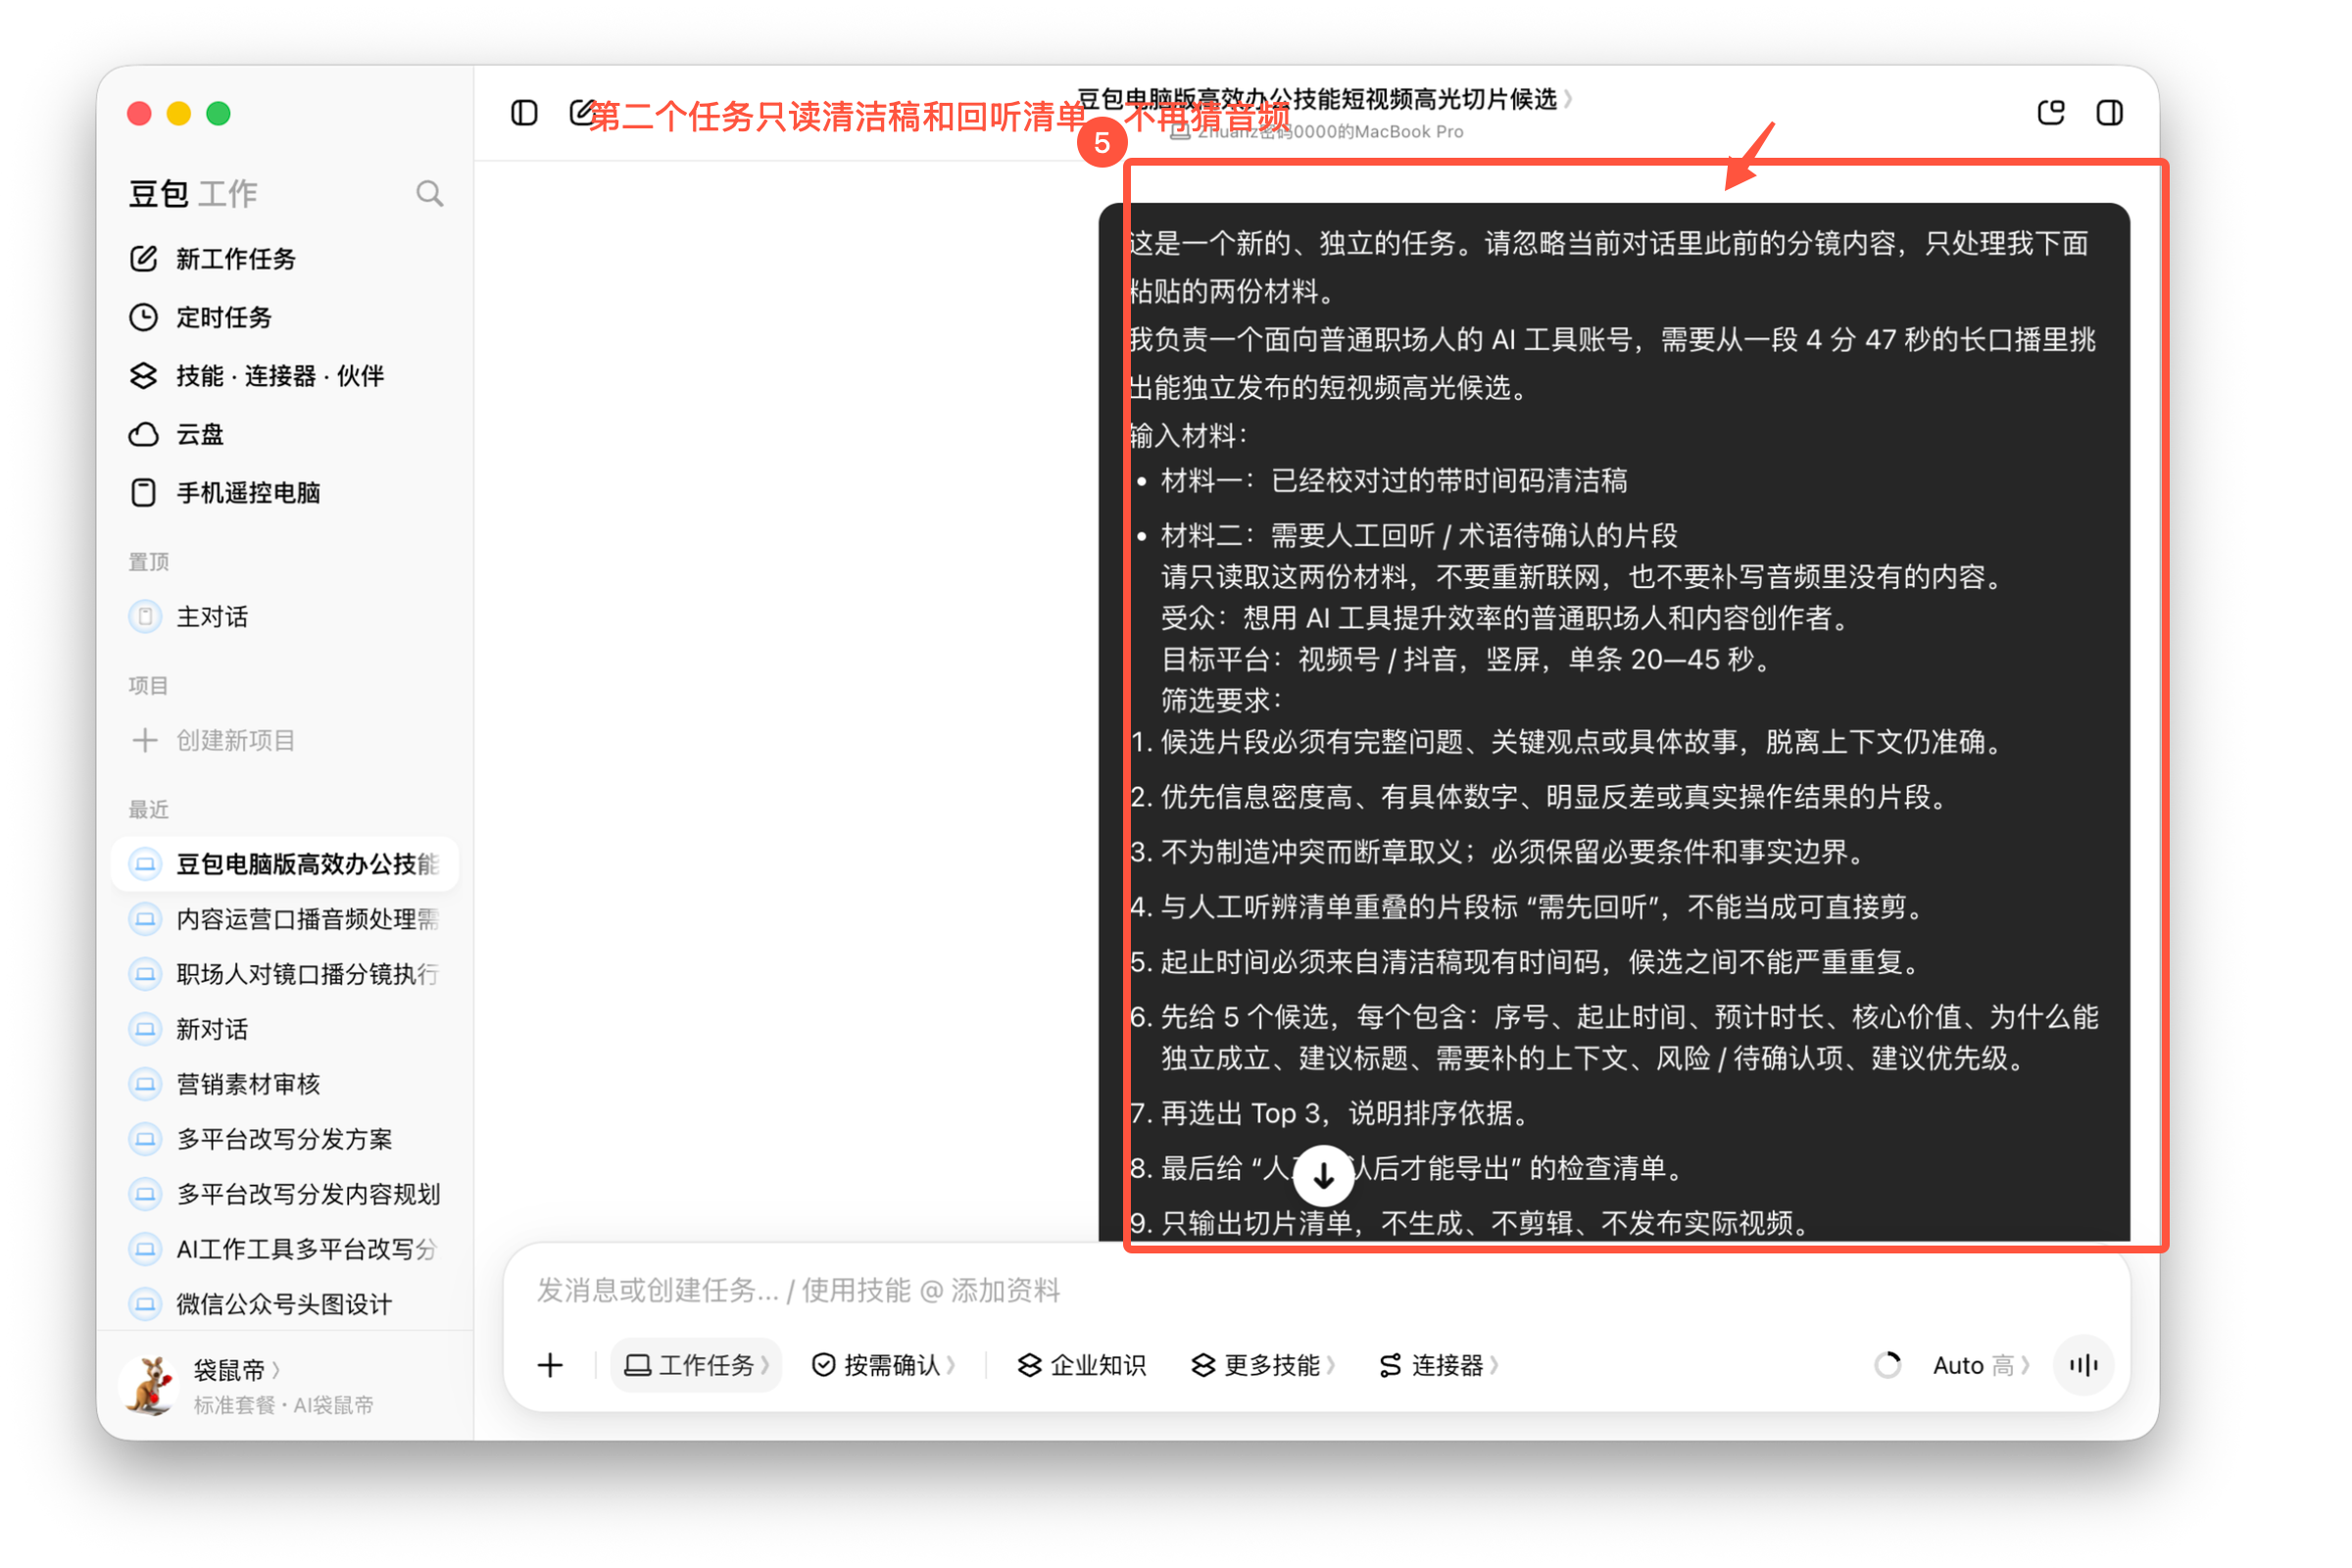
第一步完成后,我把带时间码清洁稿和人工听辨清单放进一个新任务。这样它只能基于已有时间码判断,不会一边筛选,一边重新编人名和数字。
当前版本里,.md / .txt 在本地文件选择器中可能出现“打开”按钮不可用。实测最稳的方法,是把两份文本直接粘进提示词;如果你的版本支持上传,也可以改成明确文件名。
可直接复制的实测提示词
这是一个新的、独立的任务。请只处理我下面提供的两份材料:
- 材料一:已经校对过的带时间码清洁稿
- 材料二:需要人工回听 / 术语待确认的片段

请不要重新联网,也不要补写音频里没有的内容。

受众:【填写你的受众】
目标平台:视频号 / 抖音,竖屏,单条 20—45 秒。

筛选要求:
1. 候选片段必须有完整问题、关键观点或具体故事,脱离上下文仍准确。
2. 优先信息密度高、有具体数字、明显反差或真实操作结果的片段。
3. 不为制造冲突而断章取义;必须保留必要条件和事实边界。
4. 与人工听辨清单重叠的片段标“需先回听”,不能当成可直接剪。
5. 起止时间必须来自清洁稿现有时间码,候选之间不能严重重复。
6. 先给 5 个候选,每个包含:序号、起止时间、预计时长、核心价值、为什么能独立成立、建议标题、需要补的上下文、风险 / 待确认项、建议优先级。
7. 再选出 Top 3,说明排序依据。
8. 最后给“人工确认后才能导出”的检查清单。
9. 只输出切片清单,不生成、不剪辑、不发布实际视频。

最终请保存为 高光切片候选.md,并在聊天里给出候选总数、Top 3 时间段和需要先回听的候选数。

安全边界:未经我确认,不要调用剪辑工具导出视频,不要发布,也不要修改原始文件。

--- 材料一:带时间码清洁稿 ---
【粘贴清洁稿,或写明上传文件名】

--- 材料二:人工回听 / 术语待确认 ---
【粘贴人工听辨清单,或写明上传文件名】
执行中:判断能否独立成立
豆包工作先把时间码节点梳理出来,再按“完整问题或故事、信息密度、20—45 秒、事实边界”筛 5 个候选。随后逐个和人工听辨清单对照:只要时间段里碰到待确认人名、产品名或数字,就标成“需先回听”。
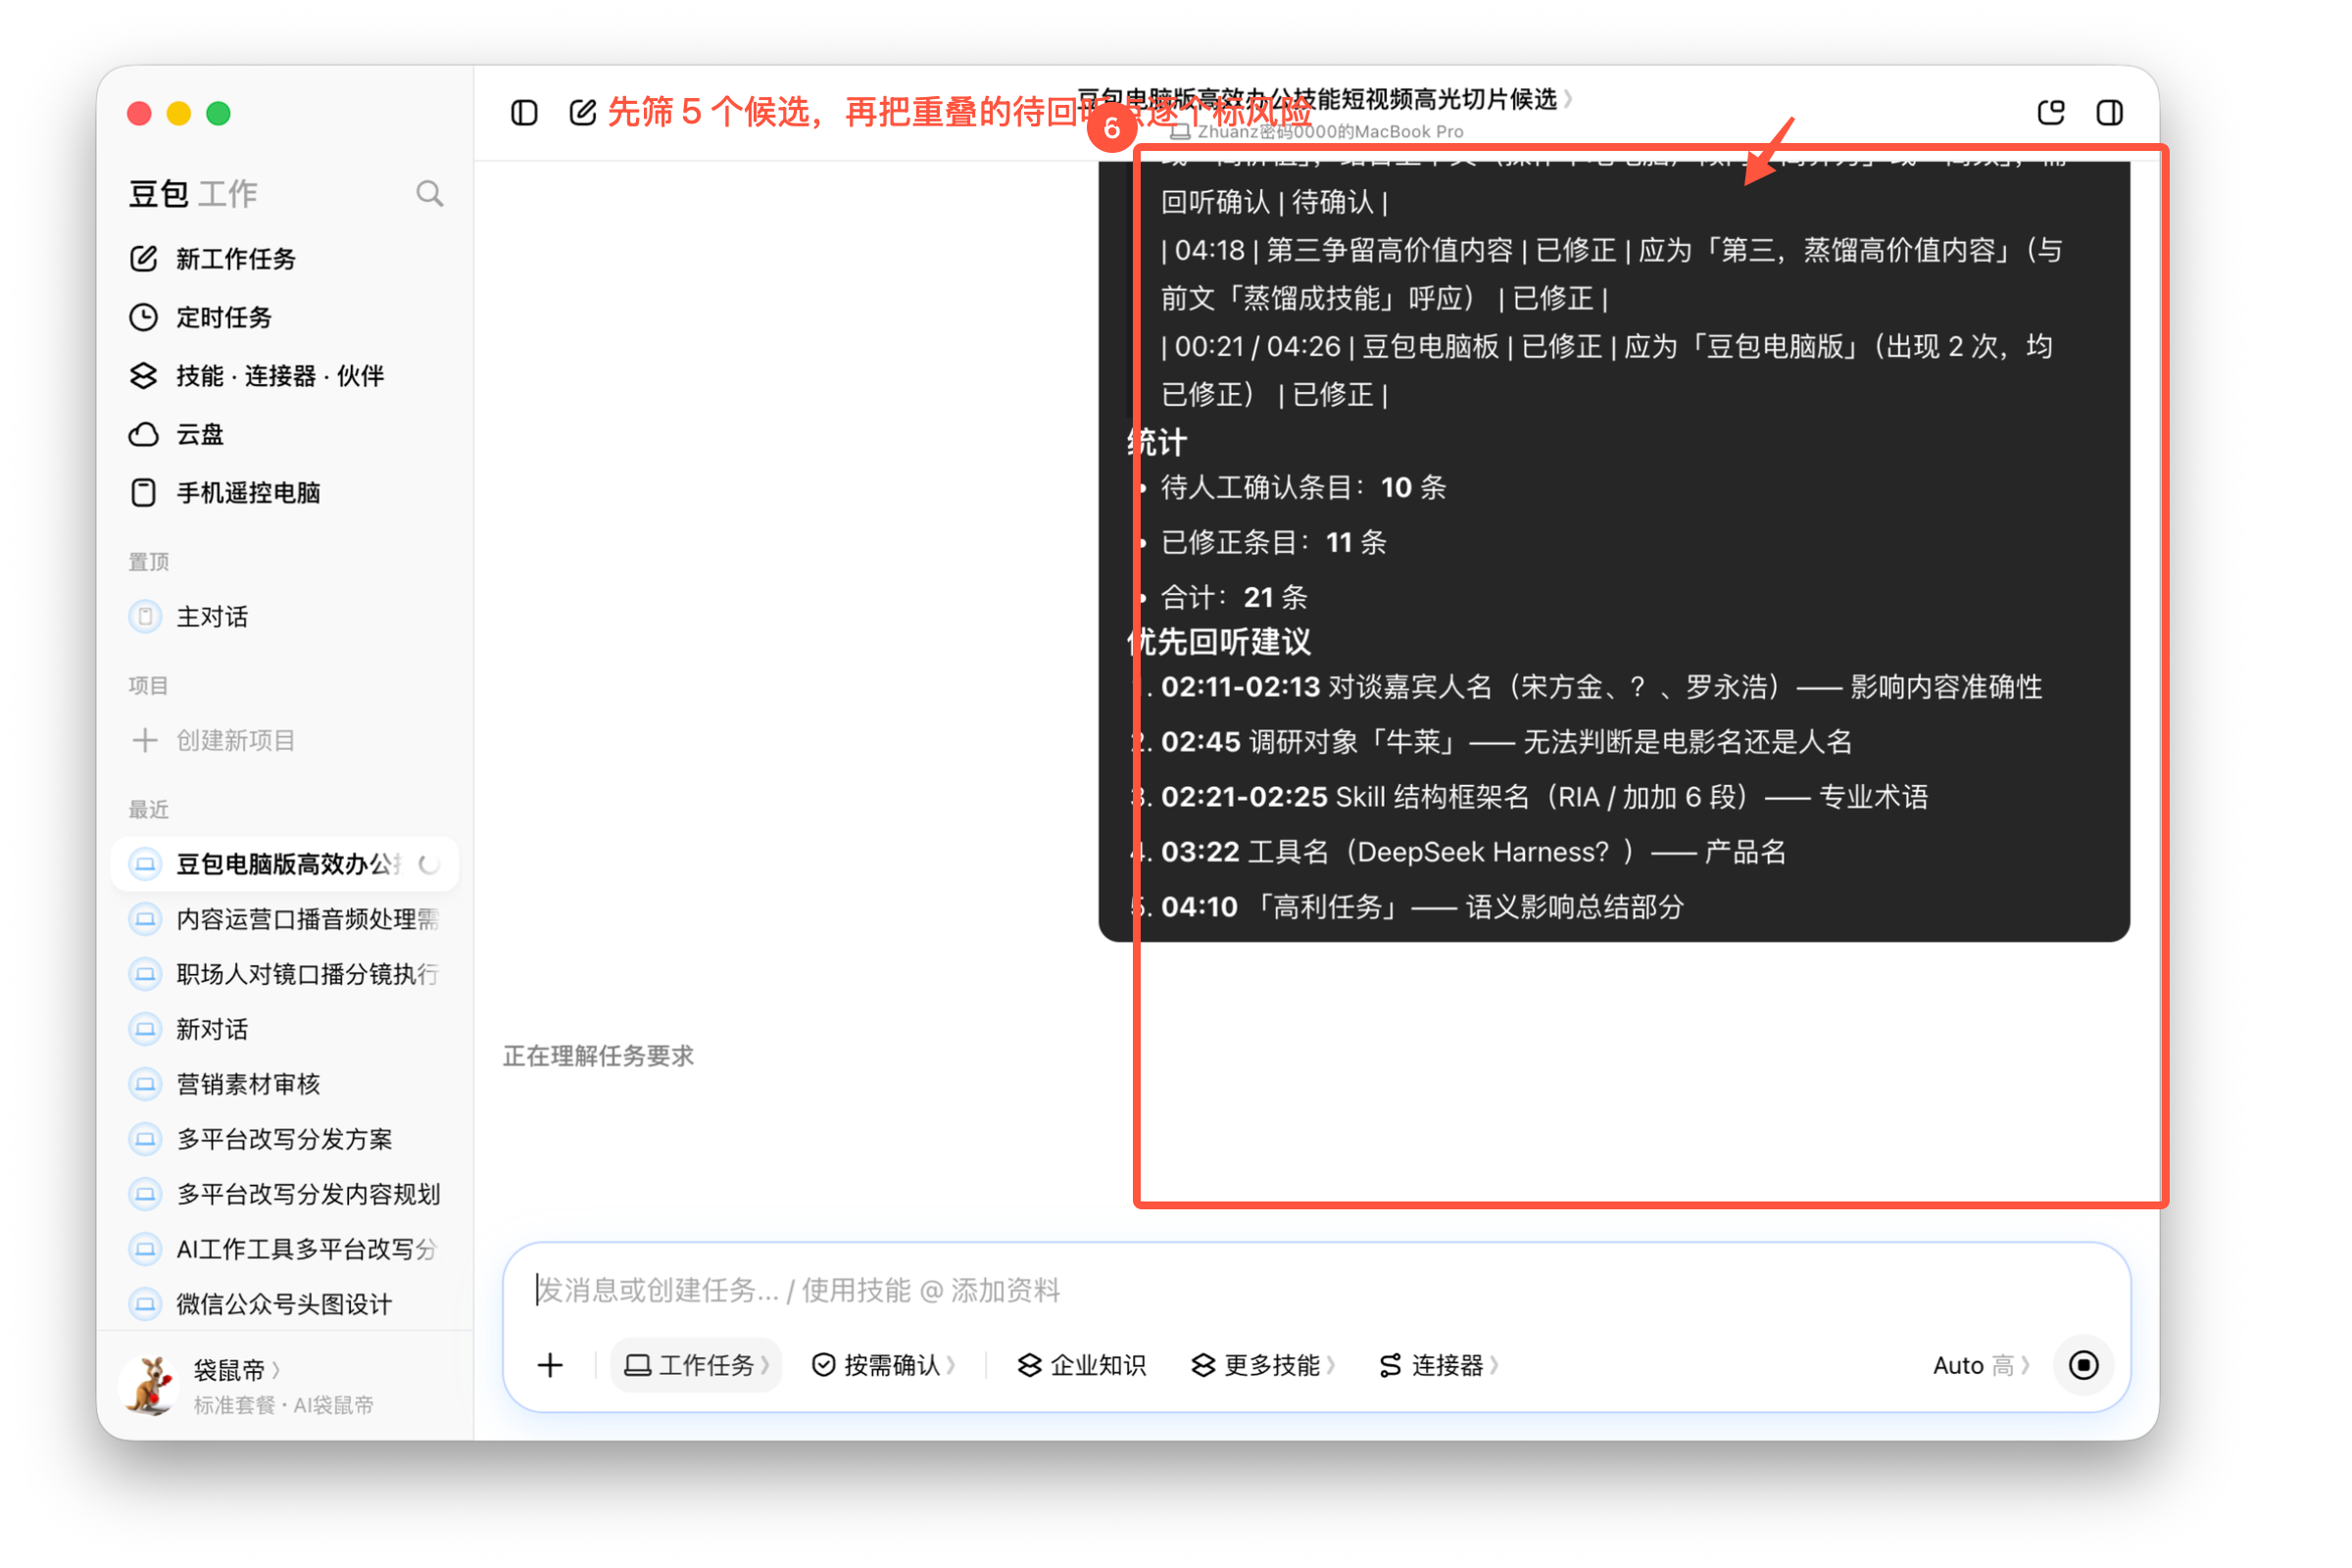
实测结果:5 个候选都有风险,所以一个也没有直接导出
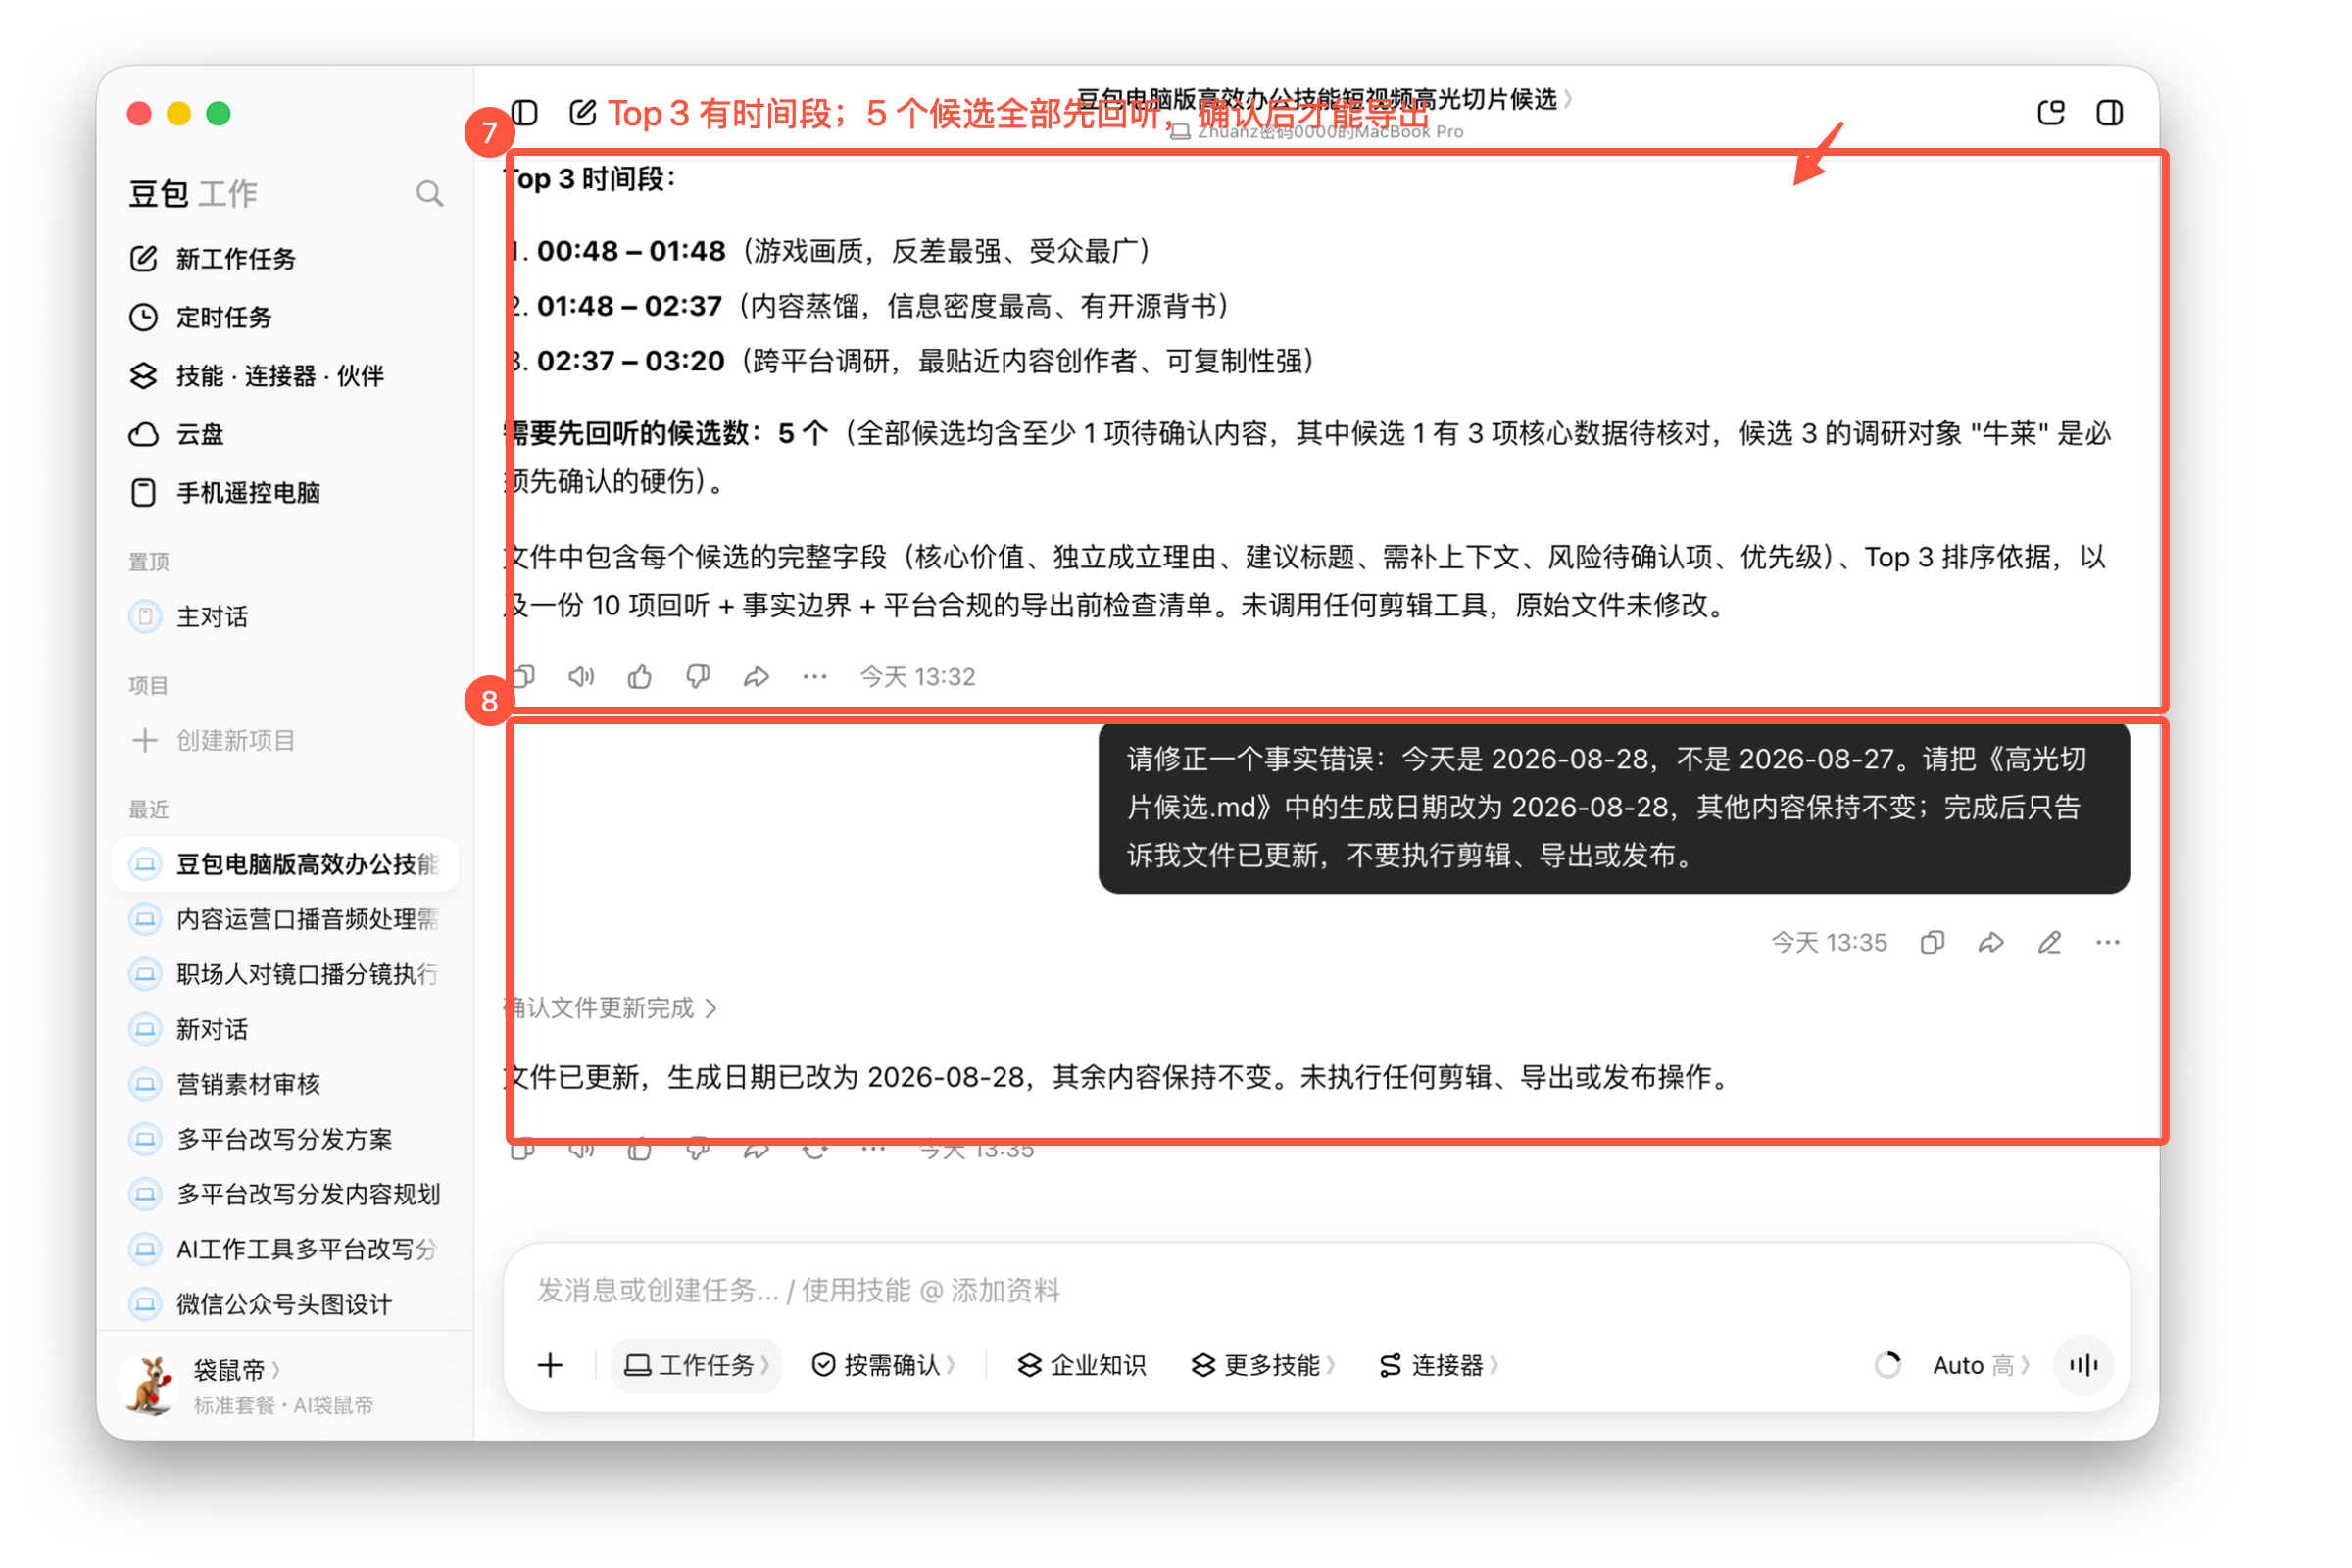
这次得到的 Top 3 是:
| 排名 | 时间段 | 内容 | 为什么靠前 |
|---|---|---|---|
| 1 | 00:48—01:48 | AI 接管电脑调游戏画质 | 反差强,有 3,405 MB → 2,704 MB 的量化结果,但需要精剪并核对数字 |
| 2 | 01:48—02:37 | 5 小时对谈蒸馏成 8 个 Skill | 信息密度高,有 46,000 字 → 8 个 Skill 的对比,但嘉宾名和结构名待确认 |
| 3 | 02:37—03:20 | 跨 5 个平台做电影调研 | 最贴近内容创作者,43 秒可直接成立,但调研对象名称必须先回听 |
5 个候选全部至少碰到一个待确认项,这就导致候选清单生成了,豆包工作仍然没有调用剪辑工具,没有导出视频,也没有改原始音频。
输出文件第一次把生成日期写成了 2026-08-27。我让它按当天日期修正为 2026-08-28,并再次确认“只改日期,不剪、不导出、不发布”。这也是为什么最终结果必须读一遍,不能看见文件卡片就算完成。
最后,记住这套两段式流程
第一段提示词负责把声音变成可追溯的文字:
- 明确文件、说话人和术语表;
- 同时要逐字稿和清洁稿,不要混;
- SRT 必须检查编号、重叠和行长;
- 听不清就留时间码,绝不猜写;
- 抽查开头、中段、结尾。
第二段提示词负责从文字里筛出值得人工回听的候选:
- 只读清洁稿和听辨清单;
- 起止时间必须来自现有时间码;
- 每个候选都说明为什么能独立成立;
- 碰到待确认项就标风险;
- 人工确认前不剪辑、不导出、不发布。
真正省时间的,不是让 AI 一口气替你把视频发出去,而是让它把最磨人的机械工作先做完:时间码排好、字幕切好、风险点标好、候选段落找好。
这样你只需要把注意力花在最值钱的地方——听那 10 个不确定点,判断那 5 个候选到底能不能发。
AI 办公产品教程 · 完整版