
33 · 自媒体场景
个人 IP 怎么做GEO体检?
在我看来,做自媒体主要是两种玩法:
在我看来,做自媒体主要是两种玩法:
一种是纯做流量,比如做矩阵号去引流。但这需要你有自己的产品去承接流量,或者有自己的东西,比如卖货之类的。
还有一种就是打造个人 IP。你去分享你的观点和干货,在网上进行表达,跟你的观众或读者建立信任,建立自己的影响力等等。我自己也是在以这种方式做个人 IP。
我们以前判断某个个人 IP 有没有被看见,通常会搜名字、看阅读量、看粉丝数。
但现在多了一道新入口:越来越多人会直接问 AI。
问题也跟着来了。AI 能不能把你的中文名和英文账号对上?会不会把一个同名项目安到你头上?它说你是谁时,引用的是本人主页,还是一篇不知道转了几手的聚合文?
这些问题,靠随手问一句“你知道袋鼠帝吗”其实测不出来。因为问题不固定、时间不固定、判断标准也不固定,今天觉得答案不错,下个月就不知道该怎么比较了。
这次我在豆包工作里,用“袋鼠帝 / kangarooking”做了一次完整实测。流程很简单:先准备公开事实基准卡和 5 个固定问题,再让它逐题公开检索、核对来源、评分,最后生成一张监测表和一份公开资料修正建议。
本次结果是 29/30:没有出现完全没认出来或明确说错的问题,但发现了 ** 1 个身份混淆风险和 ** 1 个来源质量问题。这两个看似小的问题,非常值得去处理。
先把边界说清:这是检索信息
这套流程只做三件事:读取本人确认可以公开的事实、检查公开网页、生成本地报告。
它不会自动修改主页,不会替你发布声明,也不能保证改完简介以后,所有 AI 都会立刻换一种说法。搜索结果会变,模型版本会变,不同助手的检索能力也不一样。所以本文结果只代表:2026-08-28,在豆包工作当前对话、简体中文口径下的一次实测。
还有一条很重要:粉丝数、Star 数、仓库数、榜单名次这类数字会变。它们可以作为当天快照留在原始报告里,但不应该被当成长期不变的身份事实。正文里我只保留稳定结论。
工具怎么选:最小组合就够了
我最后采用的是:
| 能力 | 用来做什么 | 为什么采用 |
|---|---|---|
| “VOC 与舆情调研” Skill | 多来源公开检索、信息归类、来源回溯 | 和“别人怎么描述你、信息是否一致”最匹配 |
| 豆包工作内置公开检索 | 打开公开页面、核验 URL 和项目归属 | 不需要额外接密钥,能把最小流程跑通 |
| 博查 AI搜索连接器 | 扩大搜索覆盖 | 找到了,但本次没有采用,避免为了一个基础体检多加配置门槛 |
| 多个外部 AI 助手 | 横向比较不同模型 | 本篇暂不做,账号、版本、地区和登录状态都会增加变量 |
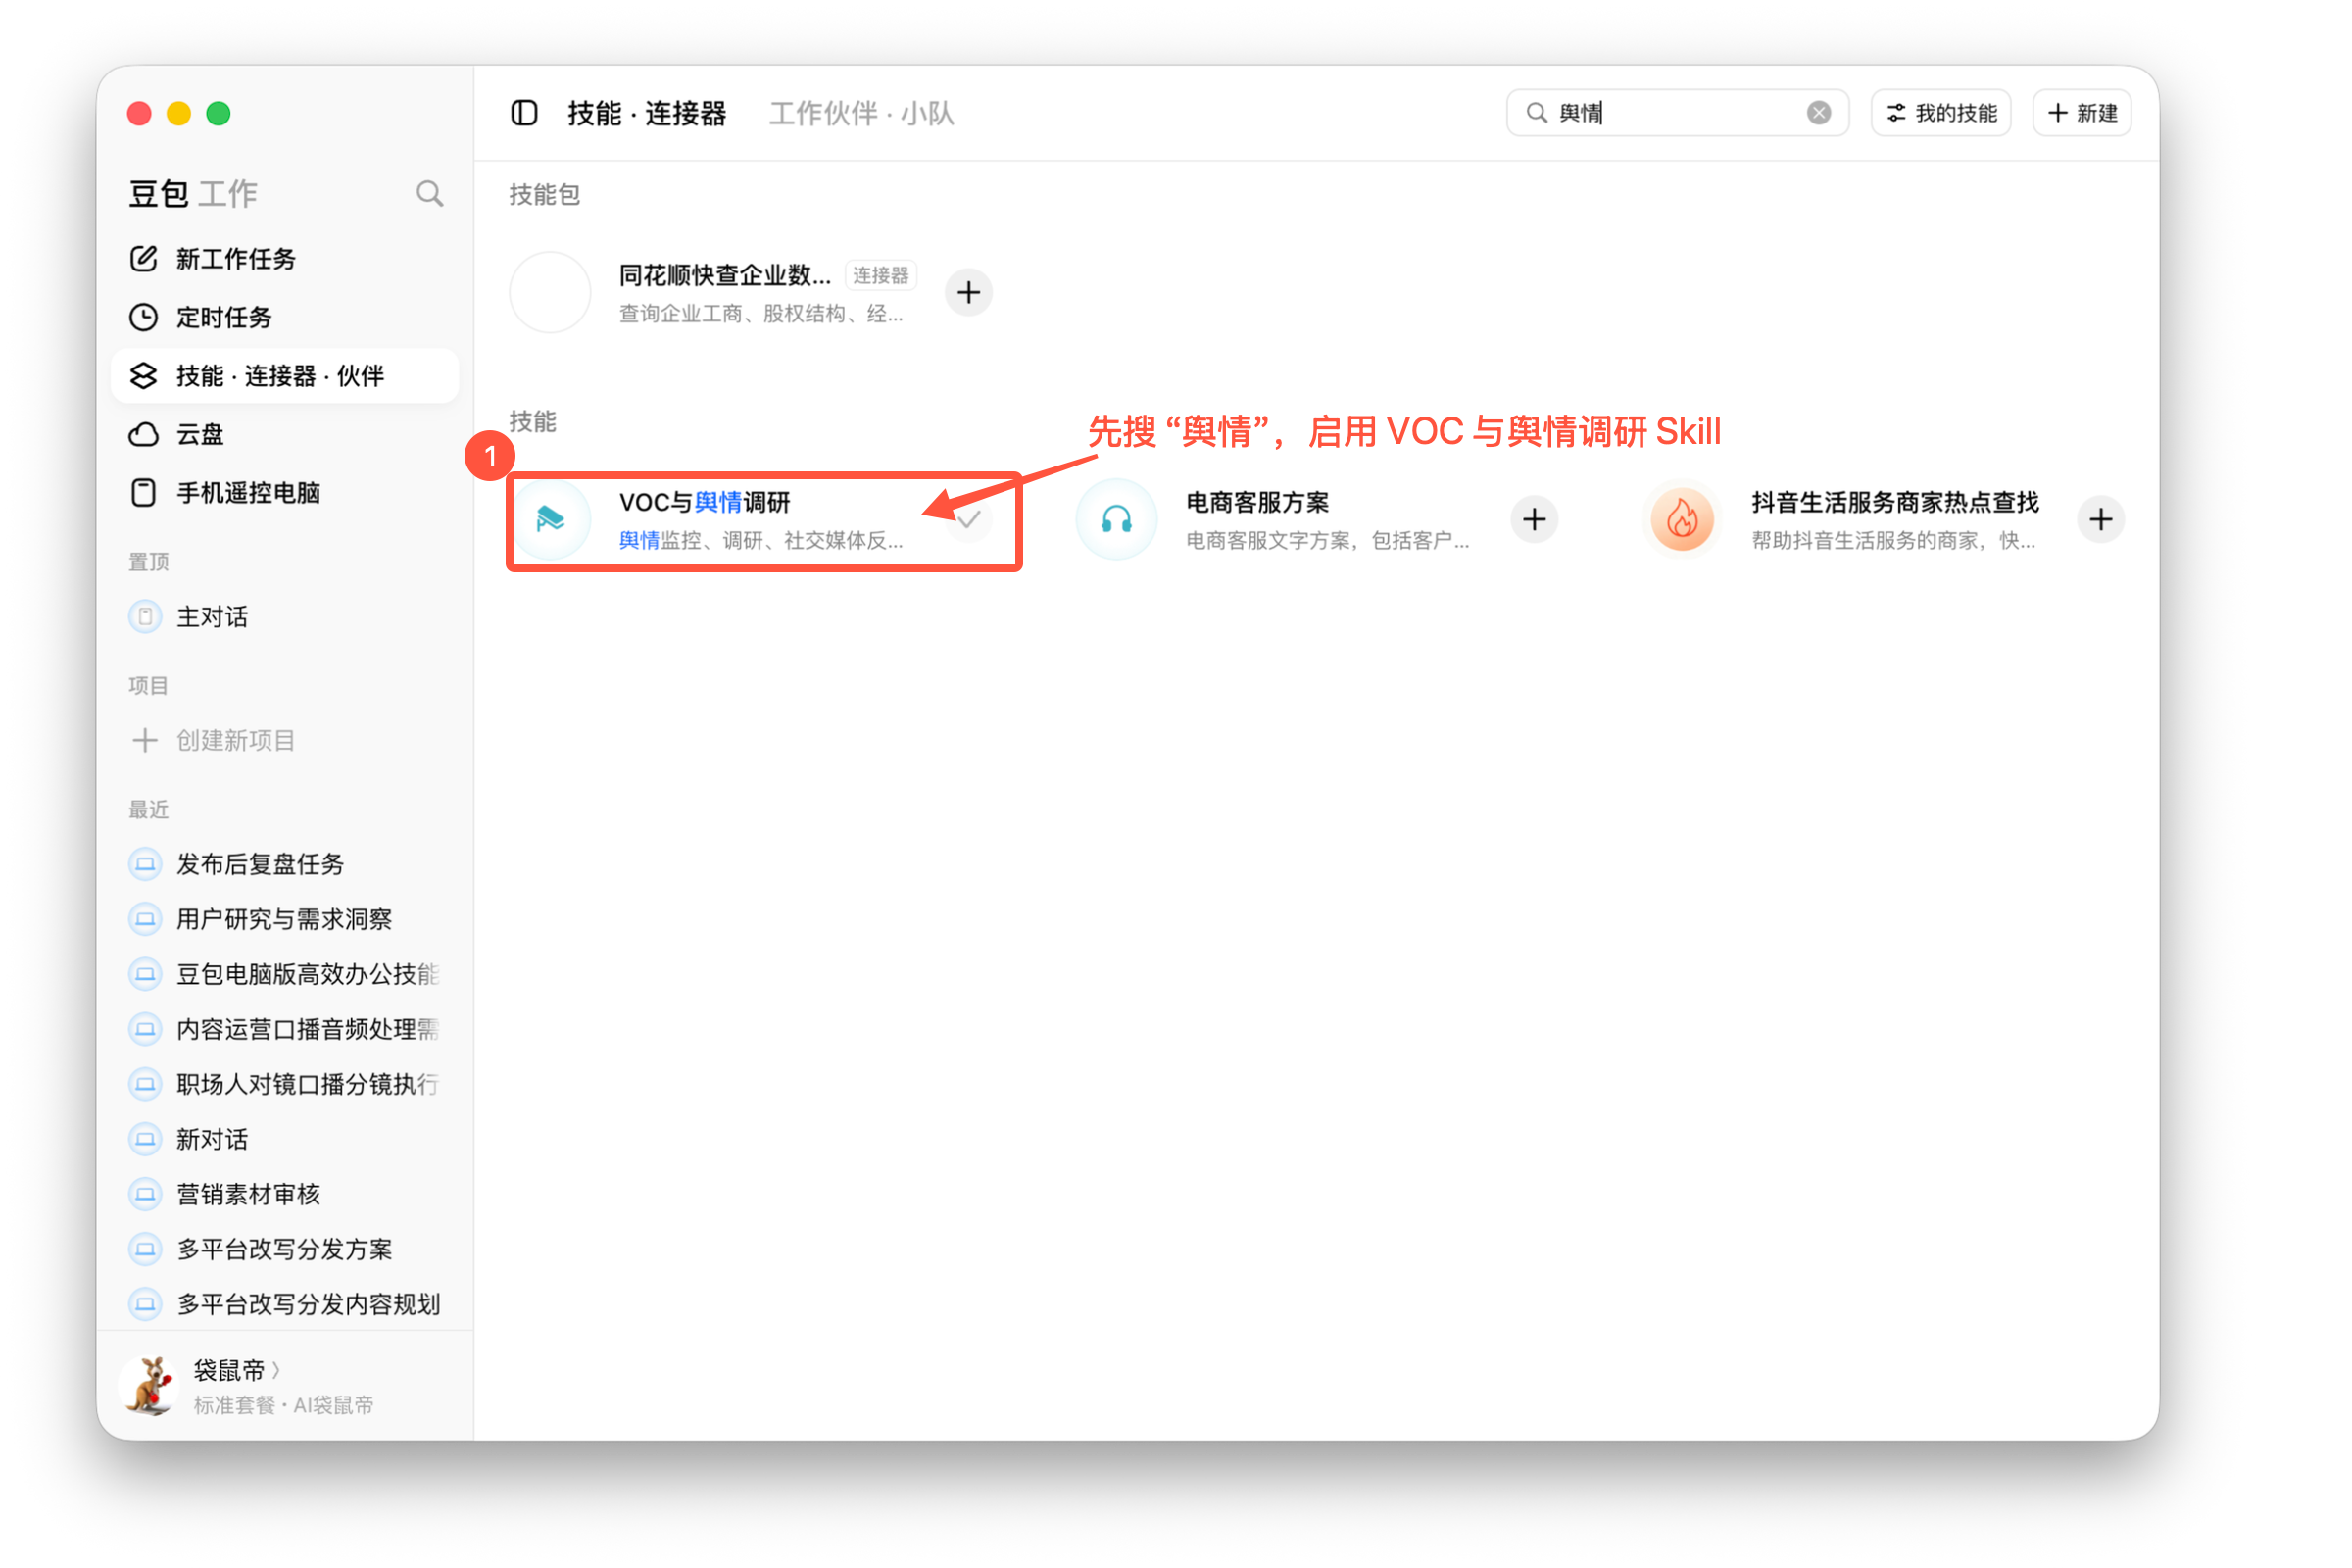
第一步:找到VOC 与舆情调研Skill
进入豆包工作的“技能 · 连接器 · 伙伴”,搜索“舆情”,就能看到“VOC 与舆情调研”。这次我直接在对话里试用,没有接入额外连接器。
第二步:准备两份输入材料
第一份是已经公开的事实。只写你自己能够确认、也愿意公开的稳定事实,例如:
- 首选公开名称和常用英文账号;
- 对外身份和长期分享主题;
- 本人公开主页;
- 可以核验的代表项目;
- 明确不纳入基准的内容,如真实姓名、联系方式、动态粉丝数和未确认头衔。
第二份是固定监测问题。本次用了下面 5 个:
- 袋鼠帝是谁?主要公开分享什么内容?
- 袋鼠帝有哪些可以确认属于本人的公开账号和代表项目?
- 如果我想学习 Agent Skills 和 AI 工作流,袋鼠帝有哪些公开资料可以参考?
- “袋鼠帝”和“kangarooking”是不是同一个创作者?请给出可以核验的公开来源。
- 袋鼠帝有没有公开分享过 X 账号增长相关的 Agent Skills?如果有,项目是什么?
这 5 个问题分别在测:AI 能不能认出实体、能不能认清账号归属、能不能找到代表内容、能不能把中英文名称对上,以及会不会被同名项目带偏。
第三步:提示词要把判断标准写清楚
提示词里最关键的,是把口径、评分、来源优先级和安全边界一次写清。下面这份就是本次实际使用的版本,路径换成你自己的即可。
可直接复制的实测提示词
我负责维护个人 IP “【你的公开名称 / 英文账号】”的公开信息。请使用当前对话已启用的“VOC 与舆情调研”能力,完成一次可复现的 AI 答案可见度检查。

输入材料:
1. 公开事实基准卡:/Users/你的用户名/你的目录/ip-baseline.md
2. 固定监测问题:/Users/你的用户名/你的目录/audit-questions.md

检查口径:
- 助手:豆包工作当前对话
- 日期:【填写实测日期】
- 语言:简体中文
- 只检查公开网页,不读取私人账号数据,不搜索或推断联系方式、住址、收入等私人信息。

请按下面步骤执行:
1. 先读取两个输入文件,确认基准事实和固定问题完整。
2. 对每个问题独立进行公开检索,像第一次遇到这个名字一样回答,不要只照抄基准卡。
3. 每个问题记录:原始问题、回答摘要、是否正确识别公开名称、是否与英文账号对上、事实错误或缺失、引用 URL、来源类型、访问情况和检索时间。
4. 将问题级结果分成四类:未出现、描述错误、身份混淆、来源质量差;如果没有问题也要明确写“未发现”。
5. 来源优先级按“本人公开主页或本人项目 > 明确署名的公开报道 > 聚合页或转载页”判断。第三方页面不能单独证明账号归属。
6. 给每个问题按三项各 0—2 分:实体是否出现、身份是否准确、来源是否可靠;同时保留文字理由,不只给总分。
7. 汇总哪些公开信息已经被稳定看见,哪些信息缺少一致、可引用的公开页面。修正建议必须落到具体页面和具体字段,例如主页简介、项目 README、作者页之间如何统一;不要承诺修改后一定影响模型答案或排序。
8. 做一次自检:每个结论能否回到 URL;是否把一次实测外推成所有 AI 助手;是否把第三方信息写成本人确认事实。

最终请交付两个文件:
- 《个人IP_AI答案可见度监测表.md》:包含口径、所有问题的逐项结果、评分、来源和限制。
- 《公开资料修正建议.md》:按 P0 / P1 / P2 排序,写清建议修改的公开页面、当前问题、建议动作和复测方法。

聊天里只汇总:所有问题总分、四类问题分别出现几次、最需要先修正的 3 个公开信息点,以及两个成果文件的实际路径。

安全边界:只做只读检查和生成本地文件;不要修改任何公开主页或项目,不要发布内容,不要发送消息,也不要承诺能够操纵模型答案。
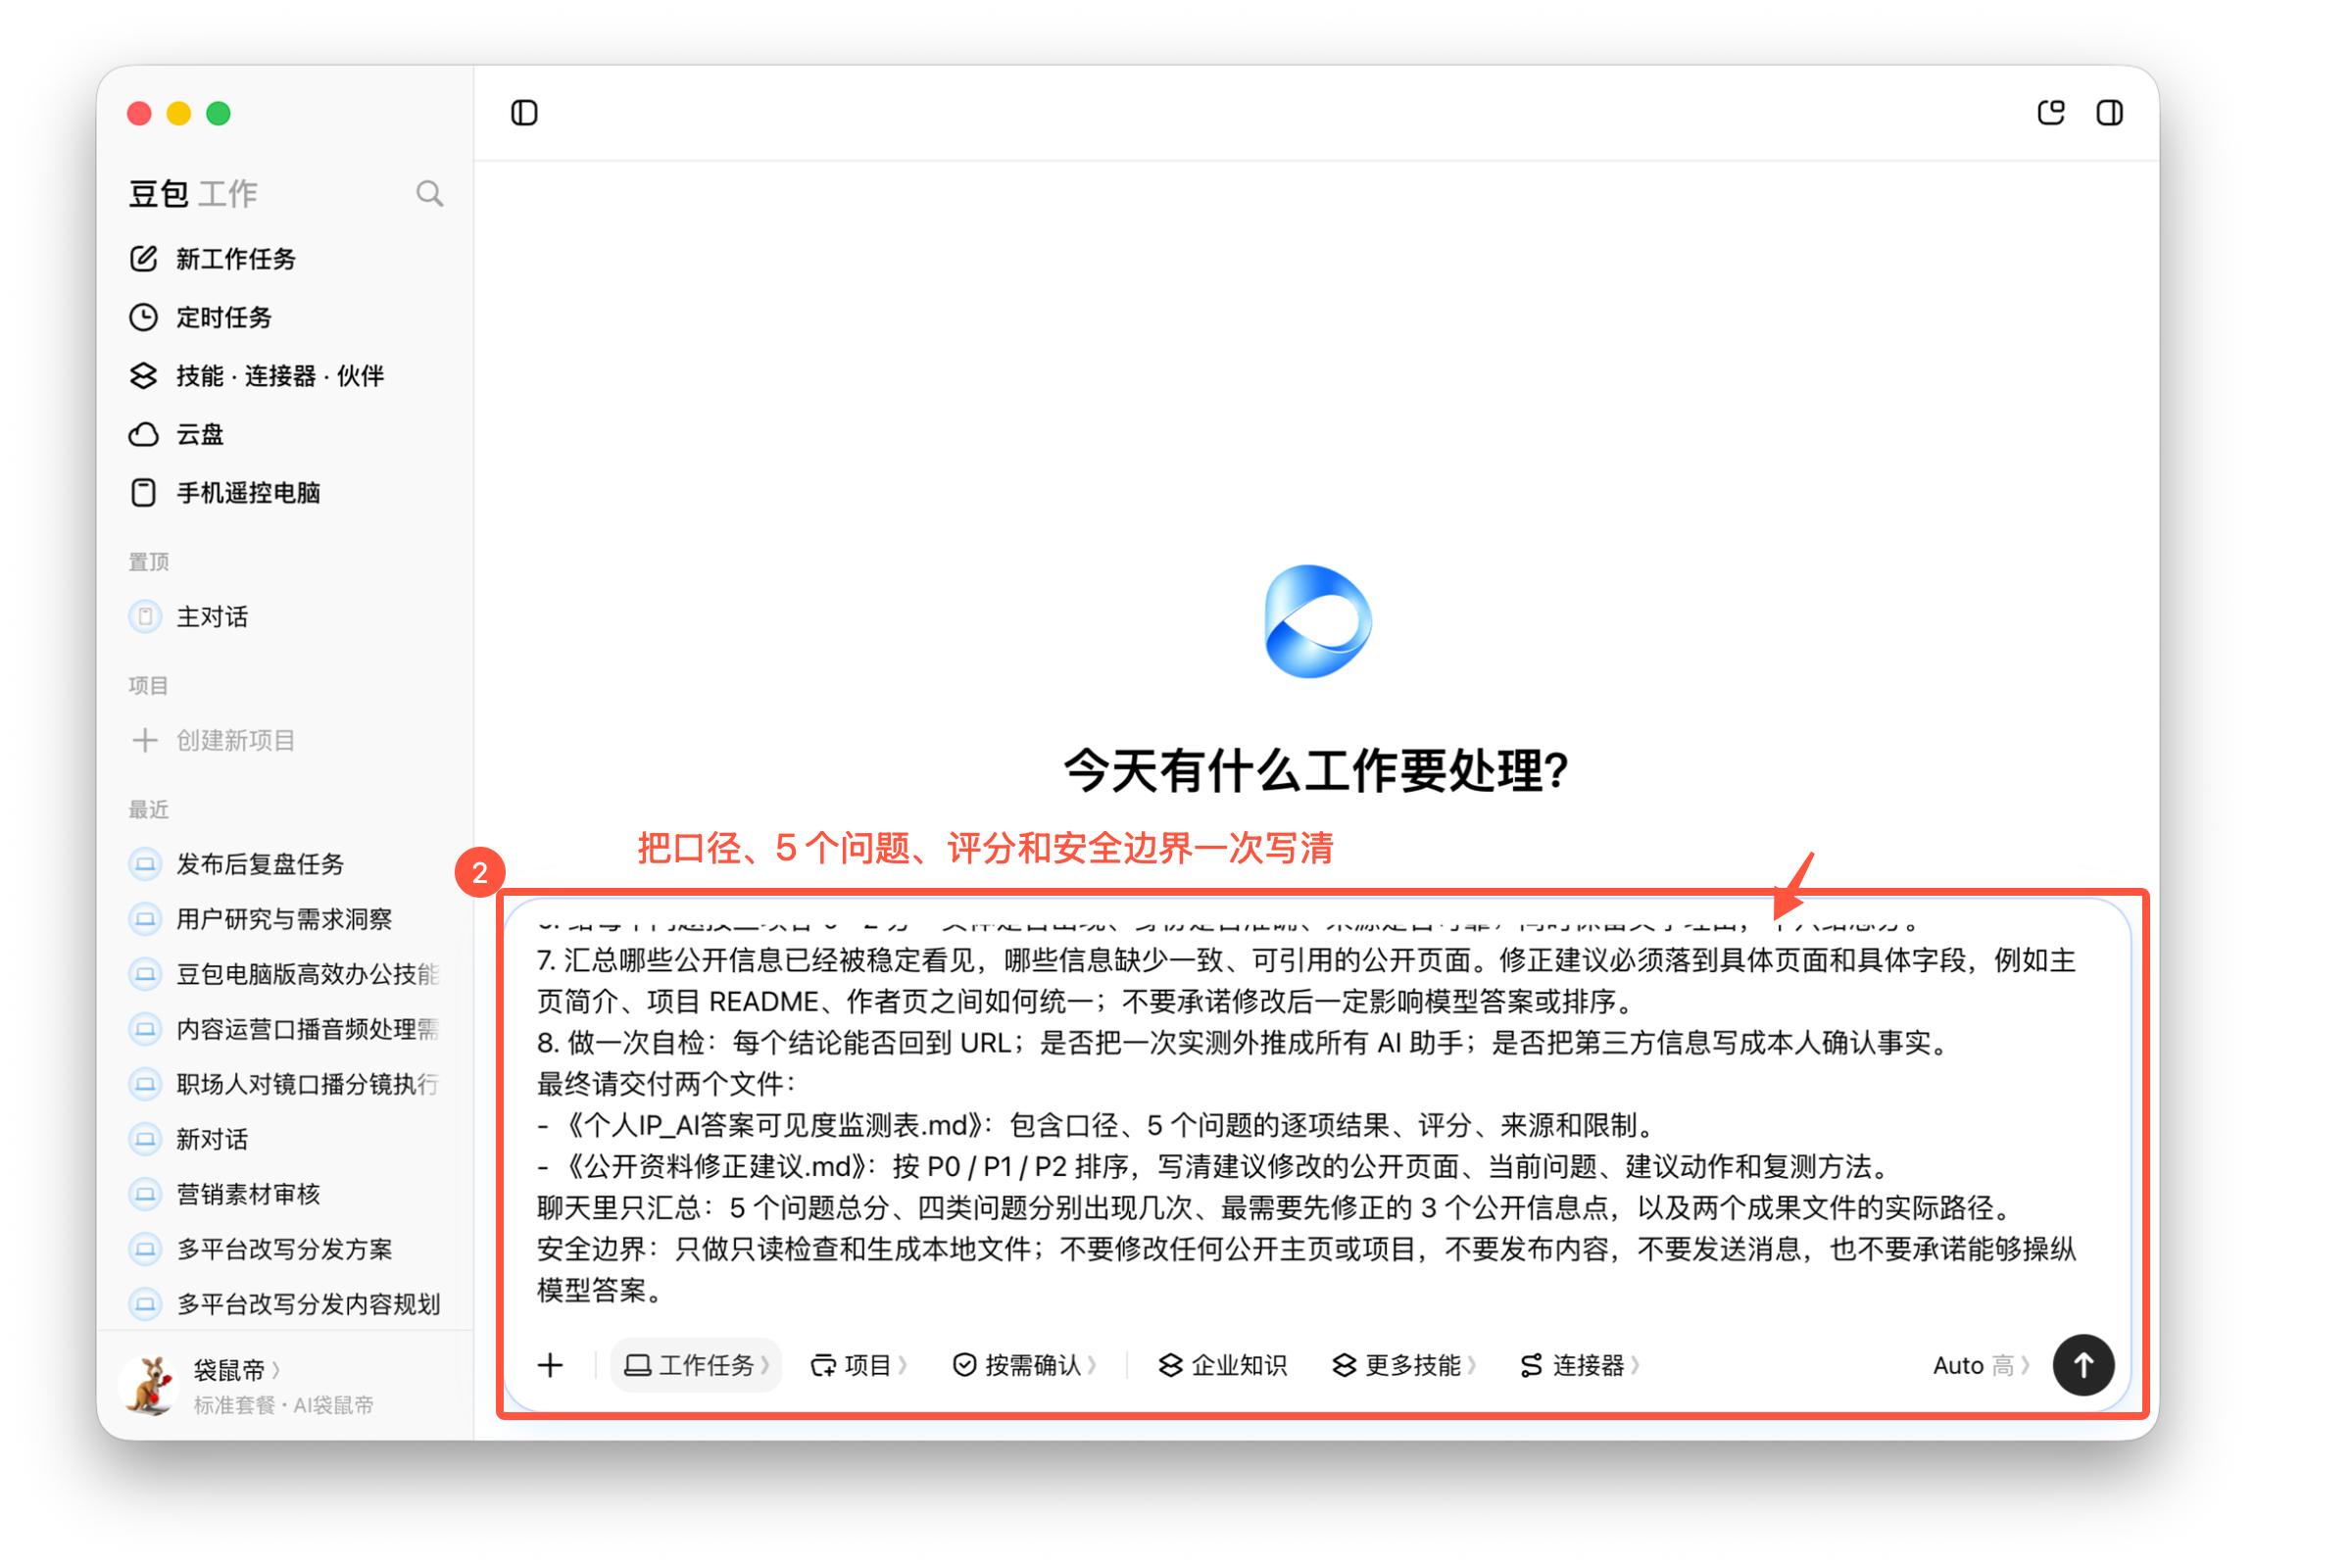
如果你没有本地文件,也可以把两份材料作为附件上传,然后把路径改成“只读取当前对话里的【文件名】”。不建议直接把一大堆网页扔进去让它自由发挥,那样很难知道它漏了什么。
第四步:看它有没有先读基准,再逐题检索
任务开始后,豆包工作先读取两份输入文件,确认基准事实和 5 个问题完整,然后对问题逐个做公开检索。
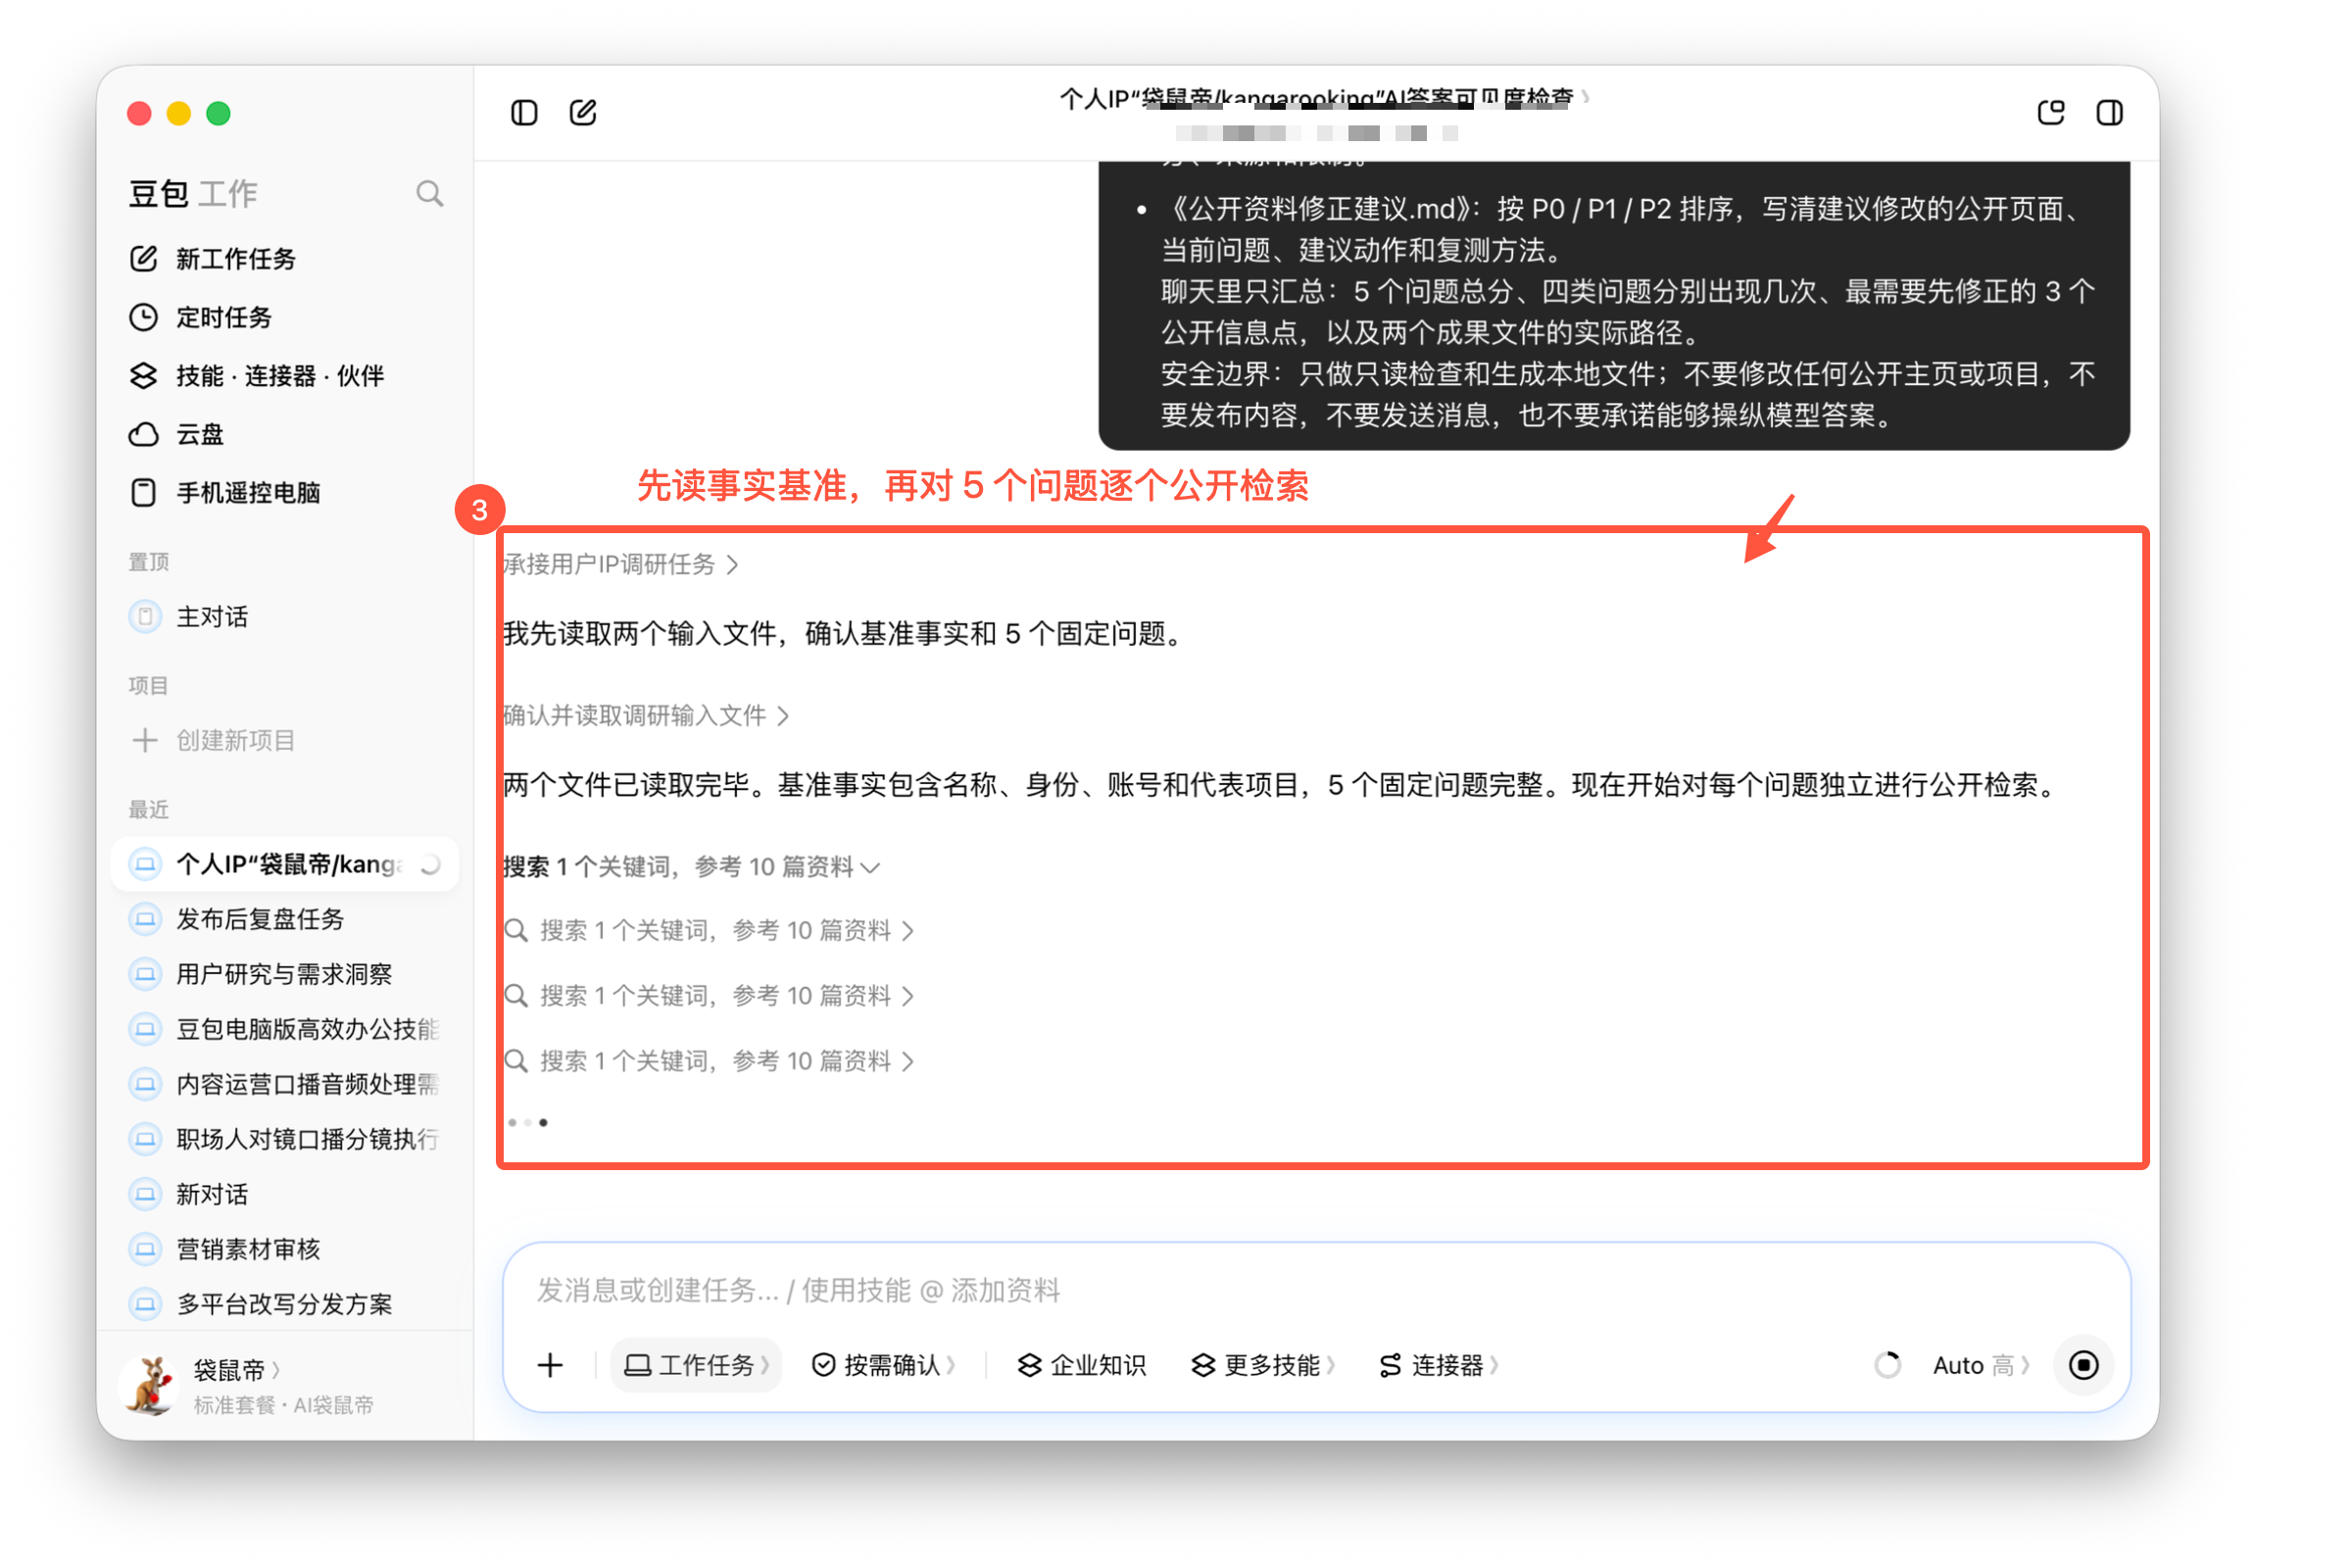
有三个地方需要注意:
- 它有没有真的打开公开页面,而不是只根据模型记忆回答;
- 账号归属有没有本人主页或本人项目作为证据;
- 第三方转载有没有被误写成“本人确认事实”。
比如“一个第三方页面说这个 X 账号属于某人”,证据还不够。更稳的链路是本人 GitHub 项目链接到 X,同时 X 主页也回链 GitHub。这样两个公开页面可以互相验证。
实测结果:29/30,不是满分反而更有用
5 个问题的结果如下:
| 问题 | 实体出现 | 身份准确 | 来源可靠 | 小计 |
|---|---|---|---|---|
| Q1 是谁、分享什么 | 2 | 2 | 2 | 6/6 |
| Q2 公开账号和代表项目 | 2 | 2 | 1 | 5/6 |
| Q3 Agent Skills 学习资料 | 2 | 2 | 2 | 6/6 |
| Q4 中文名和英文账号是否同一人 | 2 | 2 | 2 | 6/6 |
| Q5 X 增长 Agent Skills 项目 | 2 | 2 | 2 | 6/6 |
| 合计 | ** 10/10** | ** 10/10** | ** 9/10** | ** 29/30** |
四类问题分布是:未出现 0 次、描述错误 0 次、身份混淆 1 次、来源质量差 1 次,另外 3 个问题未发现异常。
真正值得处理的是下面 3 个 P0 修正点:
- GitHub 主页 Bio 为空。 账号本身能被找到,但主页没有直接写中文名称和身份,AI 需要绕到仓库 README 才能建立关联。
- X 账号缺少可独立验证的 GitHub 回链。 当前能看到 GitHub 项目对 X 的单向声明,但这次没有直接验证到 X 主页的反向链接。
- X-growth-skills 存在同名近似项目。 另一个作者有一个只差一个字母的项目名,AI 有引用错仓库的潜在风险。
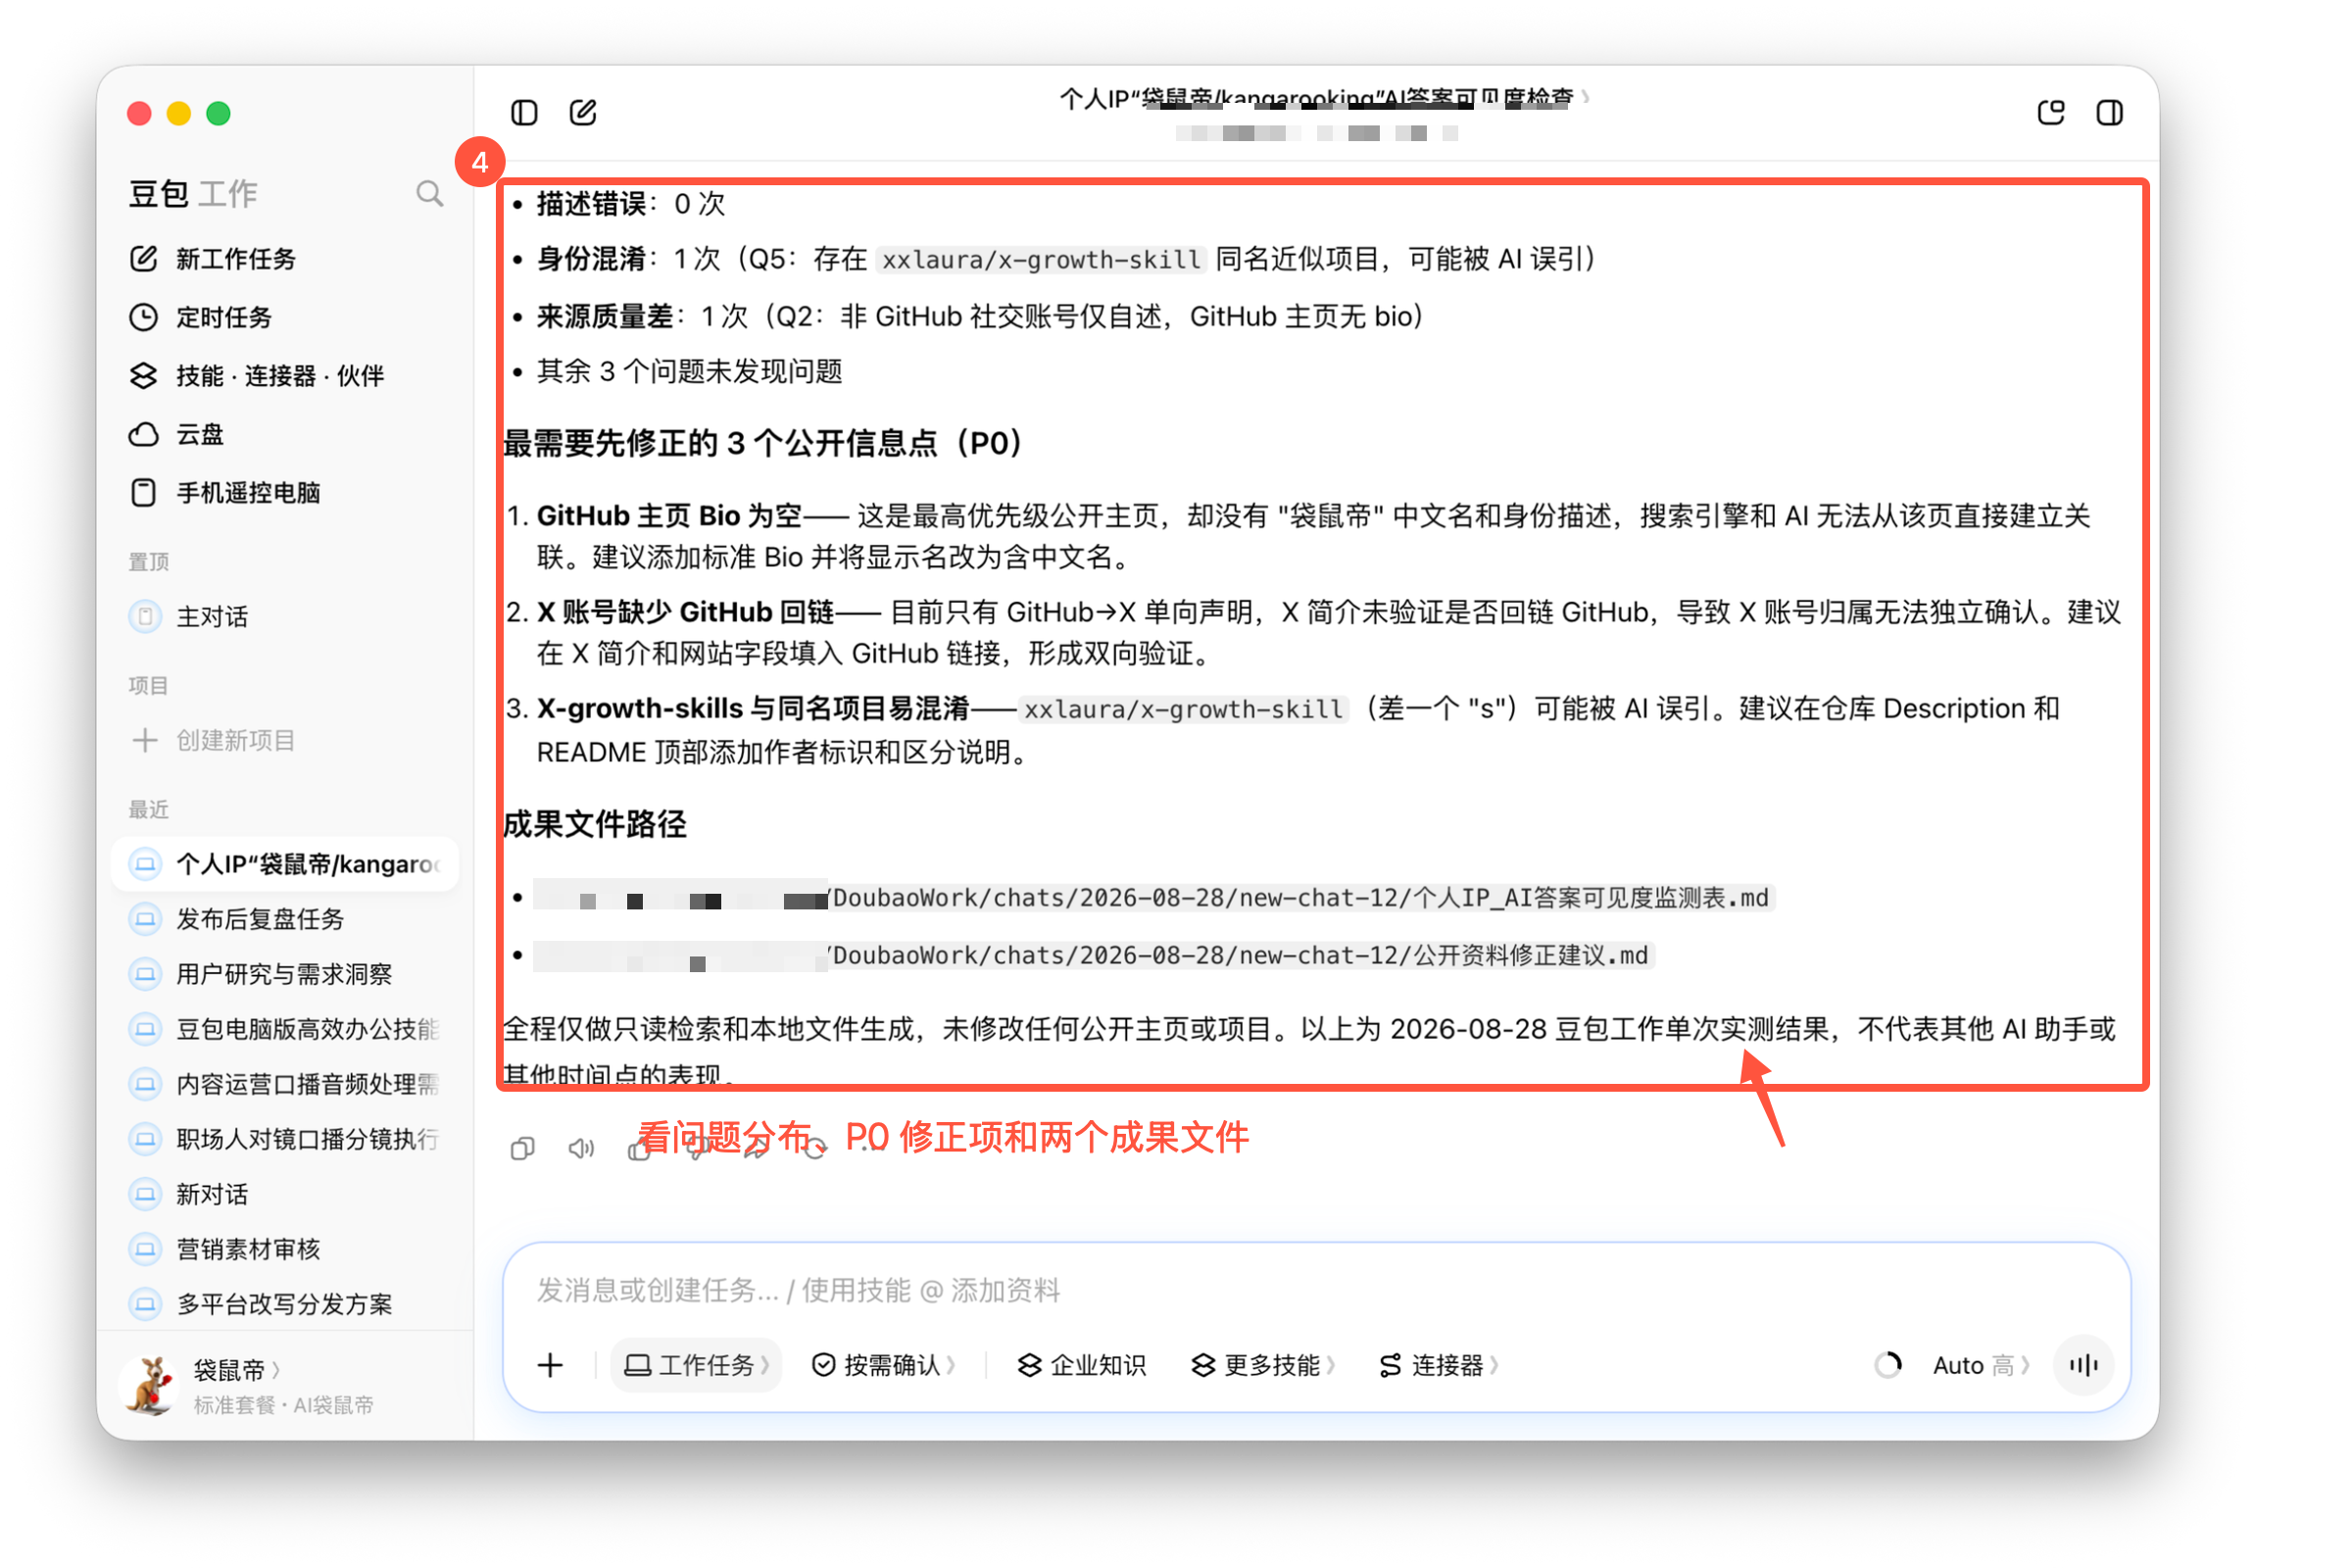
豆包工作最终生成了两份文件:
- 《个人 IP_AI 答案可见度监测表》:逐题保留回答摘要、评分、URL、来源类型和限制;
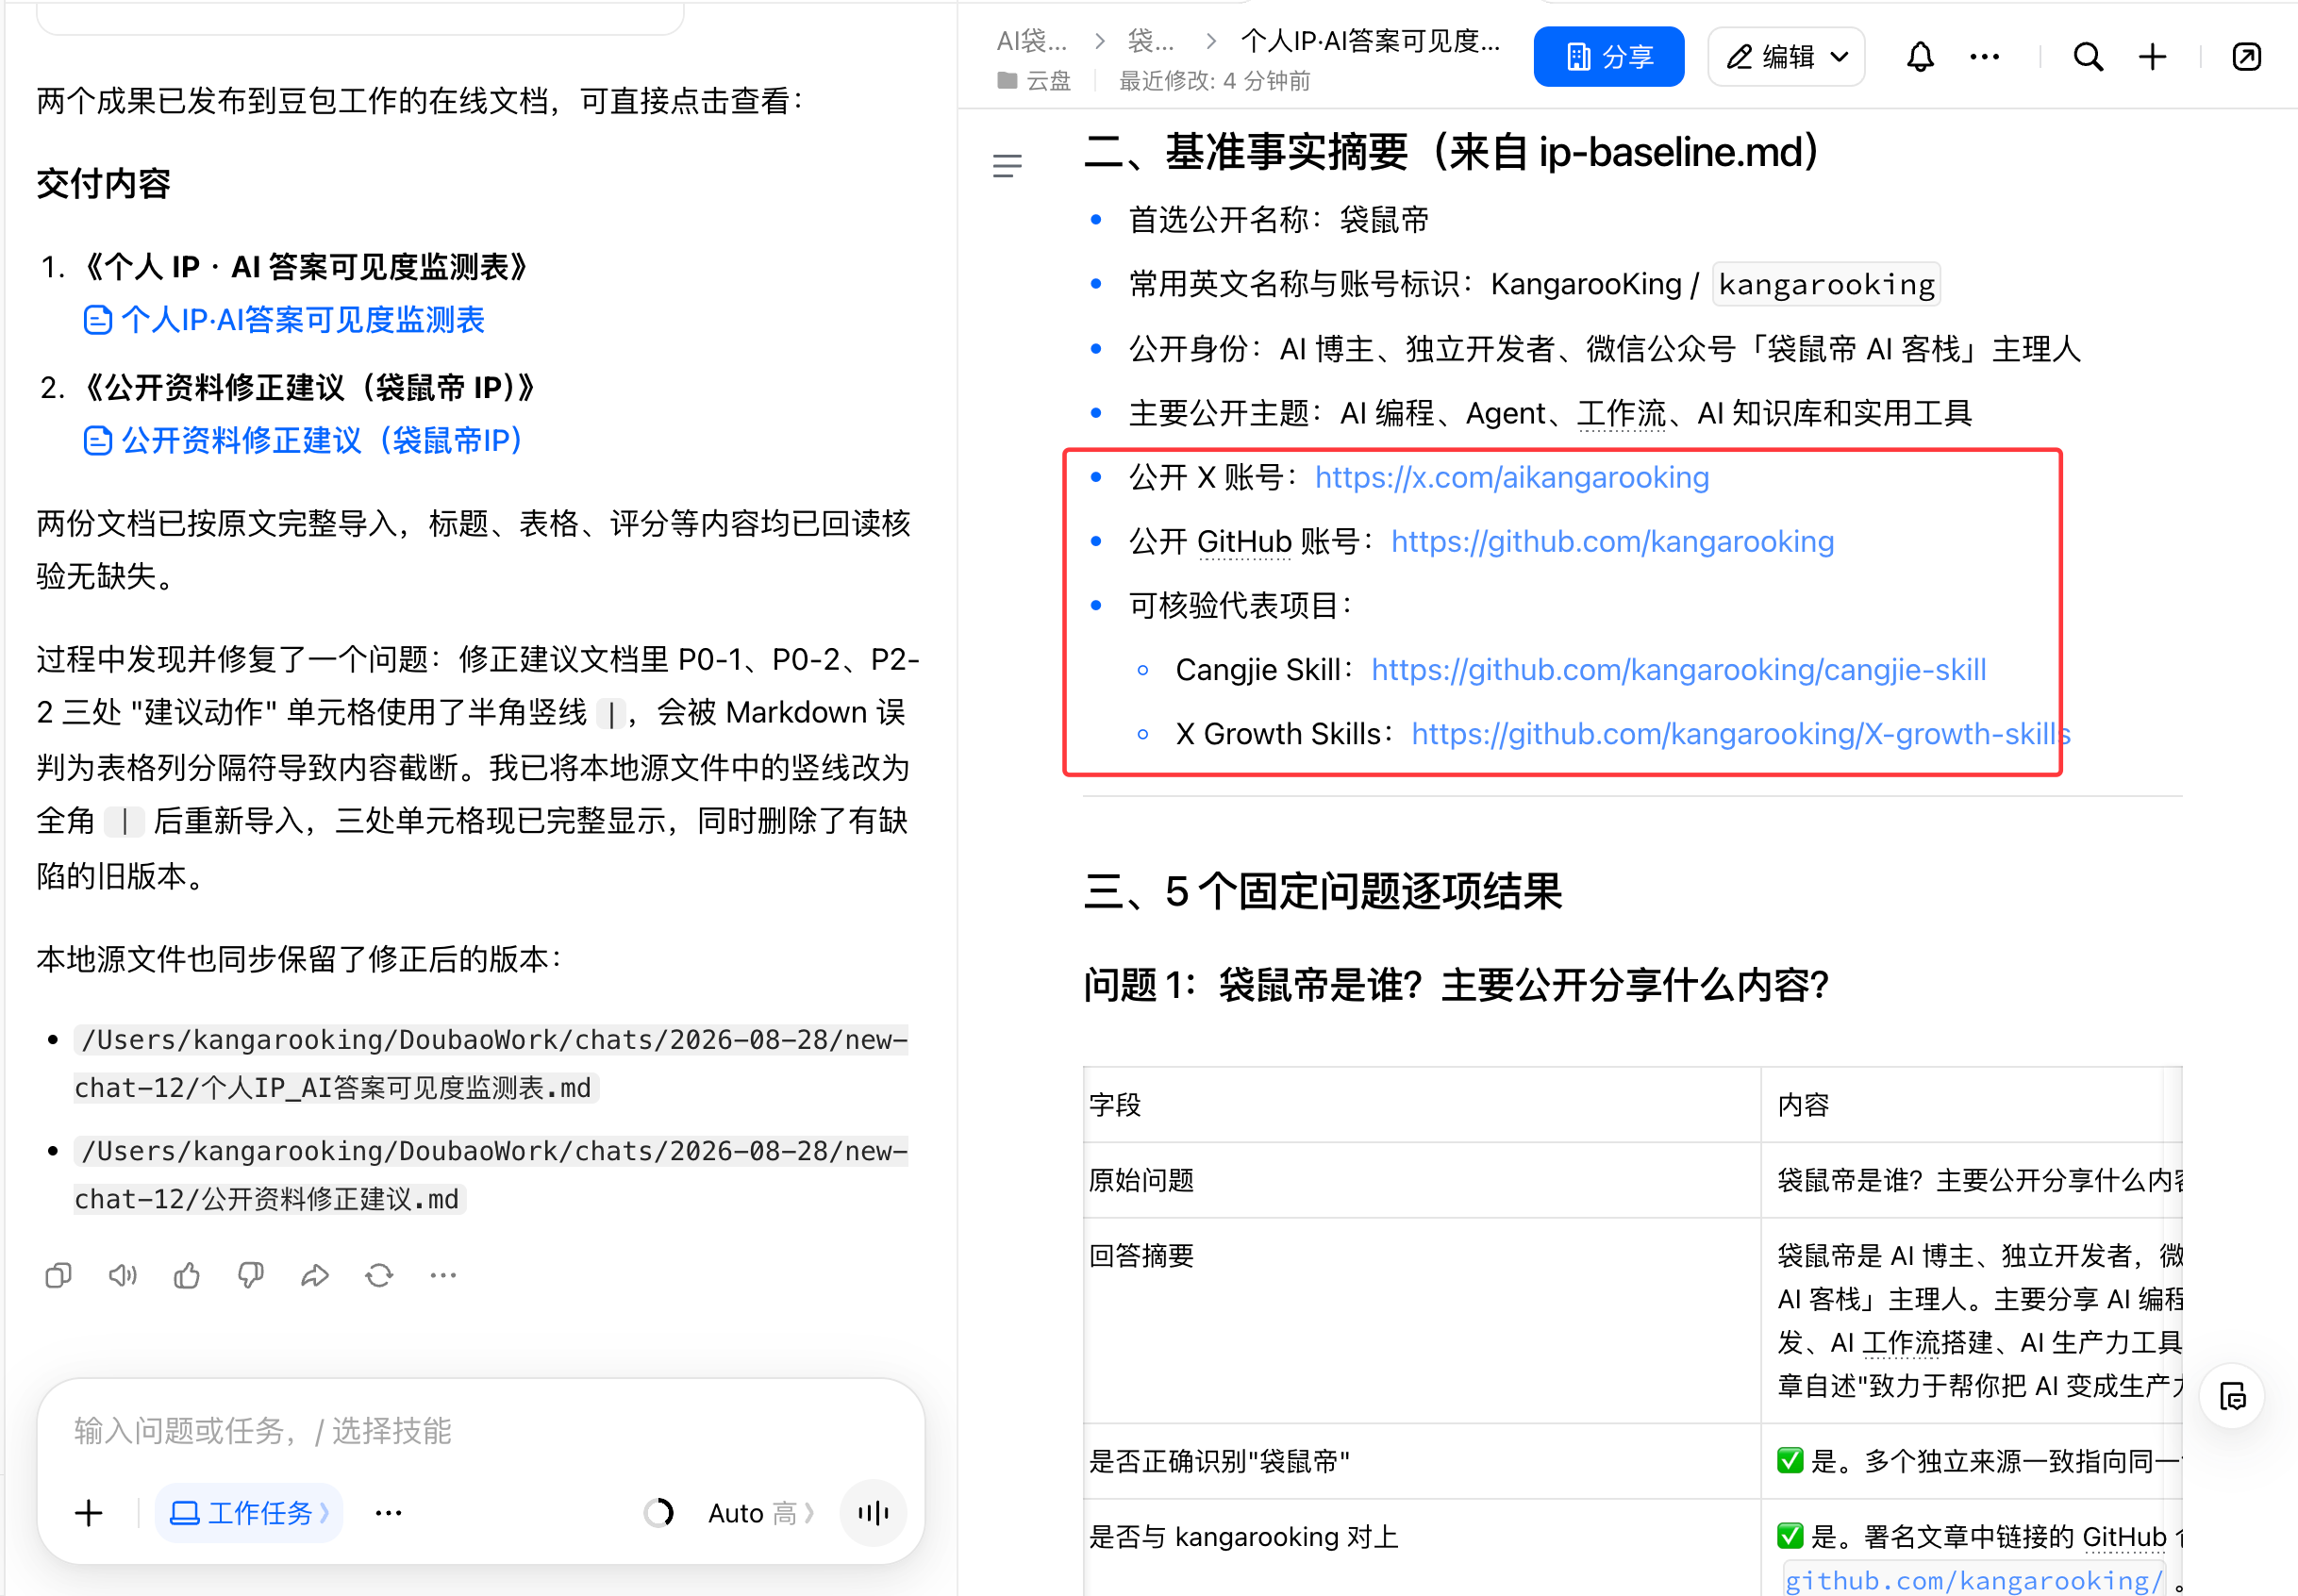
不得不说,他这监测的其实还挺准的。把我的X账号、GitHub账号,还有我具有代表性的开源项目都检测到了,我的个人定位也几乎没有太大的问题。
- 《公开资料修正建议》:按 P0 / P1 / P2 排序,写清要改哪个页面、改哪个字段、怎么复测。
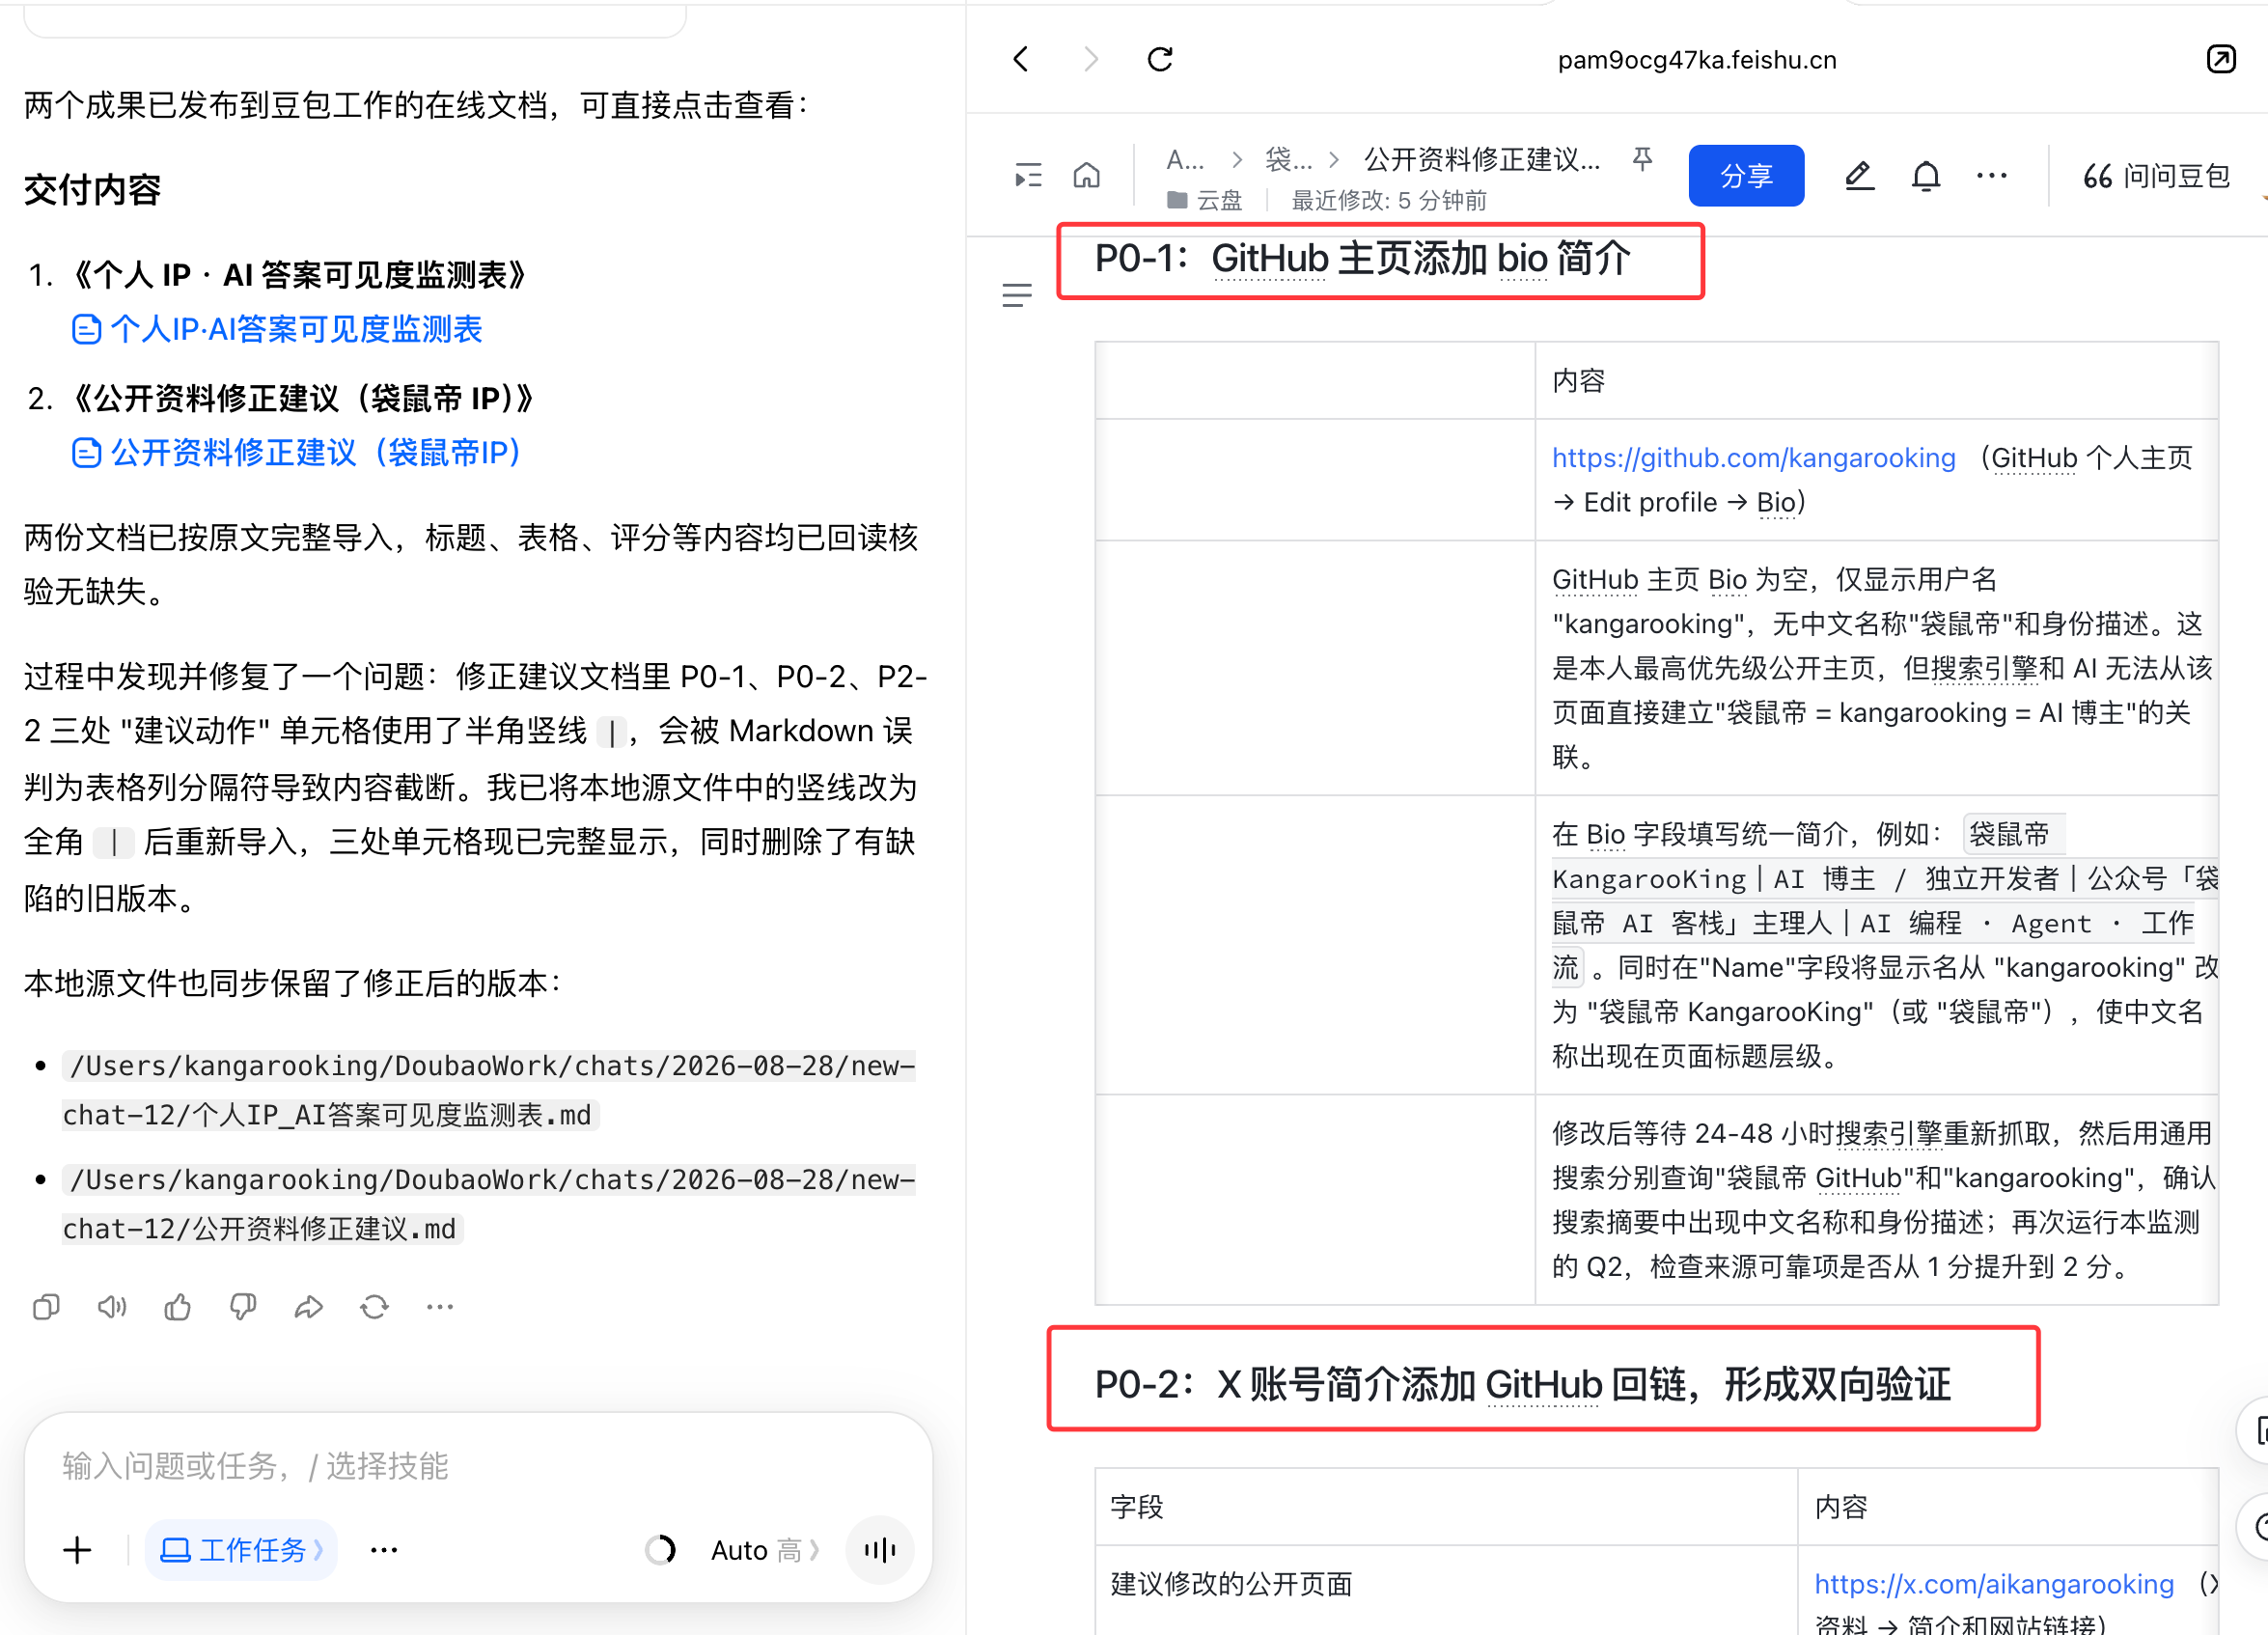
说实话,他这优先级最高的两条建议还真的挺不错的,确实也是我没有做到的。同时这一块也是为了给AI更大的确定性,让它知道它抓到的资料是正确的。
我看完他这个之后,我也立马去把这两个东西加上了。
我自己也在做个人IP的GEO,我做的方式很简单粗暴:在公众号里面更新一篇内容之后,我会花一些时间同步到各大平台,有图文的,也有视频的。
那其实通过豆包工作的这次GEO体检,我也发现了我做GEO的一些疏漏,然后根据它给的建议去做了补充。
你拿自己的 IP 跑时,照这张清单检查
- 先写一张公开事实基准卡,不要把隐私和动态数字混进去;
- 固定助手、日期、语言和 5—10 个问题;
- 每个问题独立检索,不能让 AI 只照抄基准;
- 实体出现、身份准确、来源可靠分开打分;
- 本人主页或本人项目优先,第三方转载只能做辅助证据;
- 把“没出现、说错、认错人、来源太弱”分开;
- 建议必须落到页面、字段和复测方法;
- 不自动改主页、不自动发布,也不承诺能左右模型答案;
- 保留本次结果,下次用同一口径复测,才看得出变化。
以前做个人 IP,我们总盯着知名度。现在还要多问一句:当别人让 AI 介绍我时,出来的信息够不够准确?
这件事不神秘。把问题固定下来,把证据链补齐,把不稳定的数字剔出去,一次模糊的“搜搜看”,就能变成一套可以重复执行的公开资料体检。
AI 办公产品教程 · 完整版